Idea2Paper · AI 科研智能体
从想法到论文的全流程 auto research,内置 10 万+ 顶会论文向量知识库和多智能体评审,解决「想法好、写不出、投不中」的科研痛点。
- Hugging Face Daily Paper 日榜第 1
- GitHub 1.4k Star,1,000+ 内测用户、200+ 付费用户
- Agent 自动迭代出 1,800+ 篇论文,正推进约 300 万天使轮合作
国内顶尖大模型 Agent 实战社区
不空谈理论、不追热点。以「技术落地、人才培养、商业共创」为核心,培养能解决真实问题、能落地、能产出的 AI 人才。

真带 · 真教 · 真落地
每个项目都在真实运行,可以顺手点开看。
从想法到论文的全流程 auto research,内置 10 万+ 顶会论文向量知识库和多智能体评审,解决「想法好、写不出、投不中」的科研痛点。
10 个协作 Agent 的工程化写作管线:世界观搭建、情节编排、伏笔追踪、33 维连续性审计与自动修订,内置反 AIGC 检测。
社区成员真实创业项目,从 0 到 1 全程有人带:一键成片、智能脚本、素材生成、合规优化全流程。
企业定制电商项目:选品判断、竞品雷达、Listing 转化、货源与利润、风险门禁,把跨境增长变成可迭代的经营系统。
把专业数据与主流模型接入 AI Agent:13 个专业数据库,覆盖研报、投融事件、高考真题、社交搜索等场景。
社区论文成果
自动科研管线:把研究概念自动转化为完整科学叙事,用预构建的方法论知识图谱替代运行时海量文献推理。
An Automated Pipeline for Transforming Research Concepts into Complete Scientific Narratives
arXiv:2601.20833 · 阅读论文 ↗契约治理的多智能体写作框架:把研究故事转化为结构化论文手稿,评审得分优于直接生成基线。
A Scaffold for Structured Scientific Paper Writing
arXiv:2603.27065 · Hugging Face Daily Papers · 阅读论文 ↗元递归自改进系统:让改进「改进器本身」的流程,在可机器验证的环节上自动迭代。
A Meta-Recursive Self-Improving System
arXiv:2609.06396 · 阅读论文 ↗面试题库 · 免费开放
速答题一题一页,附面试官追问链和错误答法提醒;深度解析讲机制与工程取舍;模拟自测随机抽题。
577 道速答题 · 2494 篇深度解析 · 15 个分类
免费求职工具箱 · 10 个在线工具
全部免费、无需注册、浏览器本地运行:在线简历制作与导出 PDF、招聘 JD 分析、模拟面试、 投递管理与 Offer 对比。面向 AI Agent 与大模型岗位求职者,数据不出你的浏览器。
我们的方法
导师与社区成员
10+ 篇 Agent、RL 方向顶会论文和 SOTA 开源项目,多段大厂跳槽涨薪 80% 经历
多次斩获 CVPR、ECCV 等顶会 Workshop Challenge 全球冠军,12 篇顶会
NeurIPS(含 Spotlight)、ICML、COLM、ACL、ICLR 等 80+ 篇论文,NeurIPS 2024 Top Reviewer
2025 年面试超 80 场,国内 LLM 大厂通过率 100%,拿到多个大厂顶尖人才计划 offer
社群里还有字节 Seed、Meta、Google、Apple、阿里 P7 等在职成员。
真实结果与学员案例
分享、圆桌和论文精读

大模型已经成为许多人学习和工作中的帮手。但你有没有想过:它答错一道数学题,和给出一条错误的用药建议,能算同一种错误吗? 如果大模型答错一道数学练习题,你可能只需要重新计算;给错一次出行建议,你可能会错过一趟火车;但如果它给出错误的用药建议,甚至可能会危及生命。这三个错误产生的现实后果显然不同。但在准

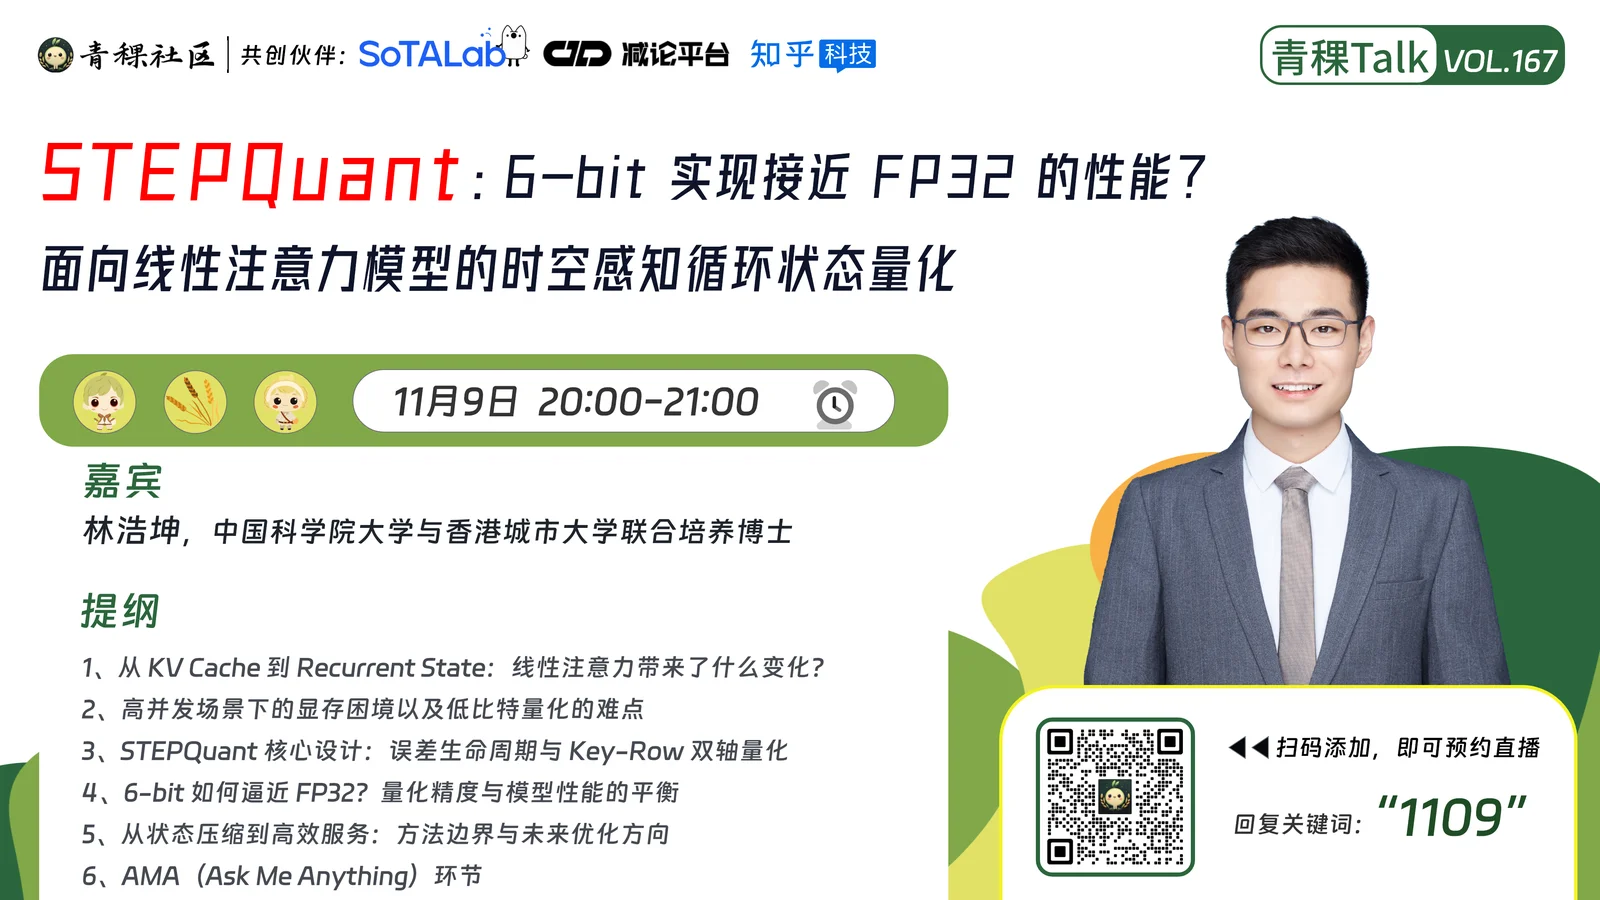
上下文越长,KV Cache 越大,这是推理服务里最熟的一笔账。 线性注意力换了个算法:把 KV Cache 换成固定大小的循环状态(Recurrent State),序列再长,状态也不涨。Qwen3.8-27B、Kimi-Linear-48B-A3B-Instruct 这类混合模型,就是用 gat

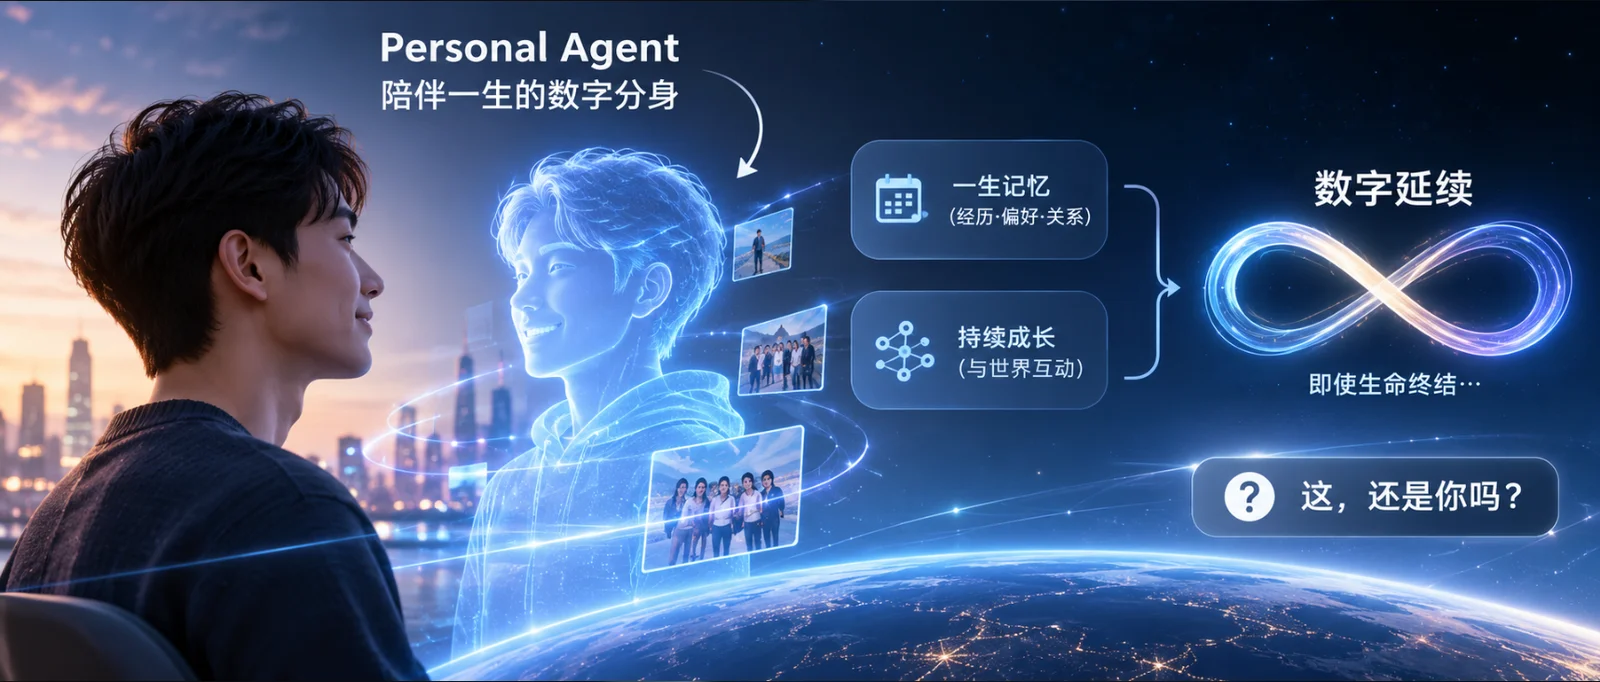
Personal Agent,可能是人类实现「永生」的版本答案 一个有点可怕的想法:也许未来人类的死亡,不再意味着一个人的彻底消失。 最近在做 DeepMate,一个围绕人与 Personal Agent 的记忆、身份和社交关系构建的 AI 产品。 在思考 Agent 的长期记忆机制时,突然意识到一

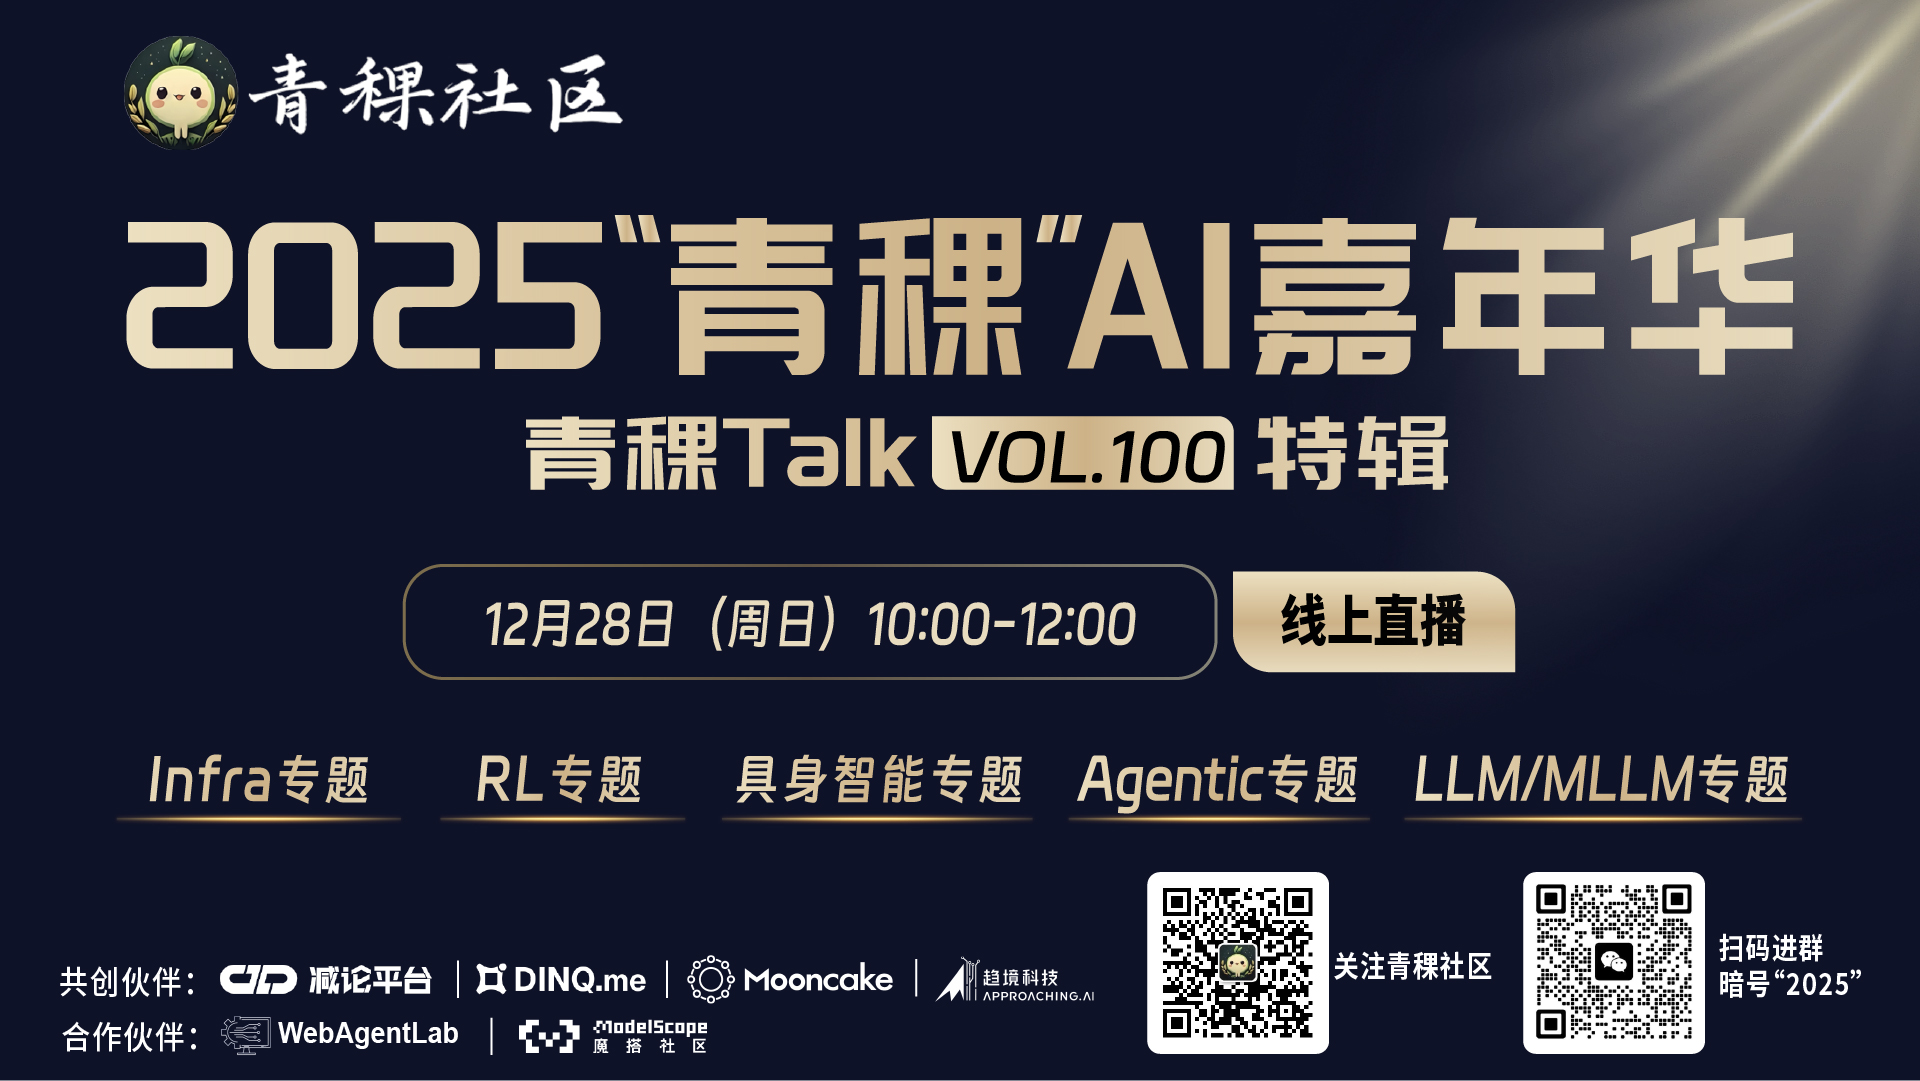
本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!

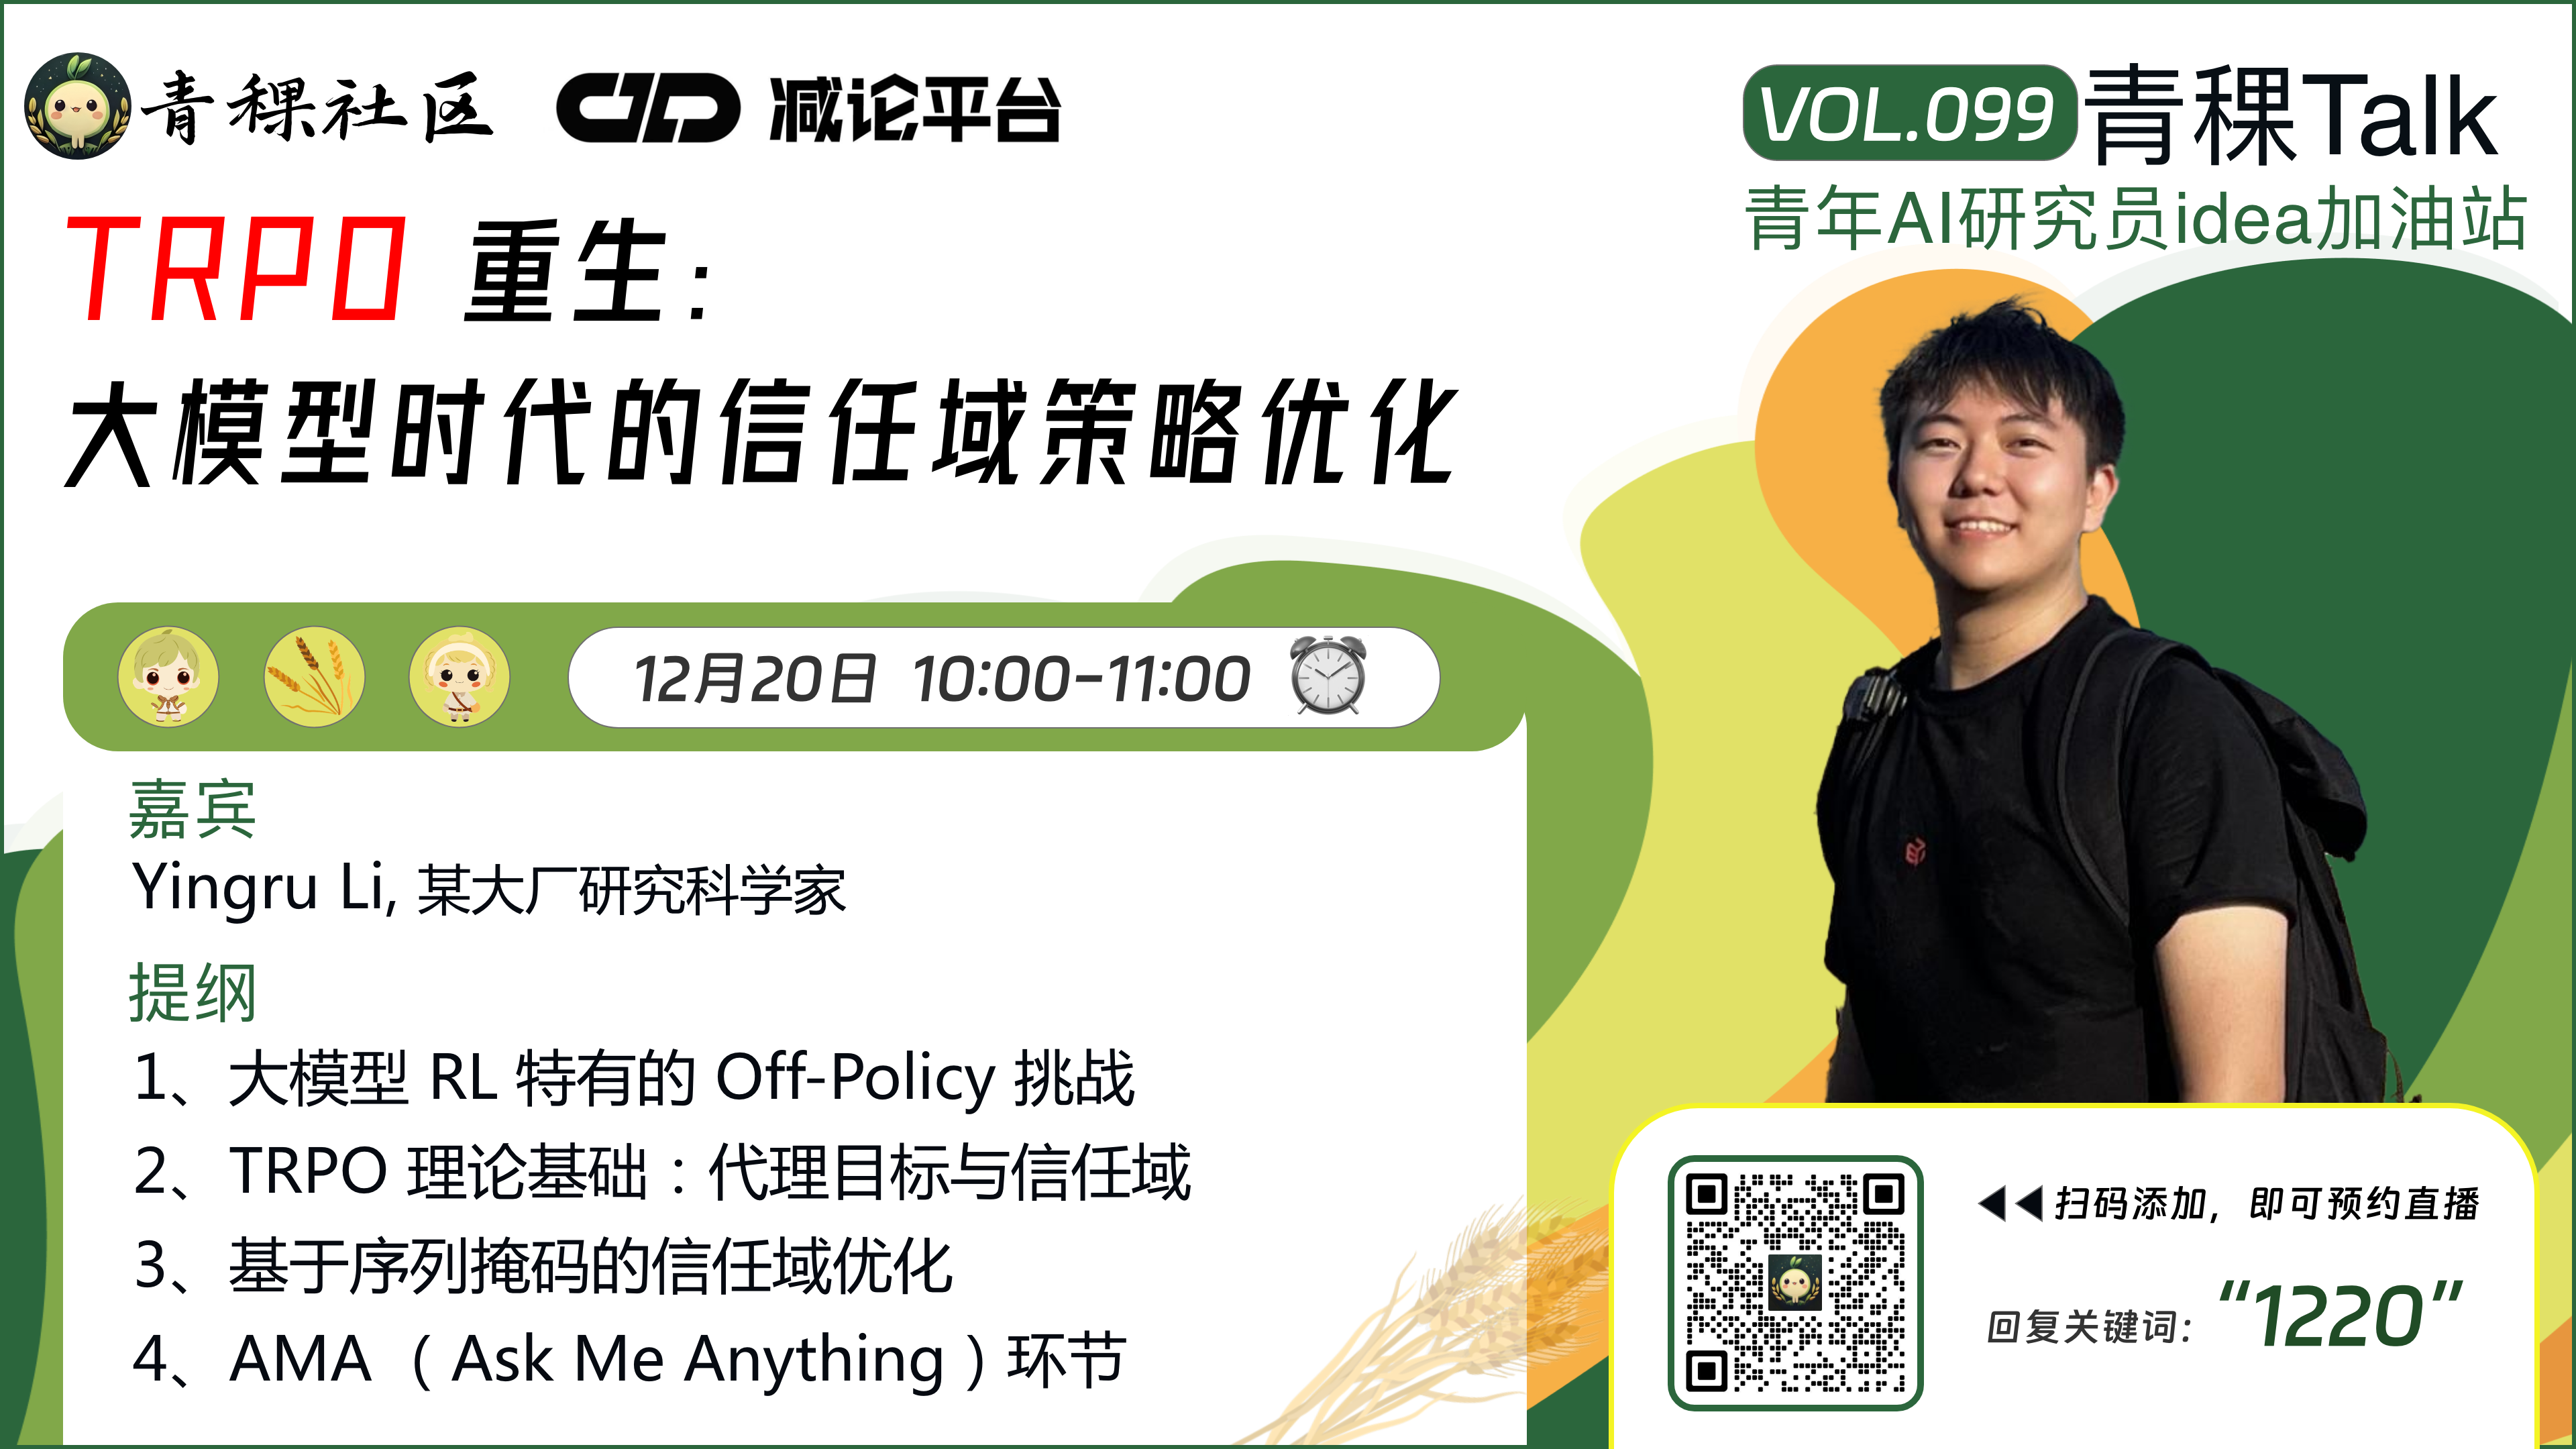
在大型语言模型的强化学习阶段,特别是RLHF中,我们追求策略的持续优化。本次分享深入探讨TRPO在LLM时代的应用。

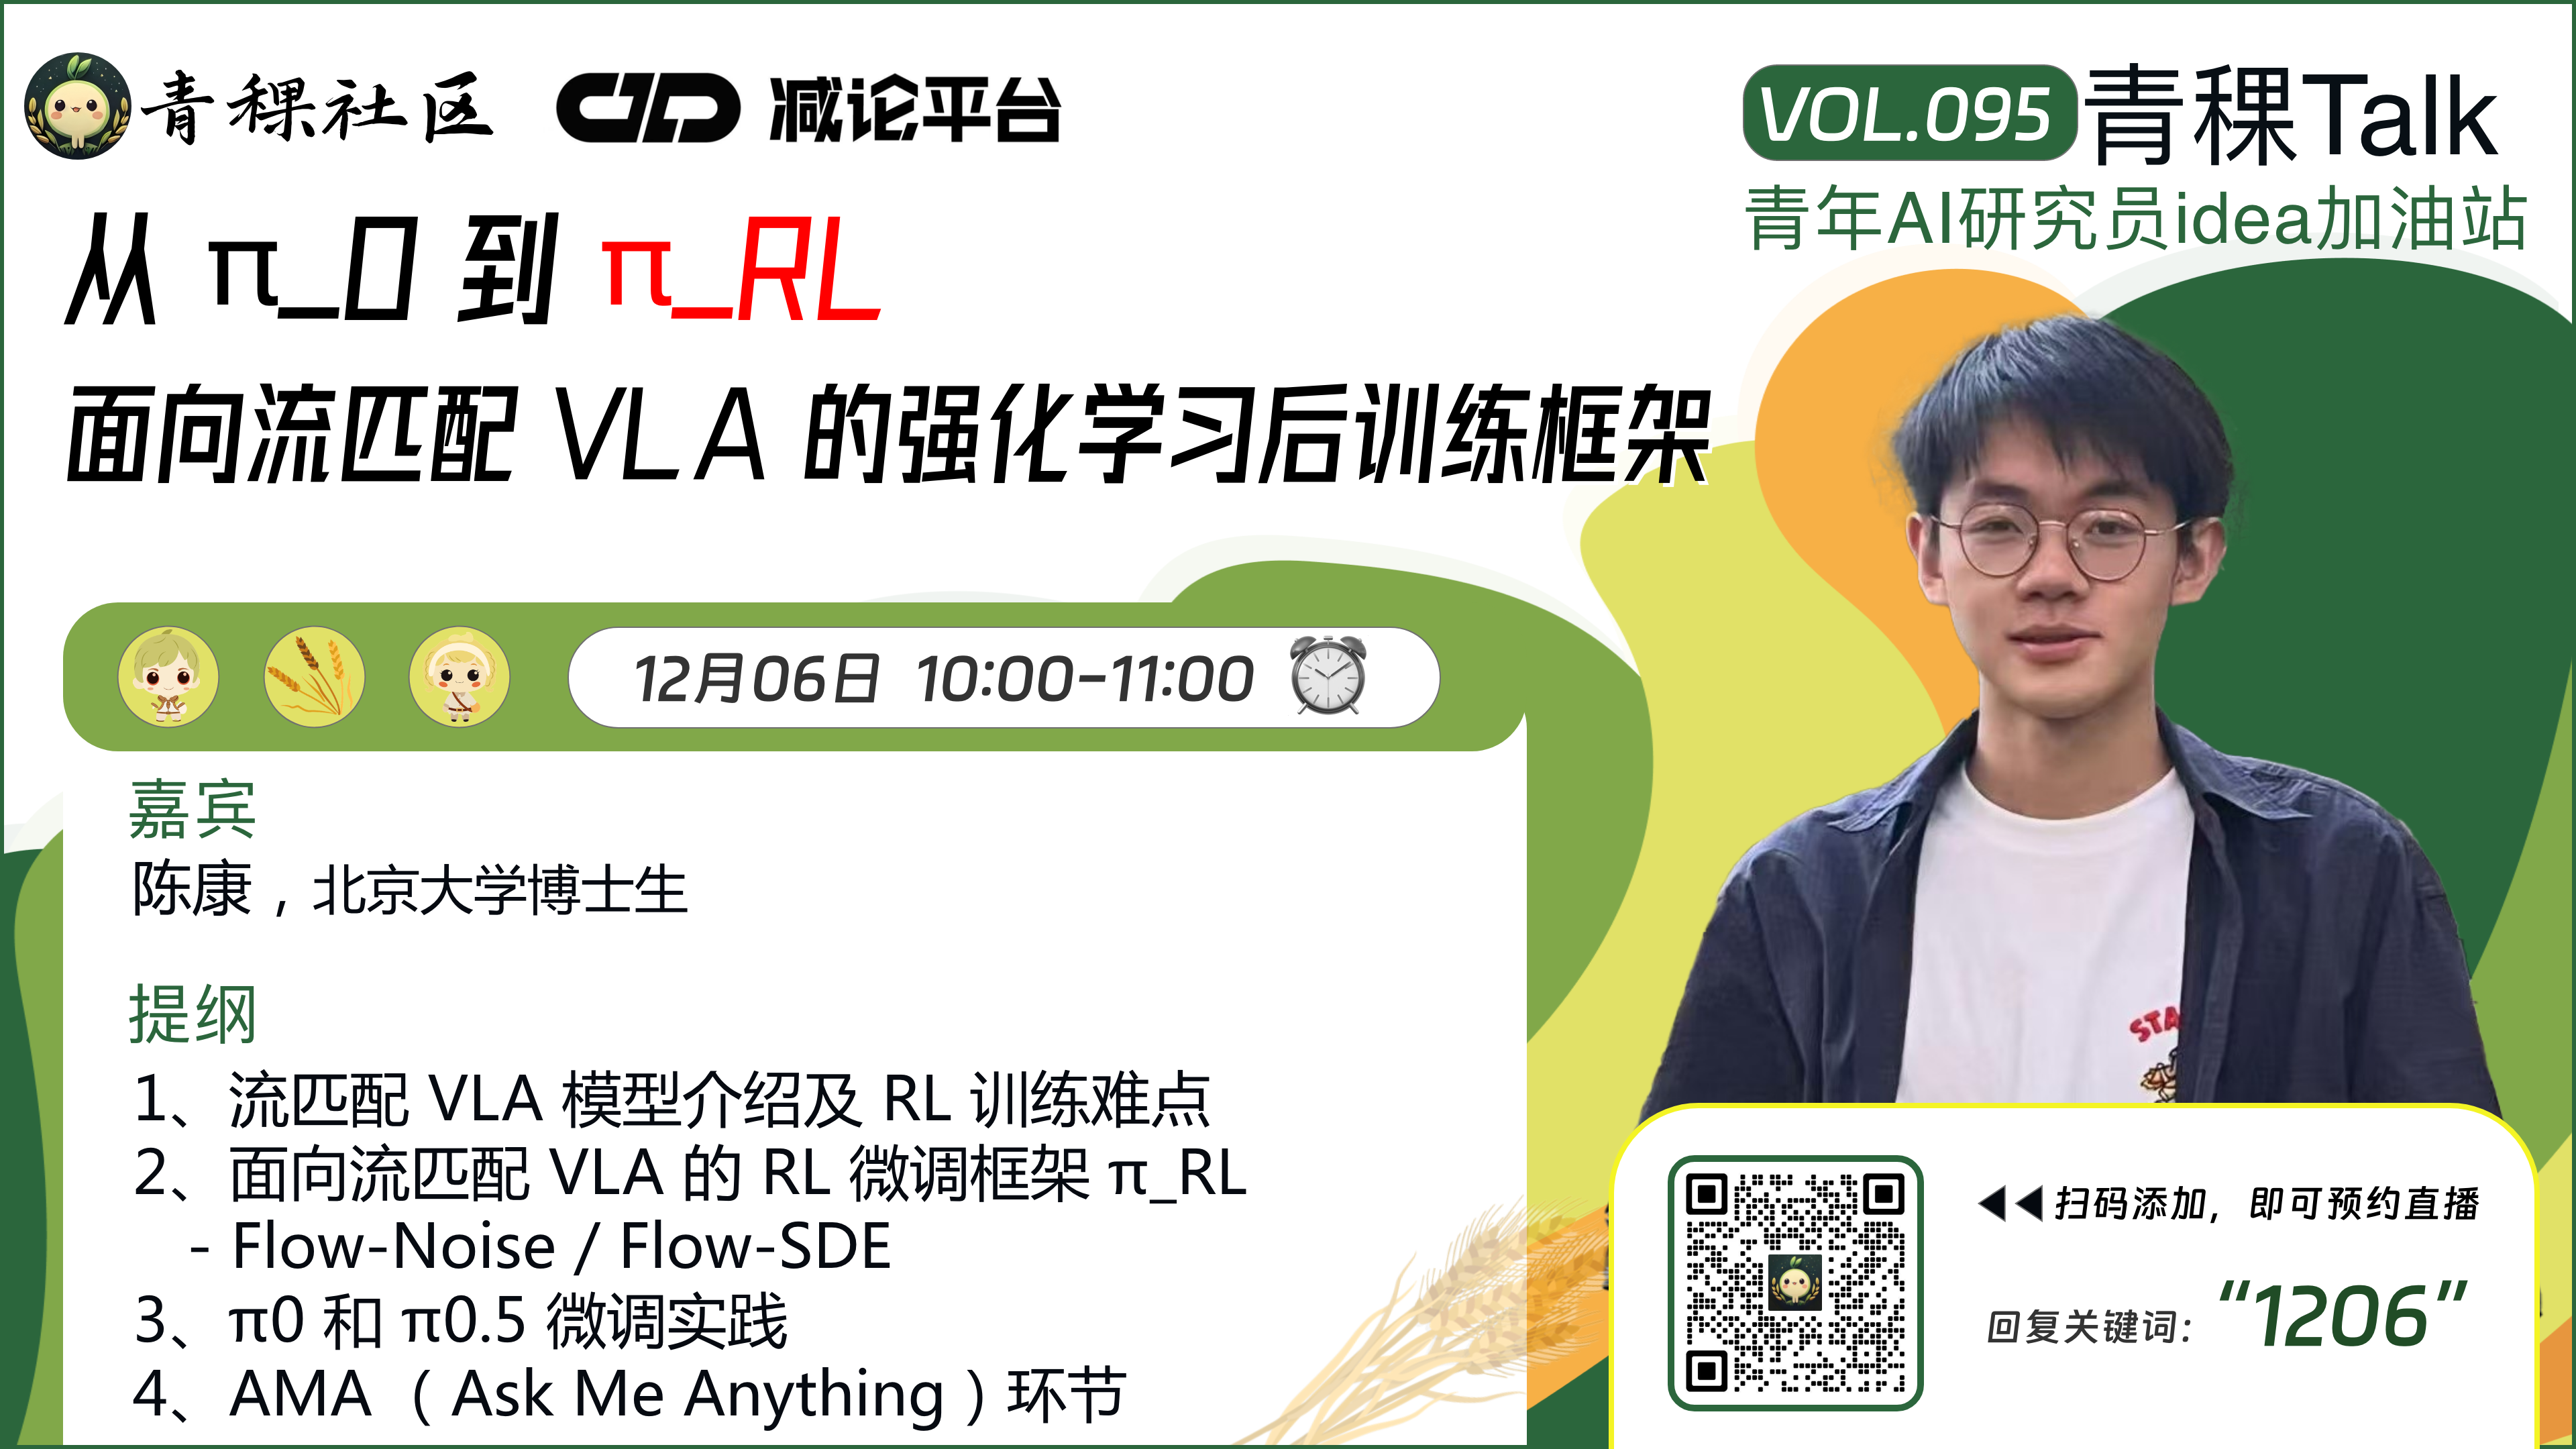
深入解析流匹配VLA的强化学习后训练框架π_RL,探索具身智能的前沿技术。

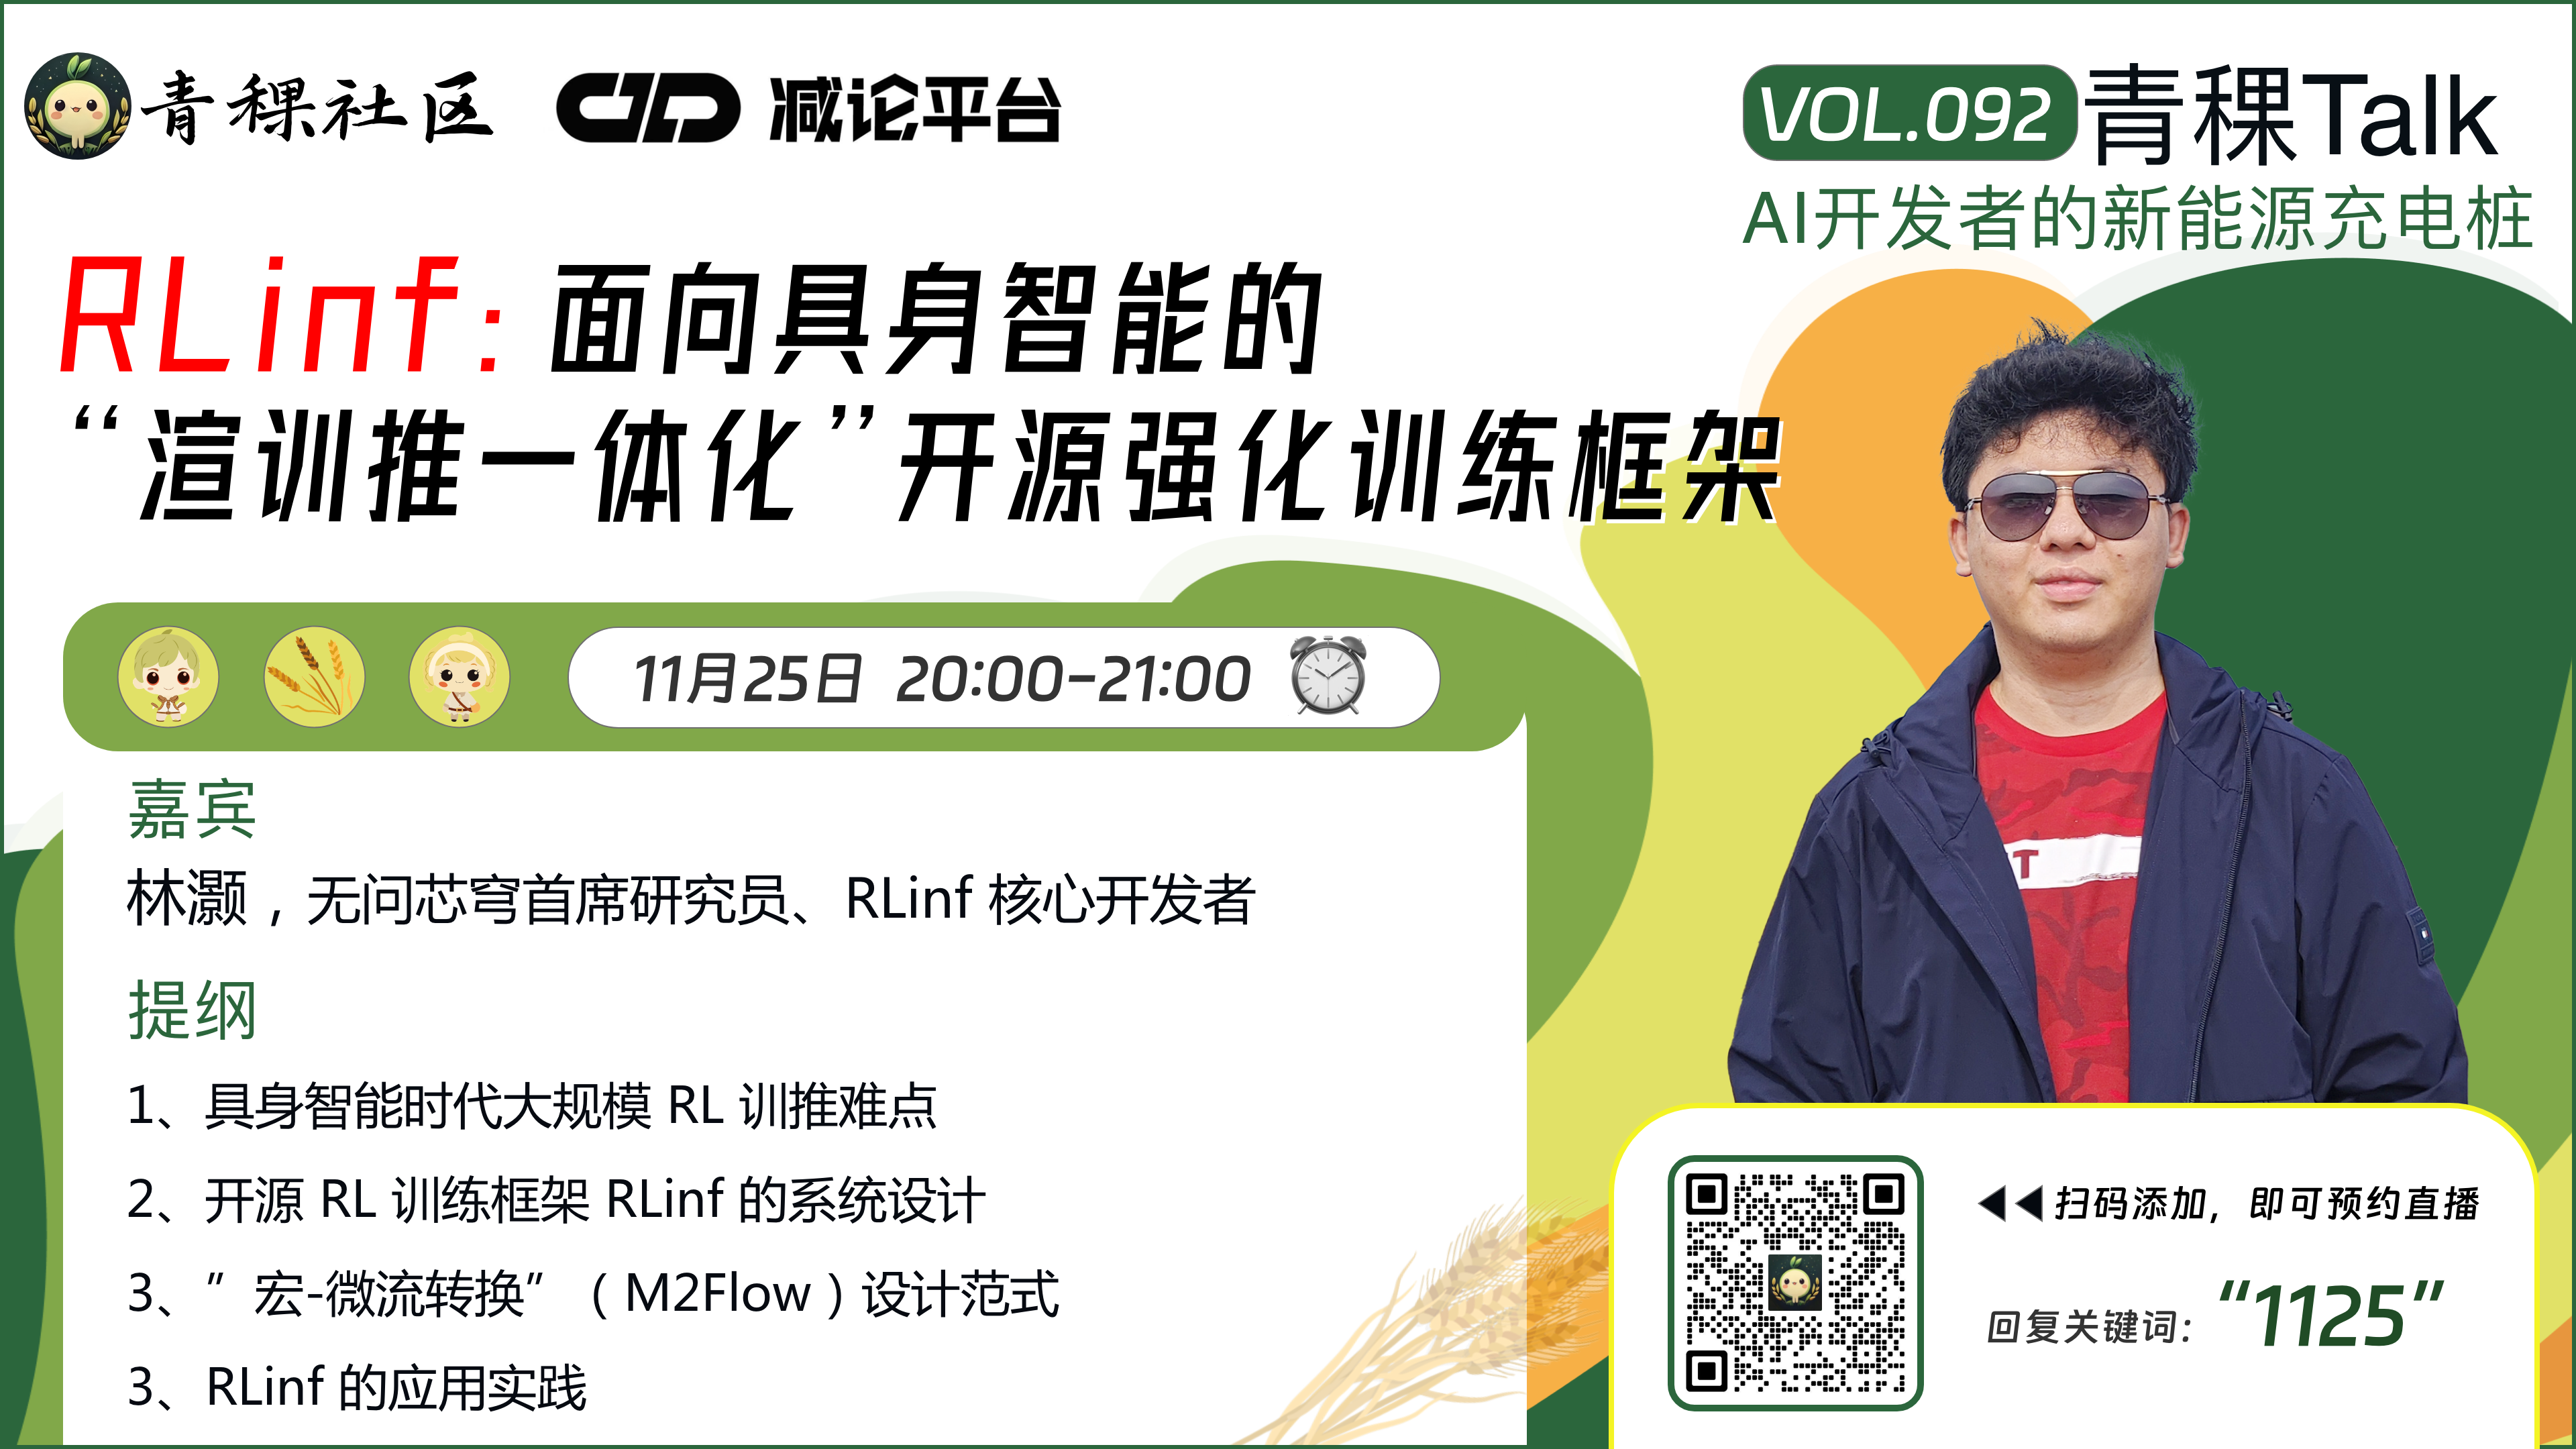
开源强化训练框架RLinf,实现渲染、训练、推理一体化,加速具身智能研发。

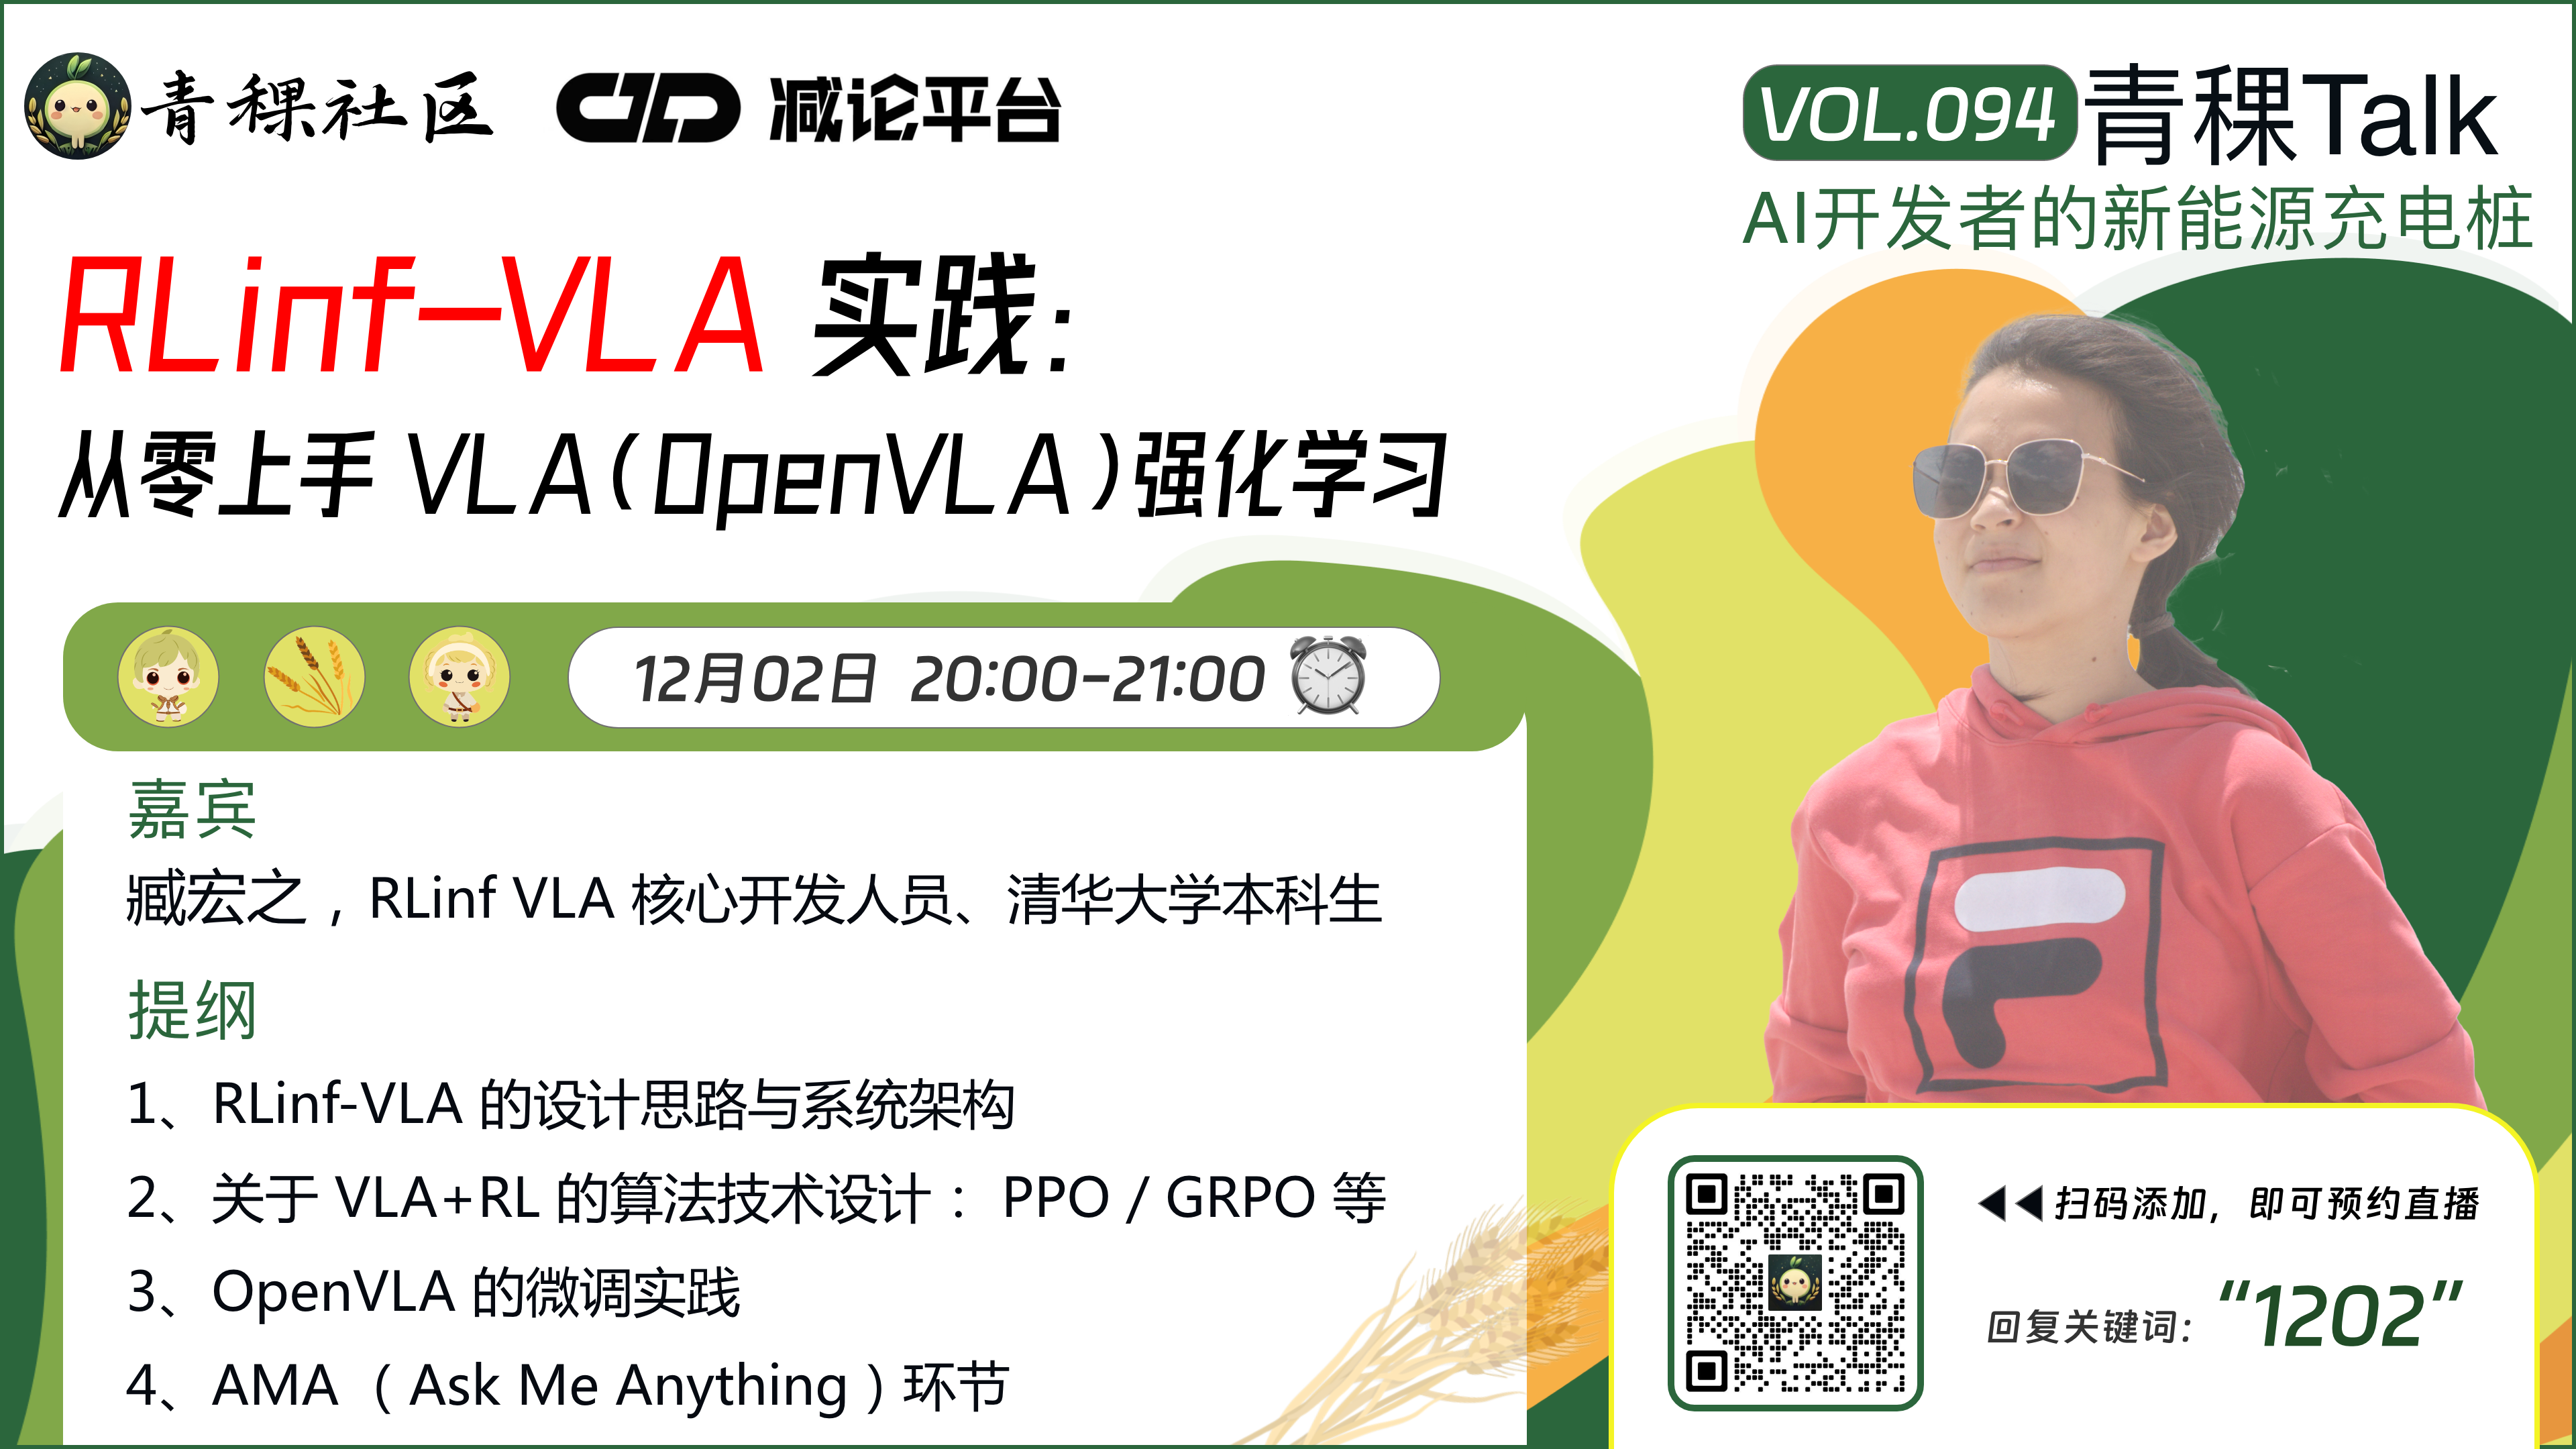
手把手教你使用RLinf-VLA框架进行OpenVLA强化学习实践,入门具身智能开发。

本次活动专为青年科学家打造,旨在搭建一场 AI 技术的深度对话,来自学术和工业界的 20+ 青年科学家,将与大家一起回顾 2025,展望 2026!

在大型语言模型的强化学习阶段,特别是RLHF中,我们追求策略的持续优化。本次分享深入探讨TRPO在LLM时代的应用。

深入解析流匹配VLA的强化学习后训练框架π_RL,探索具身智能的前沿技术。

开源强化训练框架RLinf,实现渲染、训练、推理一体化,加速具身智能研发。

手把手教你使用RLinf-VLA框架进行OpenVLA强化学习实践,入门具身智能开发。
课程体系 · 产学研结合
从 Python 到 Agent 入门,把动手前要补的基础一次补齐
入门级、论文级、Offer 级三层深度分级,按自己的目标选层进入
十个阶段:RAG、Memory、Single/Multi Agent、Deep-Research、Coding Agent、自进化 Agent、Agentic RL
以真实项目练人:每周有产出,从个人项目做到团队协作
联系与合作
想聊课程,或者手头的项目卡住了?扫码关注公众号,说下你在做什么。
微信扫码添加微信,加入社群
小红书关注我们的小红书账号
抖音关注我们的抖音账号