AgentAlpha 面试题库 · 字节篇 Memory 部分的第一题是这么问的:「解释一下 Agent 的记忆机制,为什么主流 Agent 要淘汰传统 RAG?」
很多人顺着题目往下答,开始论证 RAG 的种种局限。这恰恰掉进了题目设置的沟里——RAG 和 Memory 不是替代关系,把 Memory 理解成「更好的 RAG」,后面的设计一定跑偏。
这题的正确打开方式,是先指出前提有问题,再讲清楚两者各自的职责边界。
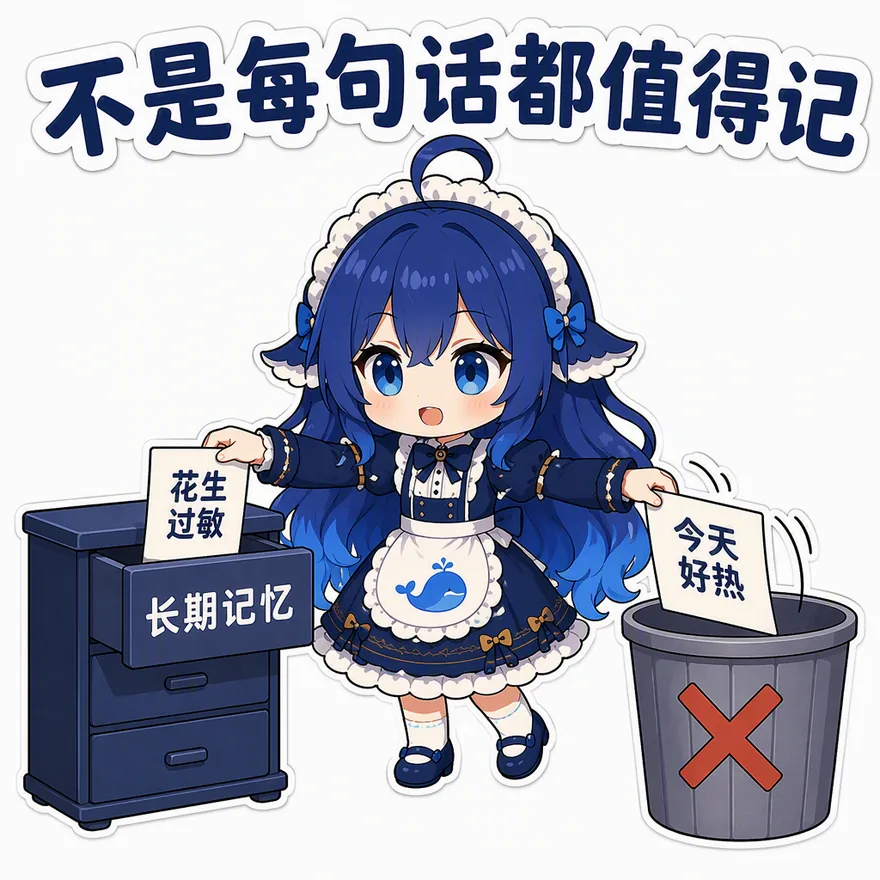 不是每句话都值得记(「花生过敏」进长期记忆抽屉,「今天好热」进垃圾桶——Memory 的第一道工序是写入门槛,不是照单全收)。
先给一个能复述的答案
RAG 解决「去哪找知识」:对语料做相似度检索,把相关内容送进上下文。Memory 解决「什么该记住、什么时候该忘」:包含写入决策、时间与重要性排序、冲突处理、遗忘机制。两者是包含关系——语义检索是 Memory 取回内容的一种手段;RAG 系统可以没有记忆,Memory 系统几乎离不开检索。判断标准:知识是共享的、无个人状态的,RAG 够用;要跨会话记住用户、跟踪状态、处理新旧冲突,必须上 Memory。
 图:小蓝图解——Memory vs RAG:查资料 vs 记得你。
同一个对话里的两句话,命运应该不同
用户对助手说:「我对花生过敏。」三天后又说:「今天好热。」
从检索视角看,这两句话都可以被向量化、存进库、在相似查询时召回。但从记忆视角看,它们的命运完全不同:过敏信息必须可靠保存,在几个月后的餐厅推荐里被想起;「今天好热」当下有点用,过后就该被丢掉。
RAG 没有丢弃机制——进了库的内容,在检索空间里永远平等。Memory 系统的第一件事,就是在写入前判断这句话值不值得进长期记忆。
一句话概括两者分工:RAG 只负责「把相关内容找回来」,找回来的内容对错、新旧、重不重要,它不判断;Memory 要对信息做完整的生命周期管理——哪些值得写入、哪些听过就丢、哪些过期被替代、哪些取回时优先。
RAG 管空间,Memory 还要管时间与重要性
向量检索的本质是在空间里找近邻:查询和文档在语义空间里离得越近,越先被召回。这个机制只回答「像不像」,不回答「新不新」「重不重要」。
记忆取回要多维打分。Generative Agents(2023)的记忆流设计给出了经典方案:每条记忆除了内容向量,还带一个写入时评估的重要性分;检索时按相关性、时效性、重要性三项各自归一化后加权求和,取高分进入上下文。其中时效性随时间指数衰减,旧记忆自然排到后面。
这个设计被后来的记忆系统广泛沿用。AgentAlpha 面试题库 · 字节篇 Memory 部分把它出成了排序题:「如何设计记忆的相关性、重要性、时效性与置信度综合排序?」——比纯相似度多出来的那几项,正是 Memory 区别于 RAG 的地方。
| 维度 | RAG 检索 | Memory 取回 |
|---|---|---|
| 相关性 | 向量相似度,唯一依据 | 多维之一 |
| 时效性 | 通常不感知 | 时间衰减,新近度加分 |
| 重要性 | 无此概念 | 写入时打分,影响排序 |
| 置信度 | 来源可信度,可选 | 综合排序的常规项 |
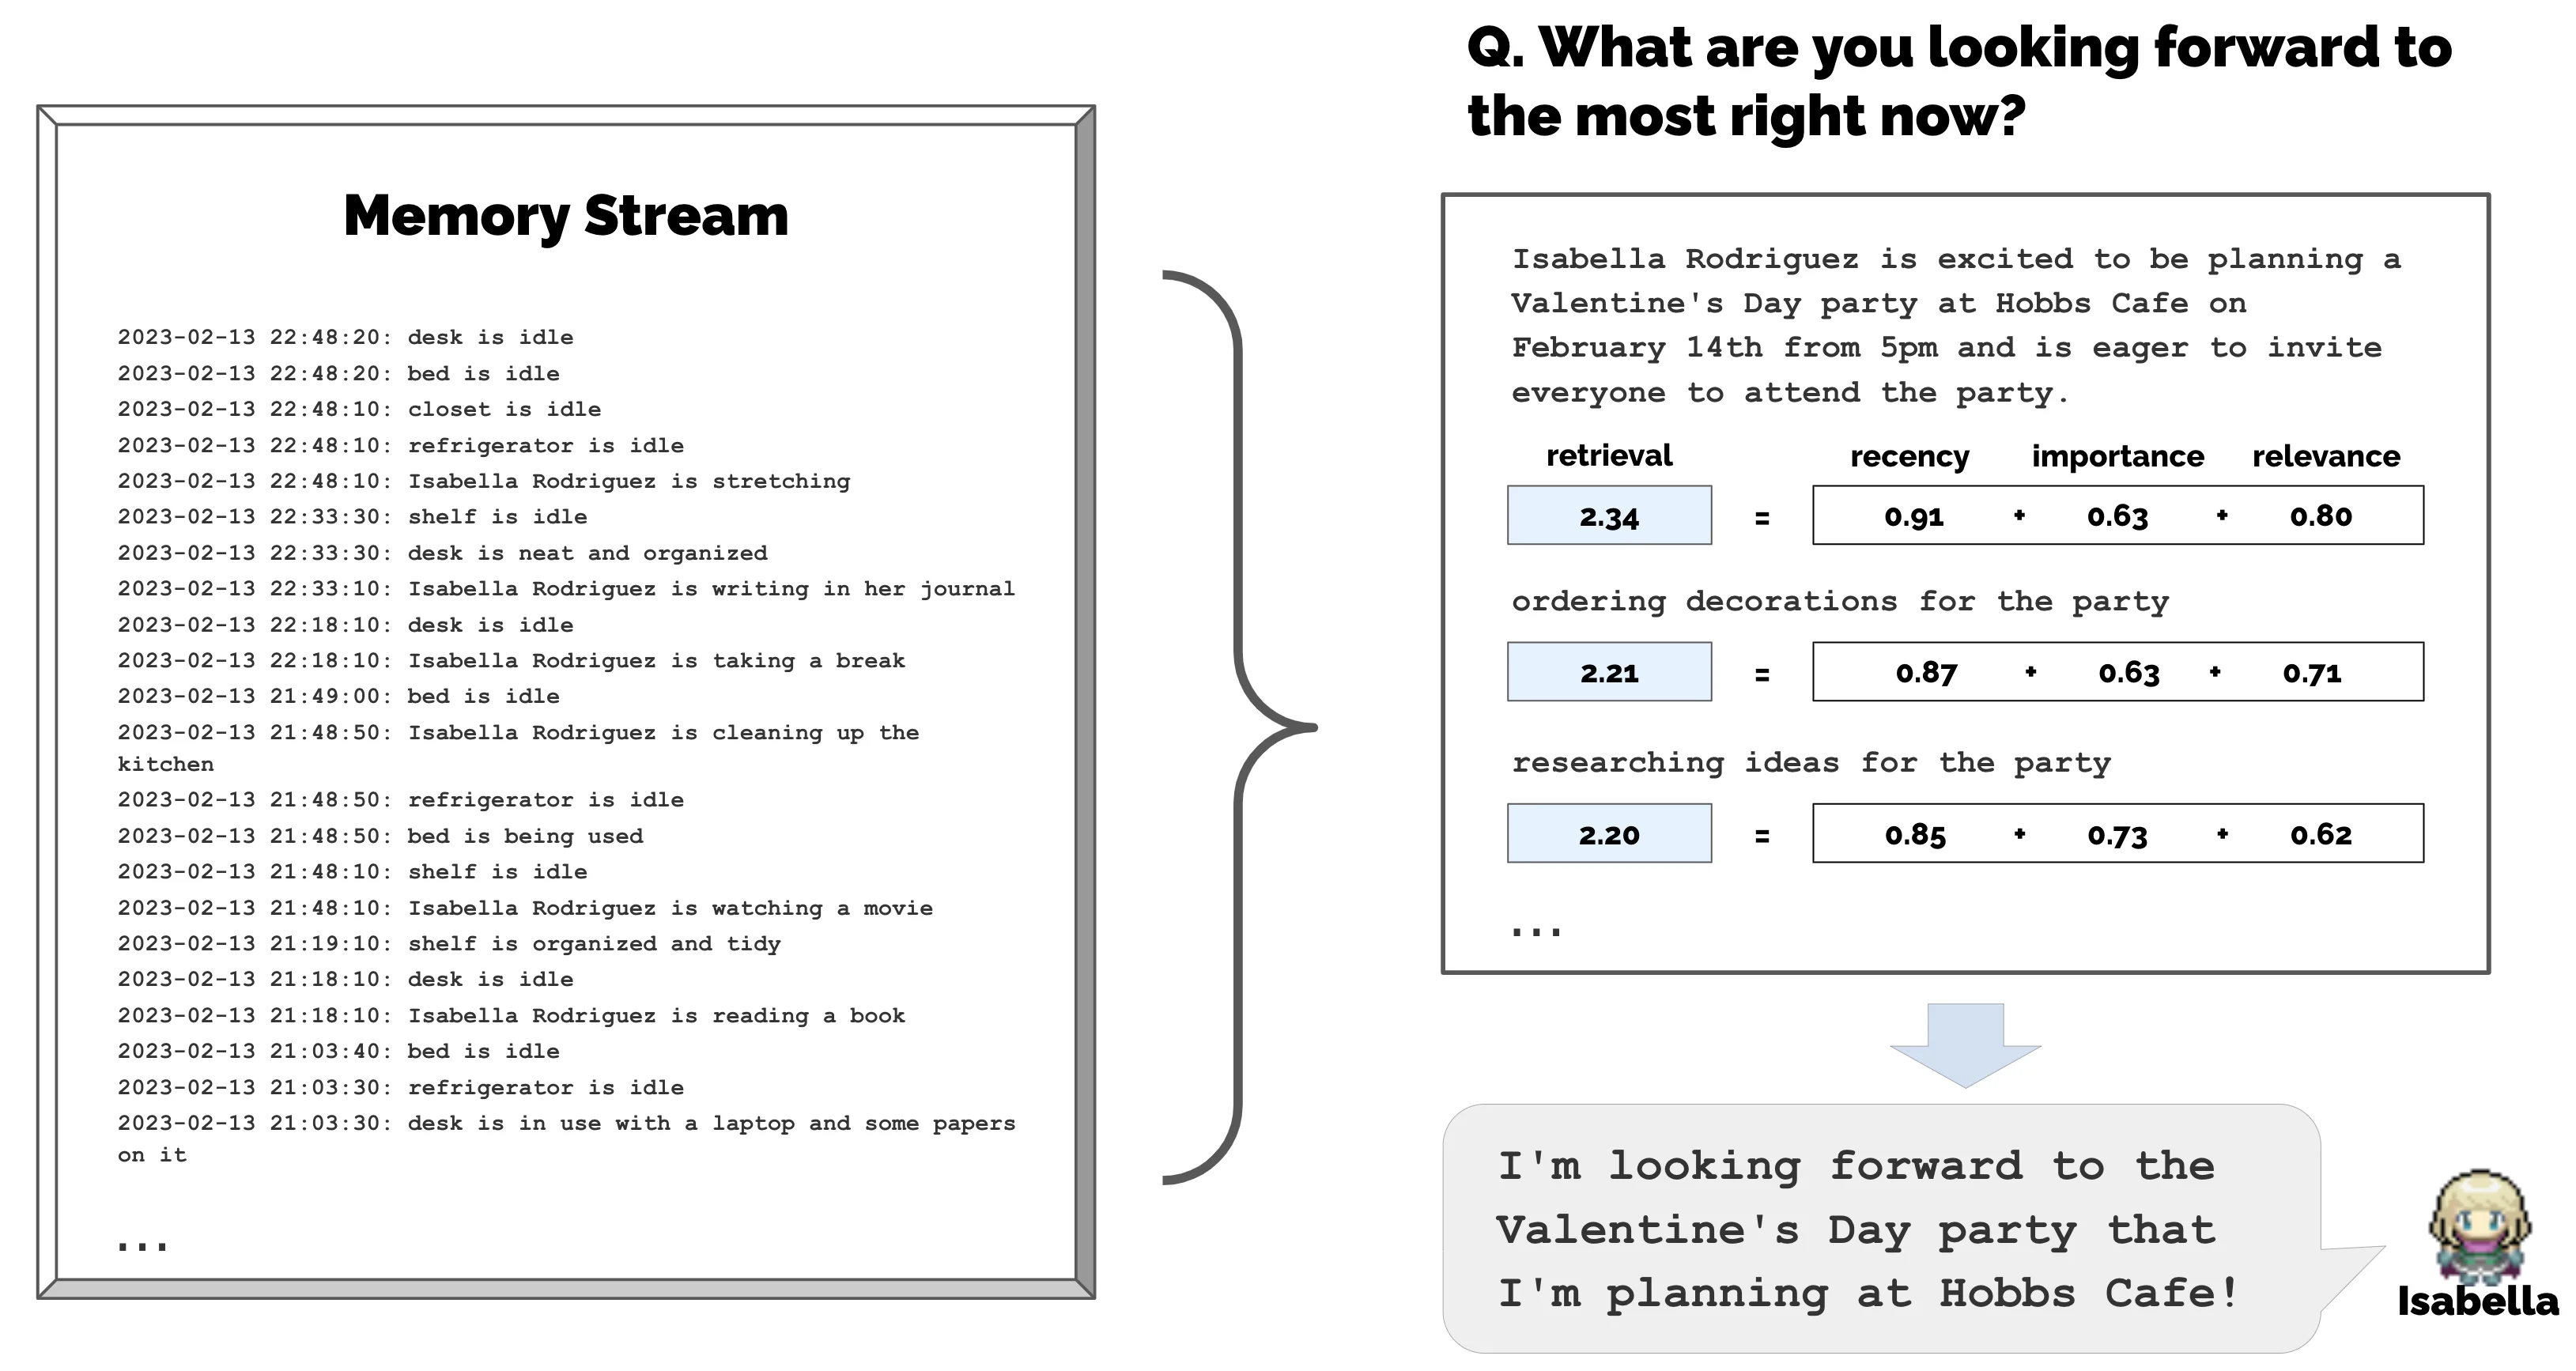 图:Generative Agents 的记忆流与检索打分(左侧是 Agent 经历过的每条观察,带时间戳逐条写入记忆流;右侧是同一查询在不同权重组合下检索出的不同记忆——相关性、时效、重要性三个分数加权,决定哪些记忆进入上下文)
写入决策与遗忘:Memory 的门和闸
RAG 侧的内容来了就索引,Memory 侧每条写入都要过决策——Memory 的难点一大半在写入这一侧。
写入门槛:什么值得进长期记忆?常见门槛包括——信息是用户显式表达的(说出来的,不是推断出来的)、可跨场景复用的、非敏感的、与已有记忆不冲突的。全部满足才写,缺一条就只留在当前会话。
防幻觉固化:模型自己总结出的「用户偏好」可能是幻觉,写进长期记忆就会在未来反复被引用,错得越来越深。对策是区分「用户原话」和「模型推断」:推断内容只能带低置信度标记进入,被后续证据确认后才能升级。
冲突与遗忘:用户半年前说「我对花生过敏」,现在说「我不过敏了」。旧记忆不能直接删——历史要可追溯;新记忆要能生效——不然答案自相矛盾。常见做法是新版本标记生效、旧版本标记被替代,取回时只取有效版本。容量压力下,再配合时间衰减和使用频率做淘汰。
AgentAlpha 面试题库 · 字节篇 Memory 部分直接考写入决策:「什么信息应该写入长期记忆?写入决策如何避免把幻觉永久保存?」——答出「先过滤再写入、原话与推断分开置信度」,就是高分结构。
混合存储:向量、图、结构化各管一段
记忆内容形态不同,适合的存储也不同,成熟方案几乎都是混合存储:
| 存储形态 | 擅长 | 不擅长 | 典型内容 |
|---|---|---|---|
| 向量库 | 语义相似检索 | 精确更新、关系推理 | 经历、对话片段、知识 |
| 图存储 | 实体关系、多跳查询 | 模糊语义匹配 | 人物-组织-事件关系 |
| 结构化表 | 精确读写、冲突覆盖 | 开放语义搜索 | 用户画像字段、任务状态 |
分工很清楚:用户画像里的「过敏原:花生」放结构化字段,更新时直接覆盖;「上个月退货过一次」放向量库,供经历召回;「用户和某公司的人是同事」放图存储,支撑多跳推理。
那什么时候纯 RAG 就够?知识公开共享、没有个人状态、不需要跨会话记住任何人——企业文档问答、产品手册助手,RAG 是正确且更简单的答案。需要个性化、状态跟踪、冲突处理的那一刻,才必须引入 Memory。
MemGPT 的启示:像操作系统一样管理记忆
MemGPT把这件事推到了更完整的形态:把大模型的上下文窗口当作「主存」,把窗口外的存储当作「外存」,由模型自己通过函数调用在两者之间换页——需要什么就调进来,放不下了就换出去。这借用了操作系统在内存和磁盘之间调度数据的思路。
在这个架构里,RAG 的位置一目了然:它是外存的一种检索手段,服务于主存的调度决策,而不是 Memory 本身。决定「何时取、取什么、放不放回去」的,是 Memory 层的逻辑。
面试里再遇到「Memory 为什么要淘汰 RAG」这类问法,正确姿势是拆题:被淘汰的是「把 RAG 当成记忆全部」的用法,不是检索本身。检索会一直是记忆系统的地基,但只有检索、没有写入决策、时间管理和遗忘机制,就撑不起一个跨会话的 Agent。
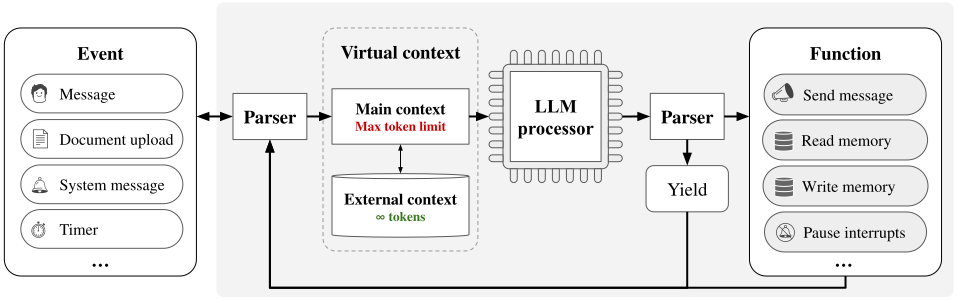 图:MemGPT 的分层记忆调度(把模型的上下文窗口当内存、外部存储当磁盘,主存装不下就分页换出;函数执行器在两层之间搬数据,让小窗口也能扛长任务)
面试现场:追问怎么接
「Memory 和上下文压缩什么关系?」 压缩服务当前窗口,解决装得下;Memory 服务跨会话,解决留得下。压缩丢掉的细节可以沉降到 Memory,两者是接力关系,不是二选一。
「怎么评测 Memory 有没有用?」 不能只看检索相似度。构造需要跨会话记忆的任务集,对比有无 Memory 的任务成功率;同时监控错误写入率和跨用户泄漏。
「摘要迭代后语义漂移怎么办?」 每次摘要保留版本链;关键事实(约束、偏好)用结构化字段存而不进摘要,摘要只管叙述性内容。
参考答案要点
- 先拆题:RAG 和 Memory 不是替代关系。RAG 是空间检索,Memory 是带写入决策、时间、重要性和遗忘的完整管理机制。
- 关键机制:取回按相关性、时效性、重要性加权(Generative Agents 的记忆流);写入有门槛,原话与推断分开置信度,防幻觉固化。
- 混合存储分工:画像用结构化字段、经历用向量、关系用图;MemGPT 把窗口当主存、外部当外存,检索只是换页手段。
- 主动说坑:把模型推断当用户原话写进长期记忆,幻觉会反复被引用。
- 收在取舍:共享知识 RAG 就够;出现跨会话个性化和状态冲突的那一刻,才需要 Memory。