Demo 里一气呵成,上线三天全是问题:多轮对话丢约束、重复执行了写操作、出了事故查不到记录。复盘会上团队的第一反应是换模型,换了之后问题原样复现。这类项目的共同点在于:卡住系统的从来不是模型能力,是模型周围的五件工程事。
先说结论
模型能力早就够撑起一个 demo,企业级和 demo 之间隔着五个高频卡点:记忆系统缺位、评测体系缺位、权限与安全边界缺失、可观测性不足、业务系统集成太浅。每个卡点都有对应的最小补法,补齐这五件,系统才算从“能演示”变成“能上生产”。
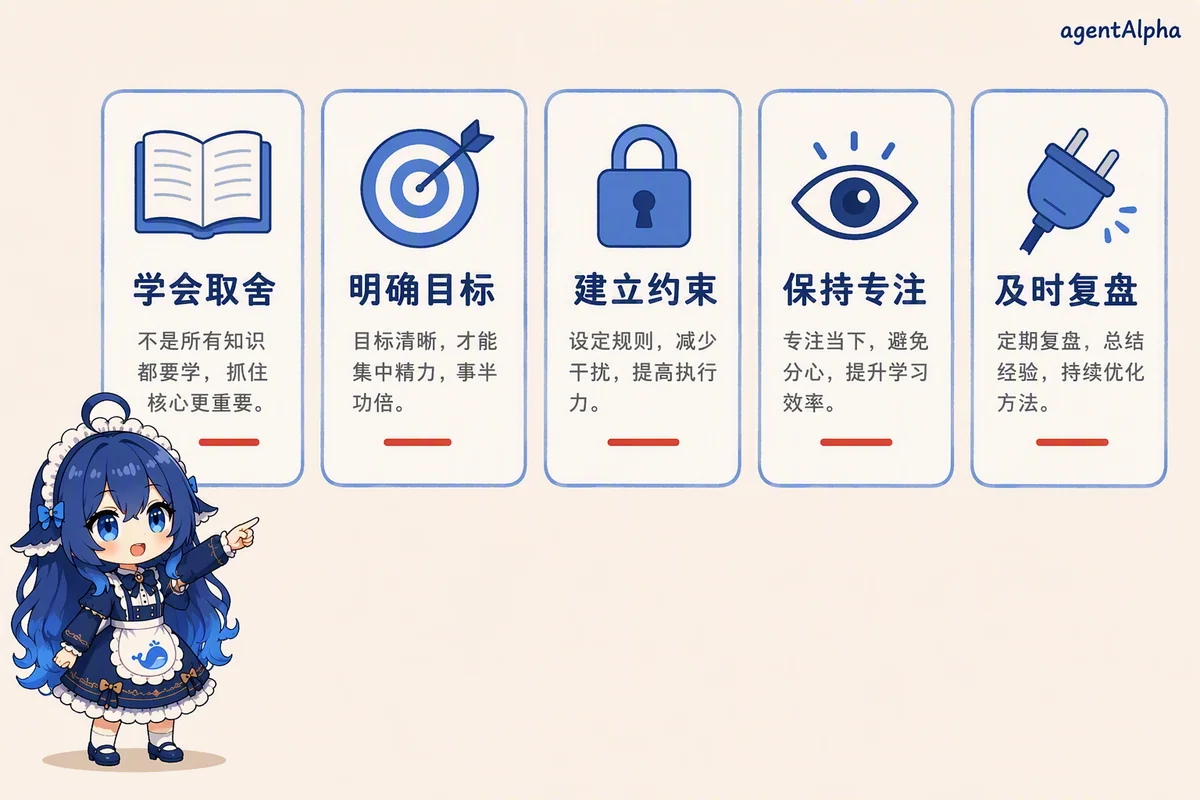 图:小蓝图解——企业级五卡点,逐个打补丁。
卡点一:记忆系统缺位
最常见的实现,是把全部对话历史塞进上下文,塞满就截断。这在多轮任务里必出事:用户第三轮说的约束,第八轮被截掉,Agent 照着残缺信息继续执行。
完整的记忆设计分三层:短期记忆管当前会话的工作状态(目标、已完成步骤、待办事项);长期记忆管跨会话的用户偏好和任务档案,放外部存储,按需检索;变量注入把用户 ID、订单号这类关键业务变量显式写进上下文模板,不依赖模型自己从历史里“记得”。
MemGPT(2023)给了这套设计一个清晰的参照:借鉴操作系统管理内存的方式,把上下文当主存、外部存储当磁盘,由模型通过函数调用在两者之间搬运信息,让有限窗口也能维持长任务状态。变量注入这一层看起来最朴素,效果却最直接:把“当前用户是谁、正在处理哪笔订单”写成模板字段,模型就不需要从几千字历史里“回忆”这些事实,幻觉和串单都会少一截。
最小补法:会话状态落库、关键变量模板注入、长期记忆走检索——三件事一个星期就能加上。字节篇有道真题考的就是压缩这一层:「超长任务中怎样做上下文压缩,同时保留目标、约束、工具结果和未决事项?」(AgentAlpha 面试题库 · 字节篇)
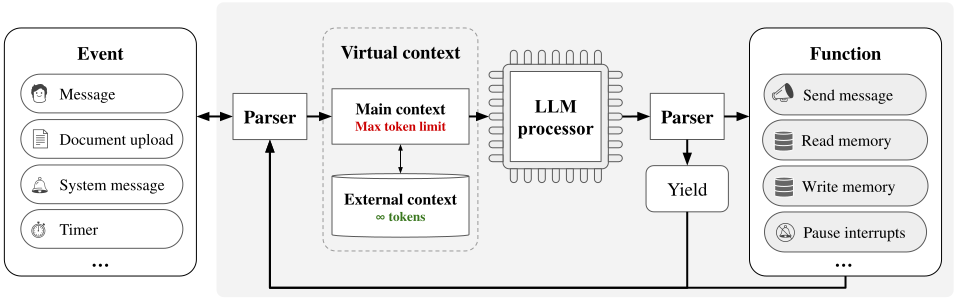 图:MemGPT 的分层记忆调度(把模型的上下文窗口当内存、外部存储当磁盘,主存装不下就分页换出;函数执行器在两层之间搬数据,让小窗口也能扛长任务)
卡点二:评测体系缺位
没有评测集的团队,每次改提示词都是在赌:改完跑两个手测用例就上线,两周后任务成功率悄悄下滑,没人知道为什么。
最小补法不贵:先攒 30 到 50 条覆盖典型场景的黄金用例,任务级看成功率,步骤级看工具调用对不对、检索有没有命中。指标要分层看:任务级回答“系统能不能用”,步骤级回答“坏了坏在哪”,两层缺一不可——只有任务级,失败归因靠猜;只有步骤级,整体质量说不清。之后每次改动,先过评测集再谈上线。字节篇有道题把它问得很完整:「如何设计可回放的 Agent 状态,使线上 Bad Case 能完整复现?」(AgentAlpha 面试题库 · 字节篇)——评测集加可回放,线上问题才能定位,而不是靠猜。
卡点三:权限与安全边界
Agent 一旦能调工具,就有了副作用:改数据、发消息、动钱。很多团队图省事,给 Agent 配了一个全能账号——出一次事故就是灾难。
最小补法:工具按副作用分级。只读工具直接放行;写操作走白名单;高危动作(退款、删除、对外发送)强制人工确认。再叠一层防注入:字节篇有道题专门考这个——「如何防止 Prompt Injection 诱导 Agent 调用越权工具或泄露工具结果?」(AgentAlpha 面试题库 · 字节篇)原则只有一条:服务端权限校验不能信任模型输出的参数,工具层要再验一遍。
卡点四:可观测性不足
“它今天为什么这么回答?”——答不上这个问题的系统没法维护。很多实现只有一条聊天记录:检索了什么、工具返回了什么、哪一步走了岔路,全都不可见。
最小补法:每轮循环记一条结构化 Trace——当轮输入、提示词、选中的工具、参数、返回、错误分类——串成完整轨迹,支持按任务 ID 回放。腾讯篇有道题把失败分类也纳入了工程:「如何把 Agent 的失败拆成模型、工具、状态和业务校验四类?」(AgentAlpha 面试题库 · 腾讯篇)失败有分类、Trace 有轨迹,复盘才不用翻聊天记录。
卡点五:业务系统集成太浅
很多“企业 Agent”停在问答:能告诉用户怎么退款,不能真的退款。对企业来说,不能落进系统的回答,只是一份高级 FAQ。
最小补法:选一个真实业务流程(工单分类、退换货初审),把它的接口封装成工具,让 Agent 的输出直接写进业务系统,跑稳之后再扩场景。集成深度,决定这套系统在企业里是玩具还是生产工具。挑场景有个标准:流程稳定、接口干净、人工操作量大,三者同时满足的场景,往往一个就足以证明价值;反过来,接口都凑不齐的流程,先别碰。
五个卡点一张表
| 卡点 | 典型症状 | 最小补法 |
|---|---|---|
| 记忆系统 | 多轮失忆、跨会话归零 | 状态落库 + 变量注入 + 检索式长期记忆 |
| 评测体系 | 改提示词全靠赌 | 30–50 条黄金用例 + 任务级/步骤级指标 |
| 权限安全 | 全能账号、一次事故回放 | 工具分级 + 高危人工确认 + 服务端二次校验 |
| 可观测性 | 出问题查不到 | 结构化 Trace + 按任务 ID 回放 |
| 业务集成 | 停在问答,不落动作 | 挑一个流程接成工具,输出写进系统 |
补齐顺序也有讲究。评测和 Trace 最优先——它们不直接产生功能,但决定了后面每一次改动是“验证过的”还是“碰运气的”。记忆其次,权限跟着上:功能越强,权限越不能晚。集成可以最后收尾,但可以最早启动——挑流程、谈接口这些事,不依赖前面任何一件完成。
面试怎么答 / 要点复盘
30 秒版本:卡住的不是模型,是五件工程事——记忆(分层设计加变量注入)、评测(黄金用例加分层指标)、权限(工具分级加人工确认)、可观测(结构化 Trace 加回放)、集成(选一个流程落进业务系统)。每个卡点都能给出最小补法和补齐顺序。
容易被扣分的说法:把企业级难点归结为“模型推理能力不够”,说明没维护过生产系统;给每个卡点都开“上大平台、买商业方案”的药方,也说明没有最小补法的意识。
追问预测:「多租户 Agent 的记忆如何做用户绑定、权限隔离和删除?」(AgentAlpha 面试题库 · 美团篇)答法:记忆按租户分域存储,检索先过权限过滤,删除要同步覆盖向量库、缓存和备份。
要点复盘:
- 五个卡点都有便宜的第一步:先补评测和 Trace,再补记忆和权限。
- 出了问题先对卡点清单,再谈换模型——换模型堵不上工程缺口。
- 集成深度是“企业级”三个字的最终检验。
参考答案要点
企业级 Agent 卡住的不是模型,是五件工程事:记忆缺位——只有聊天历史,没有短期、长期加变量注入的分层设计,MemGPT 的分页思路是可以直接参考的作业;评测缺位——先攒三五十条黄金用例,别拿生产环境当测试场;权限缺失——工具按副作用分级,高危动作必须人工确认;可观测性不足——每轮记结构化 Trace,出事能回放;集成太浅——输出要能写进业务系统。最容易踩的坑是出了问题先换模型,工程缺口一个都没堵上。收一句:五个卡点的补齐顺序,按“出一次事故的代价”排,不按技术含量排。