「我们直接买 ChatGPT 企业版,为什么还要自建?」——每个做过企业 Agent 立项的人都被老板问过这句话。它不是坏问题,反而逼你说清楚:通用对话产品和企业落地之间,到底隔着什么。面试里这题会更具体,比如腾讯篇这道系统设计题:「请设计微信客服的端到端 Agent 平台,覆盖网关、编排、模型、工具、状态和观测。」(AgentAlpha 面试题库 · 腾讯篇)注意,模型只是其中一层。
先说结论
通用对话产品解决“人跟模型聊”,企业要的是“系统在权限内、可审计地完成业务动作”,中间隔着五件事:私有知识接入、权限与数据边界、可审计、业务系统集成、成本可控。自建不等于从零训练模型,绝大多数工作在编排层;数据不敏感、无副作用的场景,直接用现成产品反而是对的。
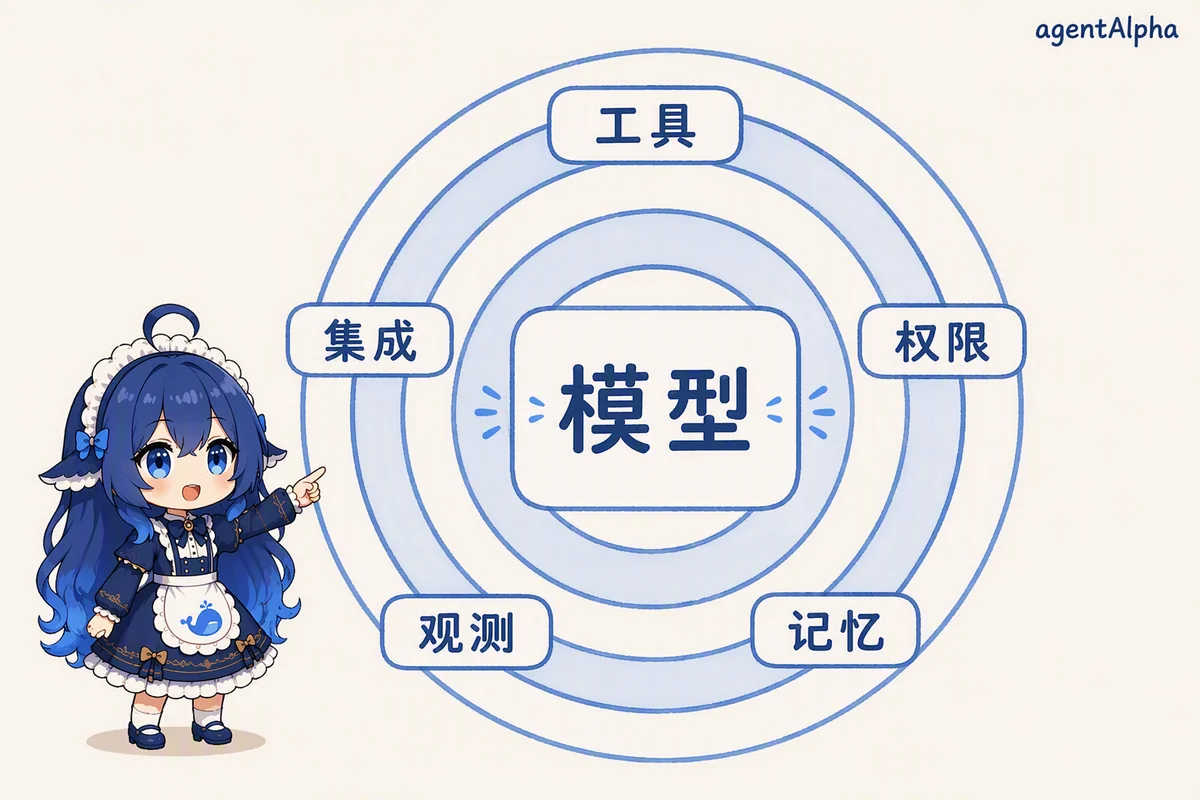 图:小蓝图解——模型只占其一:外面还有五层工程。
隔着的五件事
一、私有知识不在模型里。通用模型只知道公网上的东西,你家的费率规则、内部流程、工单历史,它一概不知。要么接检索,要么接知识库,而这套接入和更新机制没有现成产品能替你做对——因为知识是你的,不是模型的。而且知识在变:规则这个月改版、下个月生效,检索管道的更新和版本管理是长期工程,不是一次性接入。
二、权限与数据边界。对话产品的默认假设是“用户能看到自己问的一切”。企业场景不是:销售不能查财务明细,客服不该看到完整证件号。每个请求都要先过权限,检索和回答都要按角色裁剪,这是产品形态层面缺失的能力,不是提示词能补的。
三、可审计。监管和复盘要能回答“系统当时为什么这么决定”。对话产品留下的是聊天记录;企业 Agent 留下的必须是决策记录——当时检索了什么、调了什么工具、依据哪条规则。审计的粒度也有讲究:不只是“答了什么”,还包括“为什么答”——引用了哪条规则、哪个版本、谁授的权。拿不出这份记录的系统,出一次事就得停。
四、业务系统集成。通用产品的终点是聊天窗口;企业流程的终点是工单系统、ERP、CRM。退款要真的退,发货要真的发。Agent 必须长在业务系统上,而不是长在聊天框里。
五、成本可控。按座位付费的计费方式,和“按任务算账”的现实对不上。一个自动处理工单的 Agent,单任务消耗多少 token、调几次检索、失败重试几轮,都要有预算和账单,否则规模一大就失控。常见的失控点不是单次调用贵,而是失败重试把成本放大几倍——这也是要给每个任务设预算上限的原因。
“自建”建的是编排层,不是模型
这里有个常见误解:自建等于自己训模型。实际上绝大多数企业不自训,自建的是模型外面那层工程:任务拆解循环、工具层、状态管理、权限网关。
任务拆解循环的基本骨架,就是 ReAct 式的“想一步、做一步、看结果”(ReAct,2022):接到工单先拆步骤,逐步调用内部接口执行,拿真实返回决定下一步。模型在这套骨架里是可替换的部件——今年用 A 模型,明年换 B 模型,工具和流程资产都留在自己手里。
回到上面那道腾讯篇的题:网关、编排、模型、工具、状态、观测六层里,模型只占其一。面试官考察的正是你能不能看到模型之外的那五层——而那五层,恰恰就是“自建”两个字的真实含义。
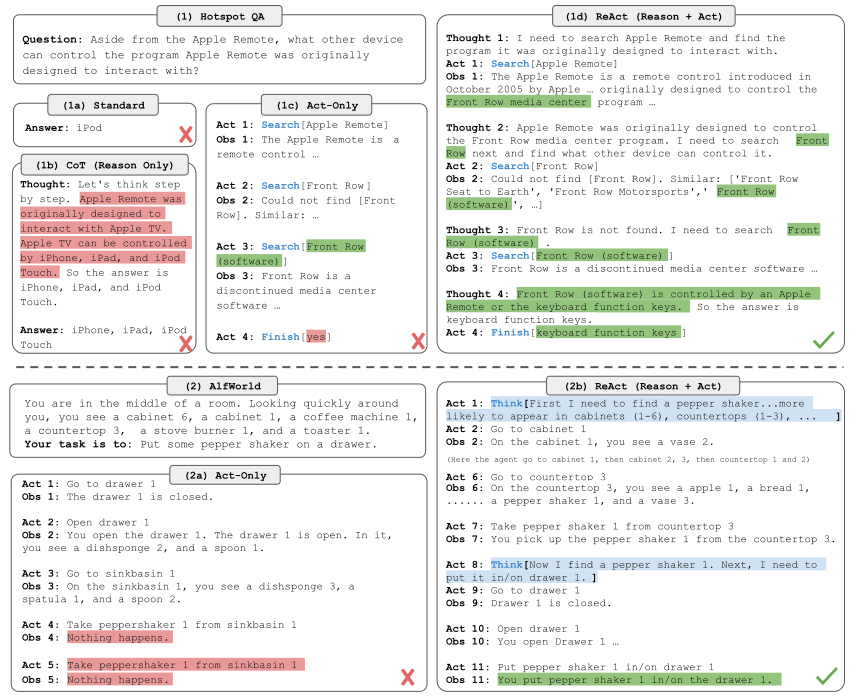 图:四种提示方法的对比实验(同一组任务上:Standard 直接答题、CoT 先写推理再答、Act-only 只执行不思考、ReAct 想一步做一步再看观察结果;带环境反馈的 ReAct 在 HotpotQA 与 ALFWorld 上成功率都明显更高)
自建的最小起步
“自建”听起来吓人,起步其实很轻,常见路径分三步。
第一步,内部知识问答:把私有文档接进检索,模型只读不写,权限先做文档级过滤。这一步风险最低,也最容易验证价值。第二步,只读工具:让 Agent 能查订单、查工单,回答带出处。第三步,落动作:挑一个高频流程,把它的接口封装成工具,配上人工确认,让输出真正改变业务状态。
每一步都有独立的验收标准,做不动就停在能验收的那一步——比一步到位的“大平台”靠谱得多。
什么时候直接用 SaaS 反而正确
| 判断维度 | 直接用通用产品 | 自建 Agent 系统 |
|---|---|---|
| 数据敏感度 | 内容公开或可外发 | 私有数据不能出域 |
| 动作副作用 | 只读、只聊、只写文档 | 要动真实业务系统 |
| 集成深度 | 独立工具,不进流程 | 要嵌进业务流程和审批 |
| 合规要求 | 无强制审计 | 决策必须留痕可追溯 |
| 团队投入 | 没有工程团队 | 有维护预算和长期负责人 |
判断方法可以很直接:任务如果只是“人问模型答”,答案不落地成动作,先用现成产品验证需求;一旦答案要变成带副作用的动作,或者数据不能出域,就该自建。中间地带——比如内部知识问答、数据不敏感、不需要审计——拿现成产品加一层权限代理,往往比自建便宜。
还有一个朴素的经验法则:先用手动流程跑一个月,统计这类请求的真实频次和复杂度,再决定投入。需求没验证就立项,是企业 Agent 项目里最常见的浪费。
阿里篇有道真题对应这里的权限层:「如何实现租户、角色、店铺和文档多级权限过滤?」(AgentAlpha 面试题库 · 阿里篇)——不管全自建还是半自建,这一层都躲不掉,而且必须在第一天就设计,事后补权限的代价是重做数据层。
面试怎么答 / 要点复盘
30 秒版本:通用产品解决对话,企业解决“权限内的可审计动作”;差距是私有知识、权限边界、可审计、业务集成、成本控制五件事;自建主要是编排层工程,以任务拆解循环为骨架,模型保持可替换;数据不敏感、无副作用、不进流程的场景,直接用现成产品更合理。
容易被扣分的说法:把自建等同于“买显卡训模型”,暴露不了解编排层;把五件事说成“买企业版就能解决”,说明没处理过权限和审计。反过来,把 SaaS 一棍子打死也扣分——能借力的地方借力,本身就是工程判断力。
追问预测:「多租户 Agent 的记忆如何做用户绑定、权限隔离和删除?」(AgentAlpha 面试题库 · 腾讯篇)答法:记忆按租户和用户分域存储,检索前先过权限过滤,删除请求要同步覆盖向量库、缓存和备份。
要点复盘:
- 五件事:私有知识、权限边界、可审计、业务集成、成本可控。
- 自建 = 编排层工程,不是从零训模型;模型是可替换部件。
- 用两个问题定方案:答案要不要变成带副作用的动作?数据能不能出域?
参考答案要点
通用对话产品解决“人跟模型聊”,企业要的是“系统在权限内、可审计地完成业务动作”,中间隔五件事:私有知识接入、权限与数据边界、可审计、业务系统集成、成本可控。自建大多不是训模型,而是做编排层:以 ReAct 式任务拆解循环为骨架,接上自己的工具、状态和权限网关,模型保持可替换,流程资产留在企业手里。要防的坑是无脑自建:数据不敏感、答案不落地成动作的场景,直接用现成产品更快更省。收在判断标准上:答案要不要变成动作、数据能不能出域,两个问题定方案。