演示环境里,一个 Agent 挂着几十个工具,问答如流。接到真实需求后开始变味:上下文越长越记不住事,检索结果和自己写的草稿混在一起,规划到一半突然自己去执行,执行完又忘了汇报。这不是模型不行,是把所有角色塞进了同一个上下文。面试里对应的考法是:「单 Agent、Supervisor-Worker、层级式与去中心化多 Agent 架构如何选型?」(AgentAlpha 面试题库 · 字节篇)——选型之前,你得先说清拆分的动因。
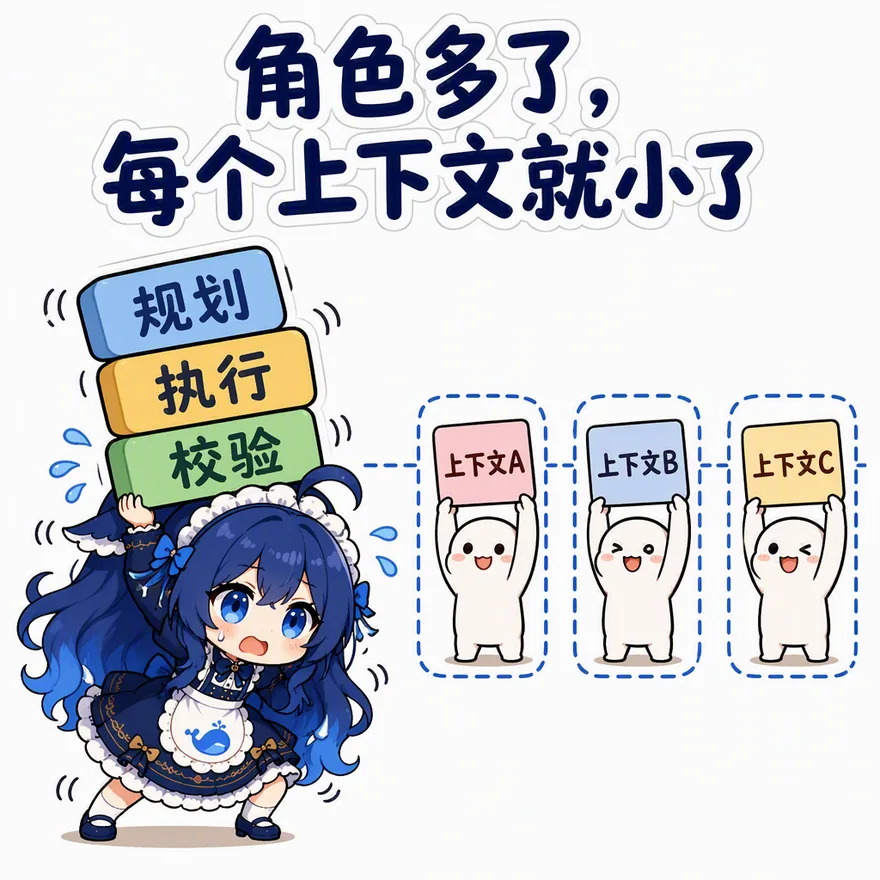 角色多了,每个上下文就小了(左边一个 Agent 头顶三块牌子摇摇欲坠,右边三个小 Agent 各管一张卡——拆分角色是在给上下文减负)。
先说结论
拆 Multi-Agent 的真实动因是两个工程约束:上下文窗口有限,单 Agent 的提示词、工具说明和任务历史会互相挤压;职责过多导致角色混乱,一个提示词同时管规划、执行、校验,行为不可控。拆分用职责切分换上下文隔离,代价是通信、一致性和调试难度上升——不是“人多力量大”。
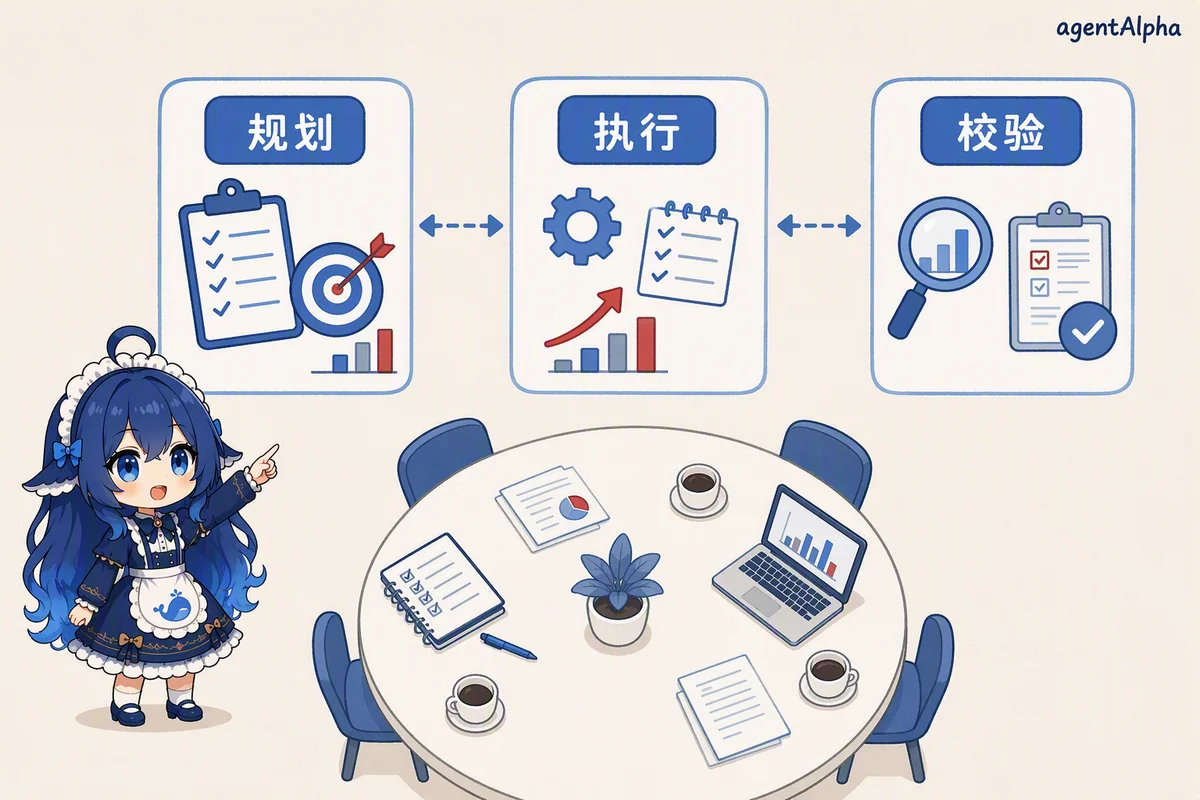 图:小蓝图解——规划、执行、校验的角色分工。
动因一:上下文是稀缺资源
单 Agent 的上下文要同时装下:系统提示词、几十个工具的说明、任务历史、每步的中间结果。任何一样膨胀,其余的就被挤到边缘。长任务的工具返回动辄几千 token,几轮下来,最初的目标和约束已经被稀释得差不多了。
典型症状有两个:忘记最初目标(上下文头部被截断或稀释),以及把中间产物当事实(自己生成的草稿和工具返回混在同一份历史里)。
给不同角色独立的上下文,是最直接的隔离手段。执行 Agent 的历史再乱,也不会污染规划 Agent 的判断。这也是为什么“加长上下文”替代不了拆分:窗口再大,角色冲突还在——校验者面对的是自己刚写完的代码,它下不去手挑毛病。
动因二:角色混乱不可控
在一个提示词里写“你要先规划、再执行、最后自查”,模型经常串戏:规划到一半直接动手,执行完忘了校验,或者校验时把自己的输出当标准答案。这不是提示词写得不好,是职责本身有冲突——执行者天然想“赶紧做完”,校验者天然要“挑毛病”,放进同一个上下文,前者会压制后者。
拆开之后,每个角色有自己的提示词、工具集和完成标准:Planner 负责拆解和分配,Executor 负责调工具执行,Checker 负责对照标准验收。谁能生成什么、谁能调用什么工具,边界是显式定义的。
两条研究路线:对话式与角色扮演式
学术上有两条有代表性的路线。AutoGen(2023)把多 Agent 应用建模为多个 agent 之间的对话:每个 agent 可定制、可携带工具,人也能作为其中一个角色参与,开发者通过编排这些对话来搭建应用。CAMEL(2023)走角色扮演路线:给两个 agent 分配不同角色和初始指令,让它们用自然语言互相沟通、推进任务,减少人工逐步介入。
两条路线的共同点值得点破:协作发生在 Agent 之间,而每个 Agent 背后往往还是同一个 LLM——变的不是模型,是上下文的组织方式。
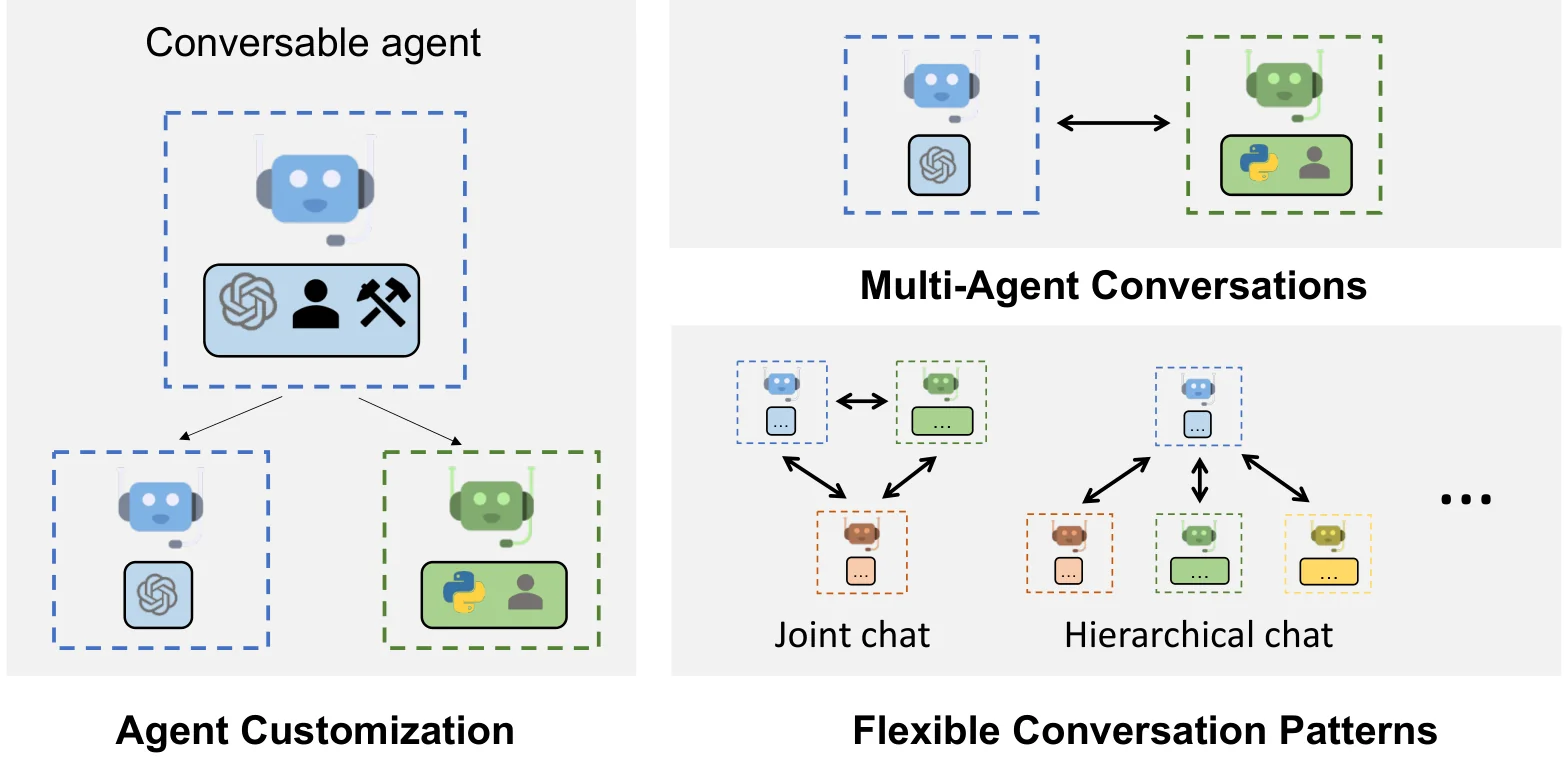 图:AutoGen 的多智能体协作框架(每个 Agent 都可对话、可定制,背后可以接大模型、人类输入或工具,多个 Agent 通过多轮对话合作完成任务)
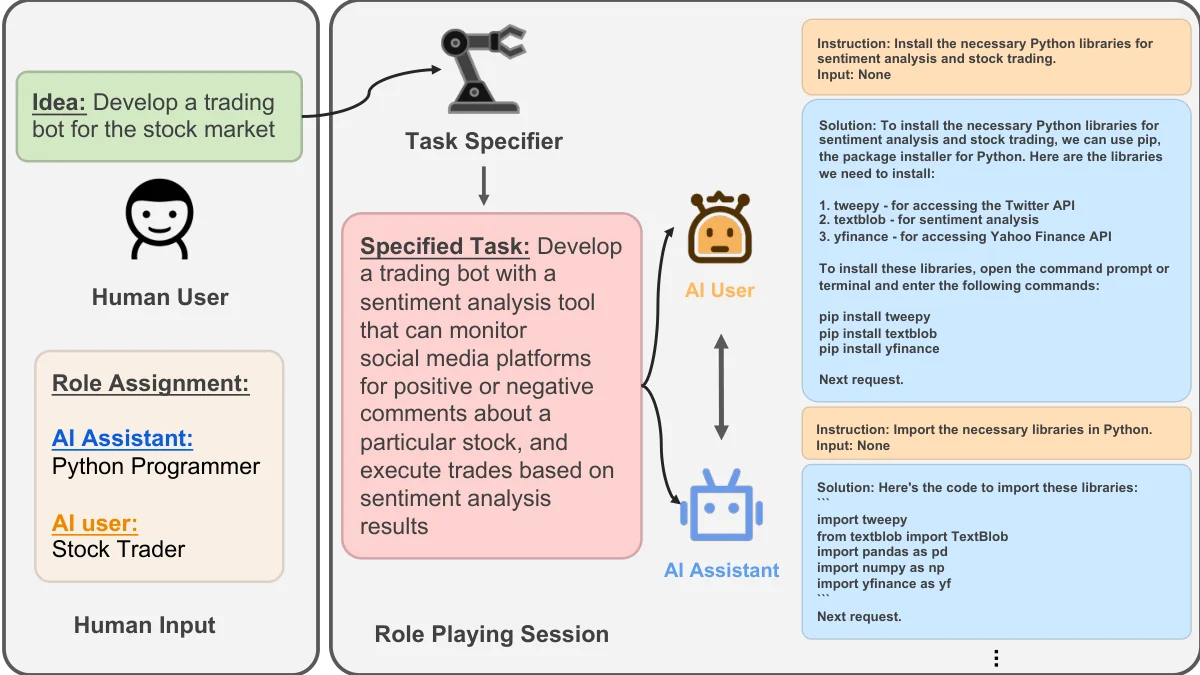 图:CAMEL 的角色扮演协作框架(AI 用户与 AI 助手两个角色先做任务细化,再通过多轮对话推进任务——最早验证「角色分工 + 对话驱动」可行性的工作之一)
消息协议与共享状态
拆开之后,新问题立刻出现:Agent 之间传什么?
传自然语言的好处是灵活,坏处是信息损失——执行者转述给校验者时丢掉的前提,后面补不回来。字节篇有道真题直指这个选择:「多 Agent 之间传自然语言还是结构化状态?怎样控制信息损失?」(AgentAlpha 面试题库 · 字节篇)
工程上的常见做法是折中:任务指派用结构化字段(任务 ID、目标、约束、完成标准、依赖关系),过程沟通允许自然语言,关键结论写回共享状态库,让任何 Agent 都能查到权威版本,而不是靠转述。
一个够用的结构化任务卡,字段不用多:任务 ID、目标描述、约束条件、完成标准、上游依赖、当前状态。前五个字段保证交接不走样,最后一个让任何角色接手时都知道任务走到哪。自然语言讨论可以继续发生,但结论要回写进这些字段。
新成本与适用边界
| 维度 | 单 Agent | Multi-Agent |
|---|---|---|
| 上下文 | 一份,互相挤压 | 每角色独立,天然隔离 |
| 职责边界 | 一个提示词全包 | 显式定义,可分别评测 |
| 调试 | 一条轨迹 | 多条轨迹交叉,定位更难 |
| 通信开销 | 无 | 每次交接都有信息损失风险 |
| 成本 | 一份 token 消耗 | 多份,随角色数增长 |
| 适用规模 | 工具少、流程线性 | 工具多、任务可分、职责可分 |
美团篇有道题把这笔账问得很直白:「如何衡量多 Agent 相比单 Agent 带来的质量收益是否值得额外成本?」(AgentAlpha 面试题库 · 美团篇)正确姿势是把每个角色的边际贡献单独测出来:拿掉 Checker,错误率变不变?拿掉独立的 Planner,规划质量变不变?测不出贡献的角色就合并回去。
反过来说,这些情况不要拆:任务步骤少且线性、工具一屏装得下、没有需要独立验收的环节。拆分是手段,不是架构审美。
容错是调试难度的具体表现之一:单 Agent 失败,翻一条轨迹就能定位;多 Agent 失败,可能是 Executor 没做对,也可能是 Planner 给的任务卡有歧义,还可能是共享状态被并发写坏。百度篇考过一道很实际的题:「一个并行分支失败而其他分支成功时,汇总节点应如何处理?」(AgentAlpha 面试题库 · 百度篇)工程答案是先保住部分成功的结果,失败分支走重试或降级,最后在汇总层做一致性检查,而不是整单重来。
面试怎么答 / 要点复盘
30 秒版本:拆分的动因是上下文隔离和职责清晰,不是数量崇拜;经典切分是 Planner、Executor、Checker;拆完要管住三件事——消息协议防信息损失、共享状态防版本混乱、成本账按每个角色的边际贡献来算。
容易被扣分的说法:开口就是“多 Agent 协作更智能”——协作不产生智能,只产生分工;说不出每个角色怎么单独评测,也说明没有真正维护过多 Agent 系统。
追问预测:「如何发现多 Agent 系统中的循环委派、任务重复和责任漂移?」答法:在轨迹层做监控——按任务 ID 跟踪委派链路、对委派图做环检测、把每个角色的工作量和产出定期对账。
要点复盘:
- 拆分的两个真实动因:上下文稀缺、角色冲突。
- 消息协议用结构化字段保关键信息,共享状态库当唯一权威版本。
- 每个角色要能单独评测,测不出边际贡献就合并。
参考答案要点
单 Agent 拆成多 Agent,动因是两个工程约束:上下文窗口有限,工具说明和任务历史会互相挤压;一个提示词管规划、执行、校验,角色会串。拆成 Planner、Executor、Checker 之后上下文隔离了,但引入通信和一致性成本,所以任务指派用结构化协议、关键结论写共享状态库、每个角色单独测边际贡献。最常见的坑是“为了拆而拆”:流程简单的任务拆出五六个 Agent,成本翻几倍,收益测不出来。收在边界上:工具少、流程线性就别拆——拆分永远服务于隔离和验收,不服务于架构好看。