一个真实的时间线:RAG 系统上线时,检索段延迟控制得很好,团队很满意。半年后,同样的查询要等明显更久;一年后,高峰期开始超时。期间没有人动过链路代码——动的是数据:文档量翻了不止一倍,增量导入跑了几百次,reranker 候选数为了效果从几十条加到上百条。
「越用越慢」很少是单一 bug,是每个当时都合理的小决定叠加出的系统性退化。反向调优的关键不是知道多少种优化手段,而是按正确顺序排查。
先给一个能复述的答案
RAG 变慢的来源随规模转移:索引膨胀让图搜索路径变长,数据倾斜和脏数据让无效搜索变多,缓存命中率随长尾查询占比升高而下滑,重排候选数随质量要求一路加码。排查按固定顺序:先分段埋点确认哪段退化,再查索引(规模、参数、分区),然后查数据(重复、倾斜、冷热),最后查缓存和重排。每次只动一个变量,动完用同一套评测集验证。
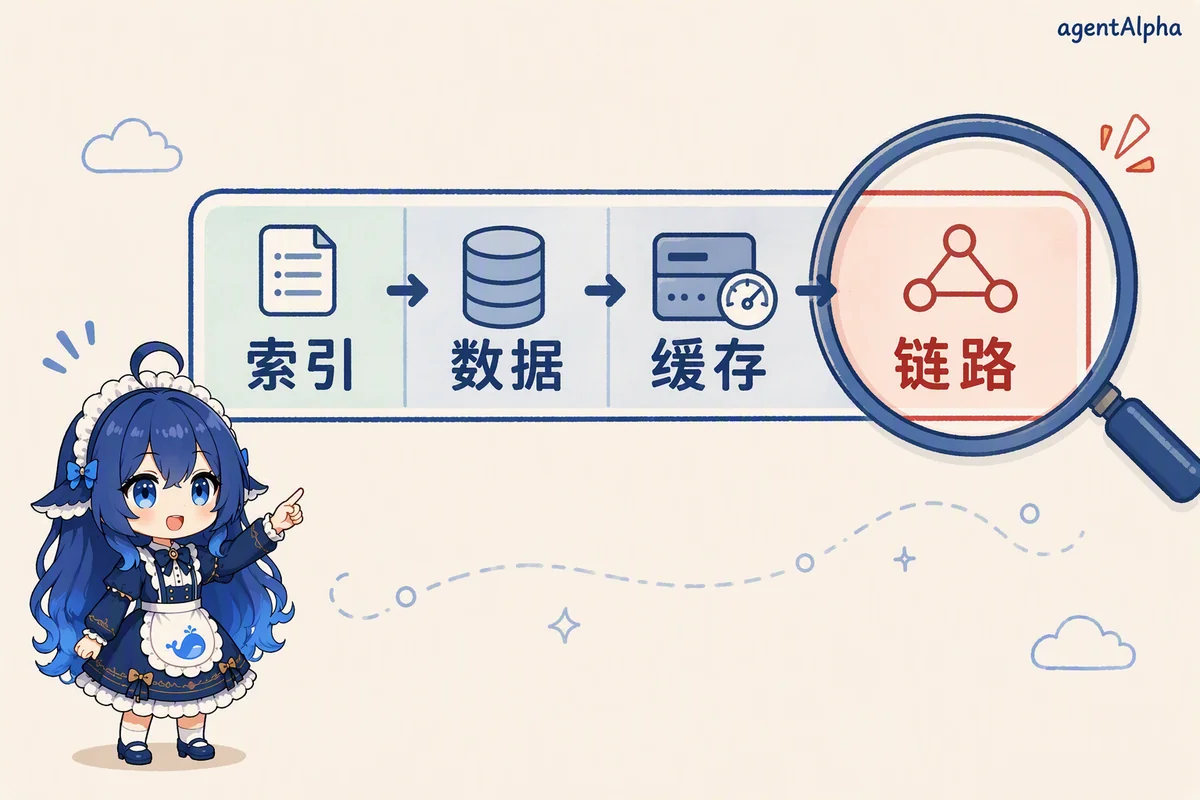 图:小蓝图解——退化四格:按顺序排查,别平均用力。
慢不是常数,是随规模恶化的函数
| 阶段 | 主导因素 | 典型症状 | 第一刀切哪里 |
|---|---|---|---|
| 上线期 | 配置不当 | 从第一天就慢 | 分段埋点,找配置错误 |
| 成长期 | 索引膨胀 | 检索段延迟缓慢爬升 | 分区、重建索引、重标参数 |
| 成熟期 | 数据倾斜 + 缓存退化 | 高峰期抖动,长尾查询拖垮整体 | 冷热分层、缓存治理 |
| 后期 | 重排与生成成本失控 | 延迟和成本一起涨 | 候选数回收、上下文瘦身 |
四个阶段不严格串行,但退化的大方向一致:先慢在检索,再慢在数据,最后慢在链路后端。
索引膨胀:HNSW 参数的取舍开始变味
主流向量库的索引大多是 HNSW(分层可导航小世界图):向量被组织成多层图,上层稀疏、负责快速远距离导航,底层稠密、负责精细搜索。
三个参数决定它的行为。M 是每个节点保留的连边数,边越密图越好走、召回越稳,但内存和搜索开销越高;efConstruction 控制建图时的候选队列长度,决定图建得结不结实;efSearch 是查询时的候选队列长度,直接决定单次查询要探索多少节点。
库小的时候,默认参数毫无压力。库大了之后,两件事开始变味:
其一,同样的 efSearch 覆盖不住了。图变大后,固定的候选队列能探索的比例下降,要么调大 efSearch(延迟上涨),要么接受召回下滑。这个取舍必须用评测集重新标定,而不是沿用上线时的值。
其二,增量插入让图结构劣化。HNSW 对批量建库友好,对长期高频的增量更新不友好——删除留下空洞,插入让局部密度失衡,同样的参数下召回悄悄下降。工程对策是定期全量重建索引,配合新索引预热、原子切换流量。
AgentAlpha 面试题库 · 腾讯篇 RAG 部分的真题「向量数据库了解过吗,常见向量索引的实现细节」,答到最后一定要落在这组参数的取舍上,这才是面试官想听的部分。
 图:HNSW 的多层图结构(上层节点更少、连线更长,搜索从顶层出发逐层下降缩小范围,把全库暴力比对的开销降到对数级别——向量库毫秒级召回的基础)
数据侧:慢的一半,花在没必要查的东西上
索引膨胀还有一个更隐蔽的推手:数据本身。
重复内容霸占索引容量。爬虫页面、模板化文档、同一份材料的多个版本,都以向量的形式住在库里。它们不带来信息,却让每次搜索穿过更多节点,还在结果里刷屏。去重瘦身往往能让索引规模降一截,这一步的收益比调任何参数都直接。
数据倾斜拖垮共享资源。多租户系统里,一个超大租户的查询会占掉检索集群的算力,表现为其他租户的延迟跟着抖动。对策是配额与隔离:大租户独立分区,查询加并发上限。
冷热分布被忽略。绝大多数查询集中在最近更新的文档上,但索引对所有文档一视同仁。冷热分层——热数据用高性能索引,冷数据走低成本检索——是规模化之后的必选项。
AgentAlpha 面试题库 · 阿里篇系统设计部分问过:「线上成功率突然下降时,怎样按版本、租户、模型和工具快速归因?」同样的按维度归因思路用在延迟上:把 P95 按租户、分区、时间段切开看,倾斜问题会立刻现形。
! 图:越用越慢不是单一 bug,是索引、数据、缓存几处慢性失血的叠加——先分段埋点确认退化位置,再按顺序下刀。
缓存与重排:后端的两处慢性失血
缓存命中率会自然下滑。上线初期查询高度集中,精确缓存躺着命中;用户规模上来后,长尾查询占比升高,命中率回落是正常现象。要做的是收紧归一化、给高频前缀做语义缓存灰度,并接受命中率有上限——别为了拉命中率放宽 key,那是在重蹈越权和陈旧的覆辙。
重排成本随质量要求一路加码。为了压 badcase,reranker 候选从几十条加到上百条,每次加码单独看都合理,累计起来重排段延迟翻了几倍。要定期回收:用评测集验证「砍回一部分候选,质量指标掉不掉」,多数系统能砍掉两成左右候选而效果基本不动。
一张按顺序执行的排查清单
被告知「系统变慢了」,按这个顺序走:
- 分段埋点对比:拿当前 P95 和历史基线比,确认是哪一段退化,不靠猜。
- 索引体检:规模曲线、efSearch 是否被改过、距上次全量重建多久、删除标记比例。
- 数据体检:重复内容占比、最大租户的查询份额、冷热分布。
- 缓存体检:三层命中率曲线,陈旧投诉是否同步上升。
- 重排体检:候选数量 × 单条耗时,对比历史配置。
- 生成体检:注入上下文的总长度曲线,确认不是检索结果越塞越多。
每一步只动一个变量,动完跑同一套评测集。AgentAlpha 面试题库 · 腾讯篇系统设计部分有一道相邻的题:「用户量从 100 增长到 10 万时,Agent 服务的主要扩展瓶颈在哪里?」——它和「越用越慢」考的是同一种能力:说清楚瓶颈如何随规模转移。
面试现场:追问怎么接
「为什么不直接加机器?」 扩容买回来的是吞吐,不是退化修复。索引结构劣化、参数失配这些问题,加机器只是把爆发点往后推,成本曲线还在原地。
「多久重建一次索引?」 不按时间定,按指标定:监控删除标记比例和召回抽检值,劣化到阈值就重建。固定周期重建是在为省心付浪费。
「反向调优和正向优化冲突吗?」 不冲突,顺序不同。正向优化面对「怎么更快」,反向调优面对「为什么变慢」。后者必须先归因再动手,跳过归因的优化经常把好配置改坏。
参考答案要点
- 越用越慢不是单一 bug:索引膨胀、数据倾斜、缓存命中率下滑、重排加码,四个因素随规模接力恶化。
- 排查按顺序:分段埋点找退化段,再依次体检索引、数据、缓存、重排、生成。
- 关键机制:HNSW 的 efSearch 要随库规模重新标定,增量插入会劣化图结构,定期重建加原子切换。
- 主动说坑:为效果悄悄加码重排候选,是延迟失控最常见的推手。
- 收在取舍:扩容买吞吐不修退化;先归因再动手,每次只动一个变量并用评测集验证。