RAG 检索增强
从文档到答案的整条链路:Embedding、分块、多路召回、重排、缓存与权限。答这类题要先说清链路分层,再讲每一层你踩过的坑。
本篇分类真题集
PICKED
本方向读法
LEARN PATH
本方向的取用顺序。要完整系统学,去主线课程第 1 章「RAG(检索增强生成)」(本方向归属章)。
先建立概念
8 个术语的一句话定义与机制,链到术语页。
刷透高频题
21 道速答题,每题一页:先这样答 → 面试官追问 → 回答的坑。下方题单收前 8 道,全部进分页列表。
深挖机制与选型
584 篇深度解析 + 6 篇对比选型,逐层拆到原理与工程取舍。
实战检验
项目面试包讲「项目怎么讲才扛住追问」;再按公司检验:五厂真题集。
速答题单
共 21 道
分类内题目
共 591 篇
教程深挖
深度解析与对比选型 · 8 篇
RAG 首字响应慢?把延迟拆到链路每一层去找
你们的 RAG 首字延迟(TTFT)怎么优化?
动态 RAG 的数据质量怎么评估:别让脏知识污染答案
动态 RAG 的数据质量怎么评估?
动态 RAG 的缓存体系怎么设计
动态 RAG 的缓存体系怎么设计?
RAG 为什么越用越慢?反向调优的排查顺序
为什么 RAG 越用越慢?如何反向调优?
RAG 检索真题 · 文本检索的指标了解哪些
文本检索的指标了解哪些?
RAG 检索真题 · 对于Qwen3模型中的embedding模型和Reranker模型,你有哪些了解?请分别介绍它们的结构特点、训练方式以及在相关任务中的表现
对于Qwen3模型中的embedding模型和Reranker模型,你有哪些了解?请分别介绍它们的结构特点、训练方式以及在相关任务中的表现?
RAG 检索真题 · Rag常见且chunk的方式有哪些?你用的是什么embedding
Rag常见且chunk的方式有哪些?你用的是什么embedding?
RAG 检索真题 · 向量数据库的embedding模型是什么?向量维度是
向量数据库的embedding模型是什么?向量维度是?
真题解析
宝典真题完整解析 · 576 篇 · 去真题库总览
RAG 生成阶段最常见的错误有哪些
面试官想看你能否跳出“RAG 就是检索+拼接”的浅层理解,系统性地诊断生成阶段的错误根因。考察类型是工程取舍 + debug,刁钻点在于:候选人常只背“幻觉”一个词,却分不清“模型编造”和“事实扭曲”的底层机制差异。答好
RAG 评测集应该怎么构建
面试官想考察你构建 RAG 评测集的系统性思维,而非简单罗列指标。这属于系统设计 + 工程取舍类型。刁钻点在于:评测集不是一次性产物,而是需要覆盖检索、生成、端到端三个环节,并兼顾覆盖度、标注质量和迭代机制。答好了能展示
一个 Demo 版和生产版最大的差别是什么
面试官想看的不是“Demo 简单、生产复杂”这种废话,而是你能否从系统设计角度拆解差异,并给出具体工程取舍。这是典型的系统设计 + 工程取舍题,刁钻点在于:Demo 往往跑通即可,生产版要扛住数据规模、延迟、可靠性、成本
一个 RAG 错误,怎么判断到底是“没召回到”还是“召回到了没用好”
面试官想看你是否具备系统化的 RAG 错误定位方法论,而不是凭直觉瞎猜。这是典型的“工程取舍 + debug”题,刁钻点在于:很多人只会说“看召回结果”,但不知道如何量化“没召回到”和“没用好”的边界。答好了能展示你懂检
一个能上线的 RAG 系统除了主链路,还需要哪些工程能力
面试官想考察你是否具备“从算法 demo 到生产级系统”的工程视野,而非仅会调 RAG 主链路(检索+生成)。刁钻点在于:多数候选人只提“加缓存、加监控”这种泛泛概念,但说不出具体实现、取舍和坑。答好了能展示你对系统稳定
为什么 RAG 调优必须建立问题分类和误差归因机制
面试官想考察你是否具备系统化调试 RAG 系统的工程思维,而非只会调参或换模型。这题属于系统设计 + 工程取舍类型,刁钻点在于:很多人一上来就调 chunk size 或换 embedding,但根本不知道问题出在检索还
为什么不能把 RAG 简单理解成“检索 + Prompt”
面试官想看你是否真正理解 RAG 的工程本质,而非停留在“检索文档塞进 Prompt”的浅层认知。考察类型是工程取舍 + 系统设计。刁钻点在于:很多人把 RAG 等同于“向量数据库 + 大模型”,忽略了检索质量、上下文窗
为什么很多长上下文问题最终还是需要 RAG
面试官真正想看的是你对长上下文模型与RAG之间“互补而非替代”关系的工程化理解。这不是背概念题,而是系统设计取舍题。刁钻点在于:候选人往往只答“长上下文贵、RAG便宜”这种表面理由,但面试官想听的是具体场景下的量化权衡—
为什么生产 RAG 经常要把“检索用块”和“生成用块”分开
面试官想考察你对 RAG 系统“检索精度”与“生成质量”之间根本矛盾的认知深度。这不是背概念题,而是工程取舍与系统设计题。刁钻点在于:候选人能否跳出“块大小”的单一维度,理解检索和生成对上下文粒度的不同需求。答好了,能展
为什么知识库不只是“存内容”,还要管理权限和时效性
面试官想考察你对 RAG 系统“工程落地”而非“玩具 demo”的理解深度。这不是背概念题,而是系统设计题。刁钻点在于:多数候选人只讲“权限和时效性很重要”,但讲不清“为什么重要”背后的数据安全合规风险(如 GDPR、企
什么时候该换模型,什么时候该改 Prompt,什么时候该加 RAG
面试官真正想看的是你在 LLM 应用落地中的工程决策能力,而非背诵概念。考察类型是系统设计 + 工程取舍。刁钻点在于:候选人往往只会“先改 Prompt,不行加 RAG,再不行换模型”这种线性思维,但实际场景中成本、延迟
什么是分层检索(Hierarchical Retrieval)
面试官想考察你是否能跳出“平面切块+Top-K”的思维定式,真正理解长文档检索中结构利用的价值。这是典型的系统设计+工程取舍题,刁钻点在于:很多人只会背“先粗后细”的概念,但说不清层级粒度怎么选、索引如何建、检索效率与召
什么是多路召回(Multi-Retrieval)
面试官想看的不是“多路召回就是多个检索器一起用”这种定义,而是你能否在工程落地中平衡召回率、延迟、结果冗余这三个矛盾点。考察类型是系统设计 + 工程取舍。刁钻点在于:多数人只会背RRF公式,但说不清为什么RRF比加权求和
什么是纠错型 RAG(Corrective RAG / CRAG)
面试官想考察你是否理解RAG系统在真实落地中的“脆弱性”——检索结果质量不可控时,系统如何自救。这属于系统设计+工程取舍类型。刁钻点在于:很多人只会背“检索-生成”流水线,但CRAG要求你跳出流水线,思考评估-纠错-回退
向量检索是怎么找到相似内容的
面试官想考察你对向量检索全流程的工程化理解,而非背诵概念。核心看三点:① 是否清楚从“文本→向量→索引→搜索”的完整链路,而非只懂 Embedding;② 是否理解 ANN 索引(如 HNSW、IVF)的精度-速度 tr
如何优化召回率,如何优化准确率,它们为什么经常冲突
面试官想看你是否真正理解信息检索(IR)中召回率(Recall)与准确率(Precision)的底层矛盾,而非只会背概念。考察类型是工程取舍 + 系统设计。刁钻点在于:候选人常把“冲突”归因于“TopK大小”,但深层原因
如何做 RAG 的日志、观测和故障排查
面试官想考察你能否将 RAG 从“Demo 玩具”推向“生产系统”。这不是背概念题,而是工程取舍 + Debug 实战题。刁钻点在于:多数人只懂“加日志”,但不懂如何通过观测数据反推根因(如检索召回差 vs 生成幻觉的区
如果资源有限,RAG 应该优先做哪些能力
面试官想看你能否在资源受限(算力、内存、延迟预算)下,区分 RAG 系统的“核心生存能力”与“锦上添花功能”。这不是背概念题,而是工程取舍决策题。刁钻点在于:候选人常陷入“全都要”的完美主义,或盲目堆砌组件(如强行上重排
用户问题进入 RAG 后,第一步为什么往往不是直接检索
面试官想考察你对 RAG 流水线(pipeline)的系统设计思维,而非单纯背概念。核心是看你能不能跳出“检索即搜索”的直觉,理解查询理解(Query Understanding) 作为前置步骤的必要性。刁钻点在于:用户
知识库更新后,索引为什么不能只靠全量重建
面试官想考察你对 RAG 系统索引维护的工程落地能力,而非单纯背概念。刁钻点在于:全量重建看似简单可靠,但在生产环境中会暴露计算成本、延迟、服务可用性三大硬伤。答好了能展示你对向量数据库、CDC(变更数据捕获)、增量更新
.项目里的 Modular Agent ,你能讲讲它是如何实现多步规划的吗
面试官想考察你对模块化 Agent 架构中“规划”模块的工程实现细节,而非仅仅背诵 ReAct 流程。这是 P1 进阶题,刁钻点在于:区分“简单 ReAct 循环”与“真正的多步规划”——前者是 LLM 在每一步随机应变
13|Agent+RAG 系统在实际应用中常见的挑战有哪些?如何解决
面试官想考察你对 Agent+RAG 系统从“Demo 玩具”到“生产级系统”的工程化认知深度。这不是背概念题,而是系统设计 + 工程取舍题。刁钻点在于:候选人常只罗列“检索不准、Agent 乱跑”等表面问题,但面试官真
BM25 和向量检索分别擅长解决什么问题
面试官想看你是否真正理解两种检索范式的本质差异,而非停留在“BM25 是关键词,向量是语义”的表面。刁钻点在于:你是否知道 BM25 的稀疏性在哪些场景下是优势而非缺陷?向量检索的“语义”在长尾、低频、专有名词上会失效。
RAG 和传统搜索、微调分别是什么关系
面试官想看你是否真正理解 RAG 的定位,而非只会背概念。这道题属于系统设计对比类,刁钻点在于:很多人把 RAG 简单等同于“搜索+生成”,或认为微调可以完全替代 RAG。答好了能展示你对技术选型的工程判断力——知道什么
Top K 应该怎么设
面试官想考察的不是“背一个数字”,而是工程取舍的量化思维。这道题属于超参数调优 + 系统设计混合型,刁钻点在于:Top K 不是孤立参数,它直接串联召回率、LLM 上下文窗口、推理延迟和成本。答好了能展示:① 懂用 Re
为什么 Metadata 对 RAG 很重要
面试官想看的不是你会不会给文档打标签,而是你是否理解元数据在RAG整条链路中扮演的“信号放大器”和“过滤器”双重角色。考察类型是系统设计+工程取舍。刁钻点在于:多数人只提“过滤”,忽略了元数据对检索质量、排序权重、可解释
为什么不是所有问题都值得微调
面试官想考察你是否具备成本意识和技术选型决策能力,而非只会堆砌技术。这是一个典型的工程取舍问题,刁钻点在于:很多人一遇到问题就喊“微调”,却忽略了微调的高昂成本、维护负担和潜在风险。答好了能展示你不仅懂微调原理,更懂何时
为什么原始提问经常不适合作为最终检索词
面试官想考察你对 RAG 系统“查询理解”环节的工程敏感度,而非单纯背诵概念。刁钻点在于:很多人以为“用户问什么就搜什么”,但实际落地中,原始查询往往因口语化、歧义、上下文缺失或意图漂移,导致检索召回率暴跌。答好了能展示
为什么很多 RAG 系统要求模型“只基于提供材料作答”
面试官想看你是否理解 RAG 系统“约束模型行为”背后的工程动机,而非背诵“防止幻觉”这种表面答案。核心考察点:你是否能区分“模型知识”与“检索上下文”的冲突场景,并解释为什么在知识密集型任务(如法律、医疗)中,允许模型
为什么很多企业场景仍然会保留传统搜索入口
面试官想考察你是否理解RAG在工业界的真实落地困境,而非只会吹捧新技术。这是典型的“工程取舍+系统设计”题,刁钻点在于:很多人会答“传统搜索更稳定”,但说不出具体数字和场景。答好了能展示你对生产级系统的务实认知——知道何
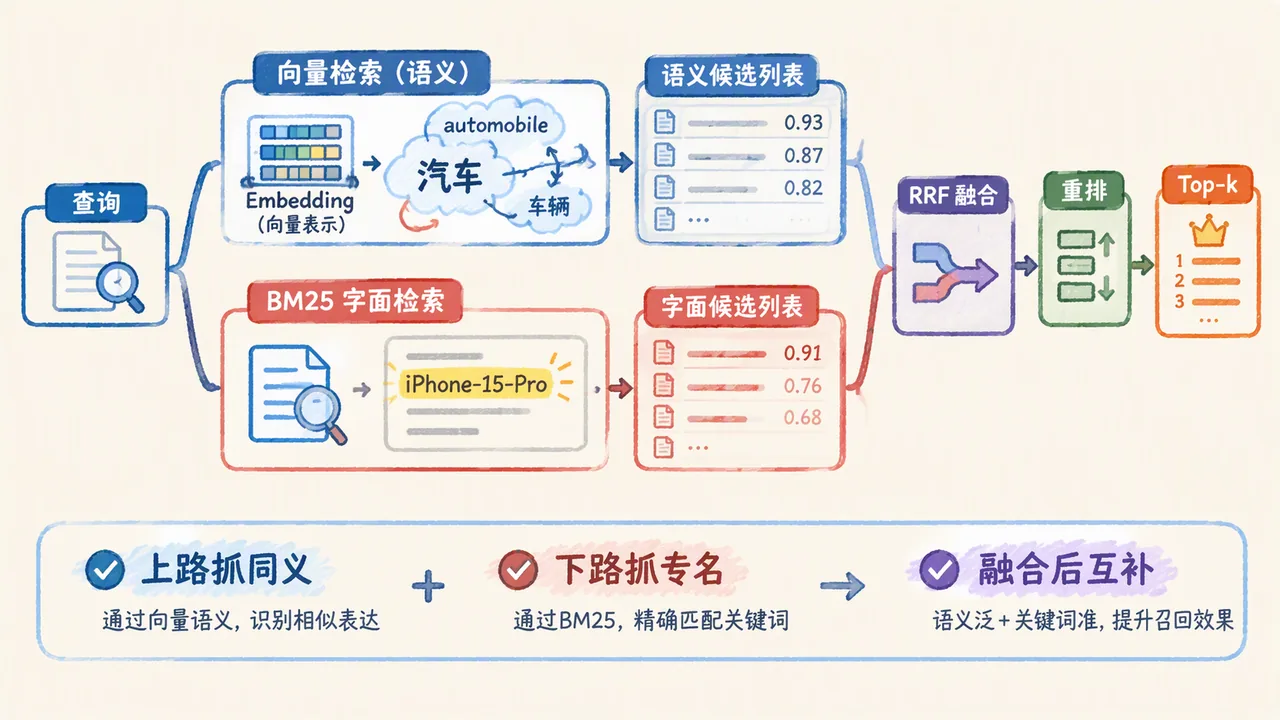
为什么很多生产系统都用混合检索
面试官想考察你对检索系统在真实生产环境中的工程理解,而非单纯背诵概念。核心是看你能不能跳出“混合检索就是BM25+向量”的浅层认知,从鲁棒性、覆盖率、成本三个维度解释为什么单一方法不够用。刁钻点在于:你必须指出混合检索不
为什么很多问题表面看是模型问题,本质上却是数据或检索问题
面试官想看你是否具备RAG系统的“故障诊断”思维,而非只会调模型参数。考察类型是工程取舍+debug,刁钻点在于:候选人常把“模型回答错误”归因于模型能力不足,而忽略了检索召回率低、数据噪声大等上游问题。答好了能展示你系
为什么知识质量往往比模型参数更影响 RAG 效果
面试官想验证你是否真正理解 RAG 系统的“木桶效应”——不是考察你背过“数据重要”这个结论,而是看你能不能从检索、生成、评估三个环节拆解出“为什么知识质量是短板”。刁钻点在于:很多人会笼统说“数据好模型才好”,但说不出
为什么索引质量会直接决定后续召回质量
面试官想考察你对 RAG 系统“数据输入决定输出上限”这一核心原则的理解深度。这不是背概念题,而是工程取舍与系统设计题。刁钻点在于:候选人常把“召回质量差”归因于模型或 embedding,却忽略索引是召回的唯一候选集来
什么是路由检索(Router Retrieval)
面试官想考察你对“动态检索策略”的理解深度,而非仅仅背诵概念。核心是看你能否设计一个路由决策机制,在查询意图、数据源异构性、延迟成本之间做工程取舍。刁钻点在于:路由本身是一个“元任务”,其准确率直接影响下游检索效果,且路
什么时候值得加 Reranker
面试官想考察你对 RAG 系统“成本-收益”的工程判断力,而非单纯背诵 Reranker 原理。刁钻点在于:候选人常无脑推荐 Reranker,却忽略其带来的延迟、计算成本和维护复杂度。答好了能展示你具备系统级优化思维—