知识库负责人的日常:每天有新政策文档、新工单、爬取的网页入库。某天客服 Agent 引用了一条已经废止的旧规则,用户拿着错误答案来投诉。查监控:链路指标全部正常,那条旧规则的检索相似度分还挺高。
问题不在链路,在喂给链路的数据。动态 RAG 的数据质量,不能靠链路指标来保证。
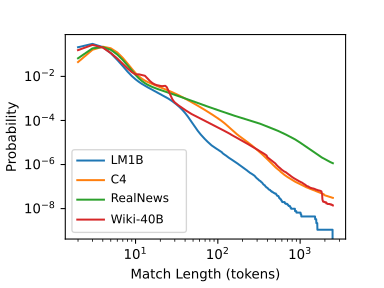 图:C4 数据集做近重复检测后的簇大小分布(横轴是重复簇的大小,最大的一簇多达 25 万条几乎相同的页面——网络内容的重复远比想象中严重,不去重就会反复喂给模型)
先给一个能复述的答案
动态知识库的数据质量要在两个时间点评估:入库前,用去重(SimHash / MinHash)、质量分、来源权威度和时效标注,把脏数据挡在门外;入库后,用引用命中率、答案归因和冲突扫描,从答案表现反推数据问题。再配一套持续更新的评测集,把每次「检索正常但答案错误」的案例沉淀下来。只看检索相似度,发现不了脏数据。
 图:小蓝图解——数据质量:先筛掉脏数据,再谈评估。
「动态」二字,让数据质量问题变了形
静态知识库像一本书,排版错了改一次就好;动态知识库像一条每天有人往里倒货的传送带,问题天天以新形态出现。三类麻烦是动态库特有的:
时效冲突:一条规则更新后,旧版本没有被清退,新旧两个版本同时在库里,都能被检索召回。答案引用哪个,全看相似度运气。
重复:同一条知识以不同表述出现在多个文档里,检索时重复片段霸榜,挤掉真正有用的多样化证据。
来源可信度参差:官方文档、内部工单、论坛帖子混在一个库里,在向量空间里它们看起来一样可信。
AgentAlpha 面试题库 · 阿里篇把这个问题直接写进了真题:「商品规则频繁变化时,如何实现知识增量更新、版本治理和过期清退?」版本治理和过期清退,就是针对时效冲突的正面回答。
| 问题 | 典型症状 | 检测信号 | 处理手段 |
|---|---|---|---|
| 时效冲突 | 引用了废止的旧规则 | 同一实体多版本并存 | 版本号、生效日期、旧版本清退 |
| 重复 | 检索结果同质化 | 近似重复片段占比 | SimHash / MinHash 去重 |
| 来源不可信 | 引用论坛错误说法 | 来源分级统计 | 权威度加权与过滤 |
入库前:把脏数据挡在门外
去重分两层。精确重复用内容哈希,一行代码解决;麻烦的是近似重复——同一段话改了几个字、换了标点。工程上常用 SimHash(把文档压成一个指纹,指纹接近即视为近似重复)和 MinHash(用集合的随机签名估计两两相似度,适合大规模比对)。
预训练领域对这件事有过系统研究:Deduplicating Training Data Makes Language Models Better发现,语料里的重复内容会让模型更倾向于背诵原文,去掉重复后,同样的训练量能换来更好的结果。知识库是同一个道理:重复片段占用索引容量,还会在检索时挤占名额。
质量分拦的是结构性垃圾:过短碎片、乱码、截断的段落、没清洗干净的页眉页脚和导航文字。这些内容语义上可能还真有点相关,喂给模型只会制造噪声。
权威度在入库时写进元数据:官方文档给高权重,内部工单中等,论坛帖子最低。检索时它可以做过滤,也可以做加权,冲突时还能当仲裁依据。
时效标注是动态库的生命线:每条知识带生效日期、版本号和替代关系。没有这三个字段,后面所有的冲突处理都无从谈起。
入库后:用答案表现反推数据质量
入库前的规则挡得住已知形态的脏数据,挡不住所有问题,所以还要从答案这一端往回看。
引用命中率:答案声称引用的知识里,有多少真的能在知识库里找到原文。命中率低,说明模型在编,或者检索根本没找对。
答案归因:把答案里的关键论断逐条定位回具体片段。定位不回去的论断,要么删掉,要么标记待核实。归因让「数据质量有问题」从一种感觉变成一条证据。
冲突扫描:定期对同一实体拉出所有版本,检查数值、规则、日期是否互相矛盾;线上则观察同一问题在不同时间的答案是否稳定。
AgentAlpha 面试题库 · 腾讯篇有一道综合题:「如何处理检索证据冲突、过期和权限不一致的问题?」答题时,冲突仲裁的依据正是入库时写下的权威度和时效标注——前后两个阶段是在同一套元数据上接力的。
评测集:建一次吃老本,很快就会失真
很多人把评测集当成上线前的验收工具,建一次用到底。动态知识库里,评测集必须跟着数据一起更新,否则评测结果会越来越乐观,越来越假。
构建方法:从真实查询日志采样,高频问题和失败案例优先;按题型分层覆盖——事实型、规则型、多跳推理型;最值钱的素材是「检索正常但答案错误」的案例,它精准暴露数据质量问题,每一个都应该回流进评测集。
评测维度上,AgentAlpha 面试题库 · 字节篇问过:「如何构造 RAG 离线评测集?检索和生成分别用哪些指标?」对应到数据质量:检索端看该召回的新版本有没有被召回,生成端看答案有没有引用过期内容。
配套机制也要固定下来:新知识批量入库前跑一遍评测集,确认没有把检索结果整体拉偏;每次知识库版本升级,评测报告随版本一起归档,出问题时才有对照基线。评测集不更新、不归档,等于没有评测。
三个常见的坑
坑一:只看相似度分。脏数据的相似度分可以非常高——重复片段、过时文档往往和查询措辞最接近。相似度衡量「像不像」,不衡量「对不对」。
坑二:去重下刀太狠。不同文档里相似的条款,可能服务不同场景、不同客群。该去掉的是完全等价的重复,语境不同的相似内容应该保留并归并管理,直接删除会误伤。
坑三:权威度一刀切。论坛帖子天然低权重,但规则刚变更时,论坛讨论可能比还没来得及更新的官方文档更及时。权威度要和时效放在一起看。
面试现场:追问怎么接
「数据质量问题和检索问题怎么区分归因?」 先用标注集离线区分召回失败、重排失败和生成失败;三层都正常时,问题大概率在数据本身,再做归因扫描。
「评测集多久更新一次?」 跟着数据更新节奏走。知识库每次大版本变更,评测集同步补充对应案例,否则评测会系统性偏乐观。
「怎么说服团队投入做数据质量?」 拿归因数据说话:统计坏答案里有多少比例能追到数据问题,这个数字比任何论述都有力。
参考答案要点
- 动态 RAG 的数据质量分两个时间点评估:入库前挡,入库后看答案反推。
- 入库前四件事:去重(SimHash / MinHash)、质量分、来源权威度、时效标注。
- 入库后三件事:引用命中率、答案归因、冲突扫描;评测集跟着数据持续更新。
- 主动说坑:相似度高不代表数据对;去重不能误伤语境不同的相似内容。
- 收在取舍:清退旧版本控制污染,但保留版本历史,冲突仲裁才有依据。