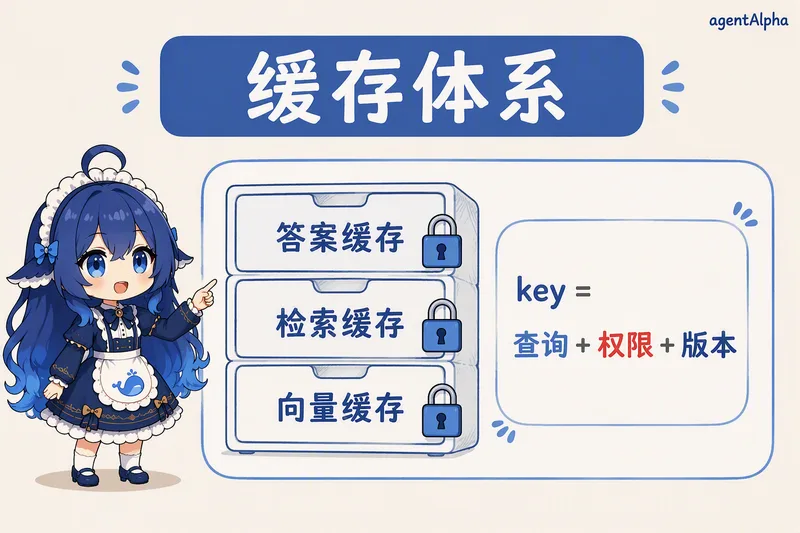
给知识库系统加缓存的第一周,延迟指标好看到让人怀疑是不是哪里做错了。第二周,事故来了:A 部门的用户在检索结果里看到了 B 部门才该看到的内部文档片段。
排查结论:缓存 key 里只有查询文本,没有租户和权限维度。两个部门的人问了同一个问题,第二个人直接拿到了第一个人缓存的结果。
缓存是 RAG 系统里收益最高、也最容易出事故的组件。设计缓存体系,本质是在回答三个问题:缓存什么、key 怎么定、什么时候失效。
先给一个能复述的答案
动态 RAG 的缓存要分三层设计:Embedding 缓存、检索结果缓存、答案缓存,越往上收益越大、风险也越大。缓存 key 必须同时包含归一化查询、租户与权限维度、知识库版本号。失效策略用「TTL 兜底 + 写入时主动失效 + 版本号切换」组合。动态知识库里,缓存最大的两个风险不是失效不及时,而是越权和返回陈旧内容。
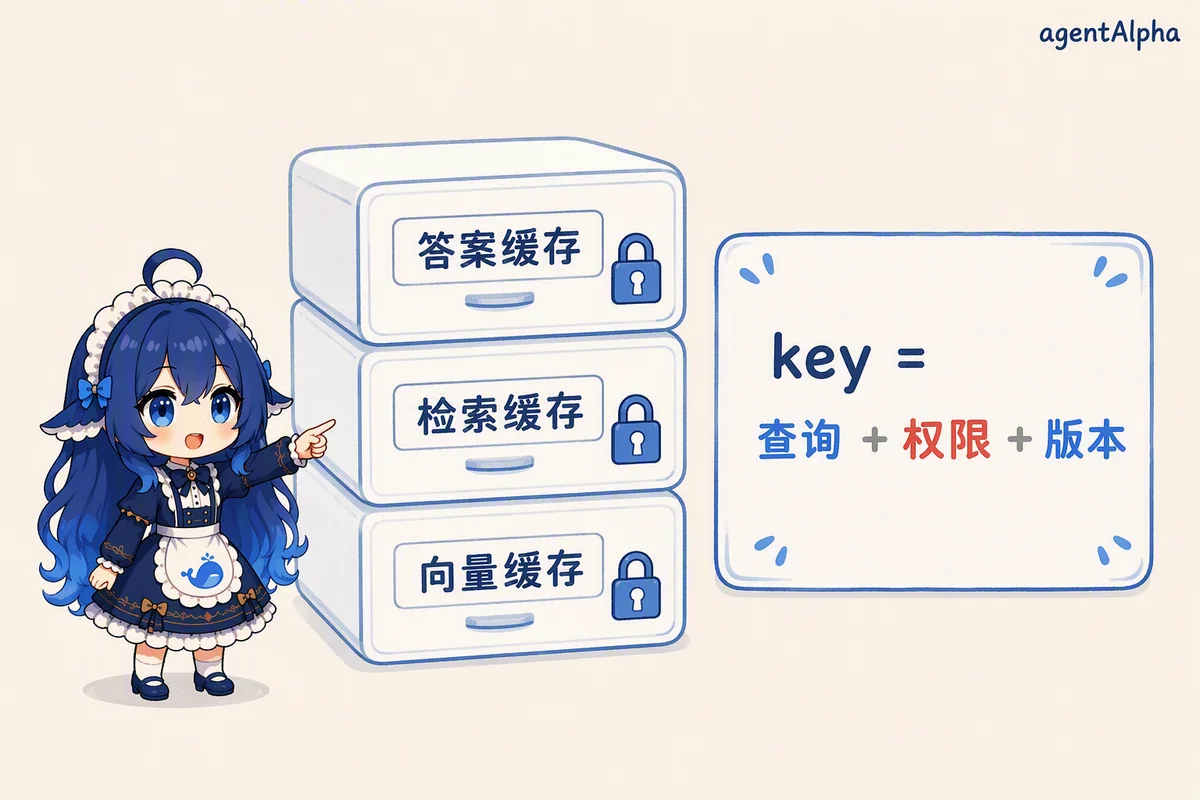 图:小蓝图解——三层缓存各挂一把锁:key、版本、权限。
先分清缓存什么:三层缓存,三套命门
| 层级 | 缓存内容 | 收益 | 失效敏感度 | 主要风险 |
|---|---|---|---|---|
| Embedding 层 | 查询文本 → 向量 | 省一次模型推理 | 低,不依赖库内容 | 几乎没有 |
| 检索层 | 查询 → 文档 ID 列表 | 省整条检索链路 | 高,随库变更失真 | 返回已删除或已过期内容 |
| 答案层 | 查询 → 最终答案 | 省全部计算 | 最高 | 越权、陈旧、串上下文 |
Embedding 层最安全,可以放心放大命中率。检索层和答案层都绑着知识库的当前状态,库一动,缓存就从加速器变成污染源。
分层想清楚,剩下的问题就变成每一层的 key 怎么定、失效怎么做。
缓存 key:设计错了,后面全是事故
key 设计分两步。
第一步是查询归一化:「退货 政策」「退货政策」「退货政策。」在用户眼里可能是同一个问题。大小写、空白、全半角、标点先统一,再做缓存查找。归一化做得越充分,命中率越高,但要小心别把语义不同的查询归并到一起。
归一化之上还有一个更激进的选择:语义缓存——新查询和某个缓存过的查询向量足够接近时,直接复用旧答案。它的分界线要划清楚:FAQ 型、答案对措辞不敏感的查询敢用;查询里出现数字、金额、条款编号时不敢用,差一个数字就是两个问题。
第二步是权限与版本维度,这也是最容易漏的。完整的 key 至少长这样:
hash(归一化查询) + 租户/权限组 + 知识库版本 + 检索参数(top_k、过滤器)
漏掉权限维度,就是开头那个事故;漏掉版本号,知识库更新之后用户会持续拿到旧内容。
AgentAlpha 面试题库 · 字节篇把这一点出成了真题:「如何实现文档级、段落级权限过滤,并防止缓存导致越权?」这题的坑就在「缓存导致越权」半个句子里——检索链路本身做了权限过滤,缓存层把它绕过去了。
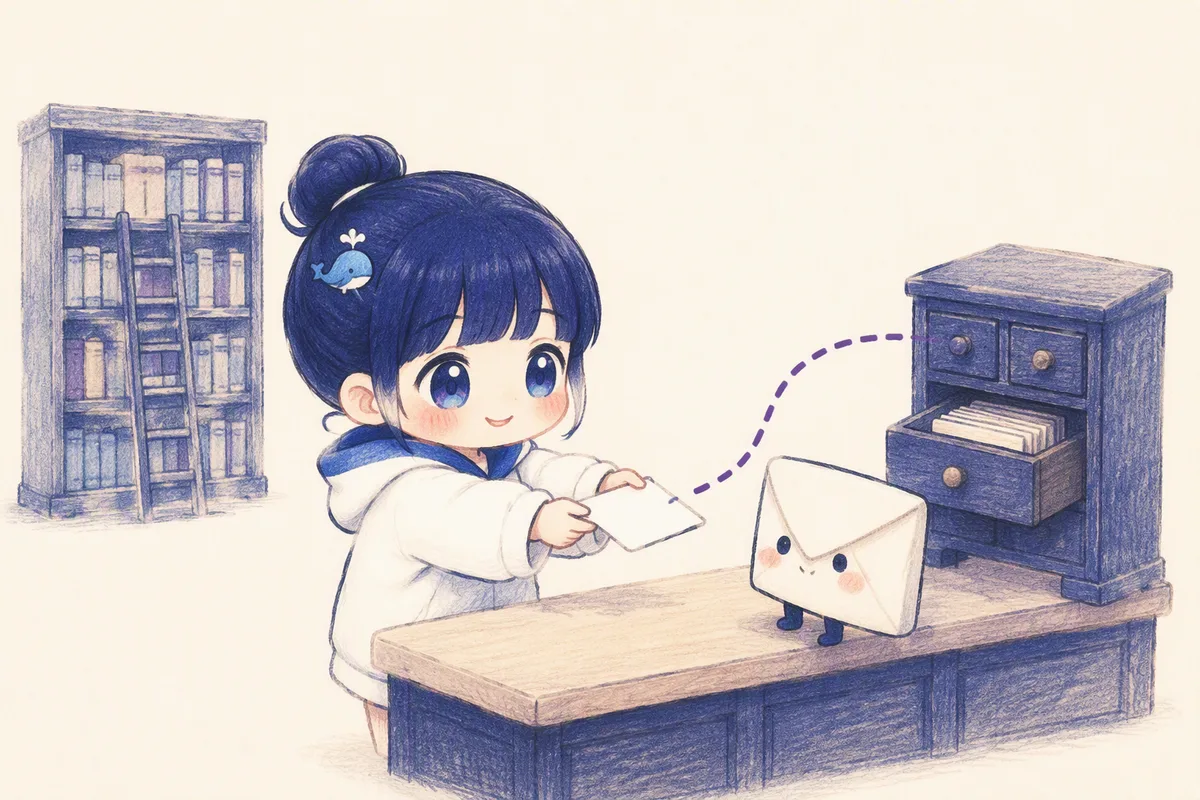 图:缓存就是那个近处的小柜子——请求先查柜子,未命中才去后面的大书架;权限校验在任何一层都不能跳过。
失效策略:动态库的缓存一致性
动态知识库每天在变,失效策略用三条腿走路:
TTL 兜底:给所有缓存设过期时间,保证没有任何内容会无限期存活。TTL 定多长,取决于知识库的更新频率和对陈旧的容忍度。
写入时主动失效:文档更新或删除时,按文档 ID 反查受影响的缓存条目,精确删除。这要求缓存条目记录「由哪些文档产生」,反向索引有维护成本,但答案层值得做。
版本号切换:知识库版本号直接进 key。索引全量重建或大版本升级时切到新版本号,旧缓存整体自然作废,不用逐条清理。配合「新版本预热后再切流量」,用户感知不到切换。
AgentAlpha 面试题库 · 字节篇的真题「知识库频繁增量更新时,如何保证索引、缓存和在线服务版本一致?」问的就是这套组合:索引、缓存、服务三者用同一个版本号对齐,任何时刻只有一套版本在服务流量。
还有一类容易被忽略的删除:用户行使删除权时,向量库里的数据删了,缓存里的派生数据也要同步删。AgentAlpha 面试题库 · 阿里篇 Memory 部分专门考过:「用户要求删除个人信息时,向量库、缓存、日志和备份怎样同步删除?」缓存不在删除链路里,就是合规漏洞。
权限与缓存:必考的越权问题
防缓存越权的做法值得单独展开,因为它是面试必考点,也是真实事故高发区:
做法一:权限进 key。最直接,但 key 维度越多命中率越低。折中方案是用「权限组」而不是单个用户:同组用户共享缓存,命中率损失小,越权风险可控。
做法二:缓存文档 ID,不缓存内容。缓存层只存「这个问题该查哪些文档」,返回用户前每一篇重新过一遍权限过滤。牺牲一点延迟,换确定性的安全。
做法三:答案缓存默认关闭,只对公开内容开启。涉及个性化、权限敏感的查询,答案层直接不缓存。这是最保守、也是生产环境最常见的选择。
三种做法是安全与命中率之间的连续光谱,按业务敏感度选位置,而不是追求单一最优。
命中率怎么养:别让缓存变成摆设
缓存上线只是开始,命中率要靠埋点慢慢养:
- 三层命中率分开统计,答案层单独看权限维度的命中分布。
- 归一化太弱(连大小写都没统一)和 key 维度太细(精确到单个用户),是低命中的两大主因。
- 语义缓存先上灰度:开影子模式,只记录「本可以命中」的查询并对比新旧答案,人工抽检一致后再放真实流量。
AgentAlpha 面试题库 · 腾讯篇的推理部署部分考过「连续批处理、投机解码和 Prefix Cache 分别适合什么流量模式」——同一道题背后是同一个意识:不同缓存机制适合不同流量形态,答缓存必答流量特征。
面试现场:追问怎么接
「语义缓存和精确缓存的边界怎么定?」 看查询里有没有不可容错的部分。有数字、编号、专有名词的查询走精确缓存;开放问答、措辞多变但答案收敛的查询才开语义缓存,且必须配相似度阈值和答案一致性抽检。
「缓存命中率越高越好吗?」 不是。命中率上升如果伴随陈旧投诉上升,说明失效策略跟不上,宁可降命中率也要保内容正确。
「多租户场景最大的坑是什么?」 默认全局缓存。任何缓存层,只要 key 里没有租户维度,出事只是时间问题。
参考答案要点
- 动态 RAG 缓存分三层:Embedding、检索、答案,越往上收益越大、风险越高。
- key 三要素:归一化查询、权限维度、知识库版本号;漏权限是越权事故,漏版本是陈旧内容。
- 失效用 TTL 兜底加写入时主动失效,大版本切换用版本号让旧缓存整体自然作废。
- 主动说坑:缓存层绕过检索链路的权限过滤,是必考的越权场景;用权限组或只缓存文档 ID 来防。
- 收在取舍:key 维度越细越安全但命中率越低,按业务敏感度在光谱上选位置。