面试进行到系统设计环节,面试官问:「你们的 RAG 首字延迟怎么优化的?」
最常见的回答是「并发调用」「缓存 Embedding」「多加几张 GPU」。这些说法都沾边,但暴露了一个事实:没有对着监控面板,真正找过一次延迟花在了哪里。
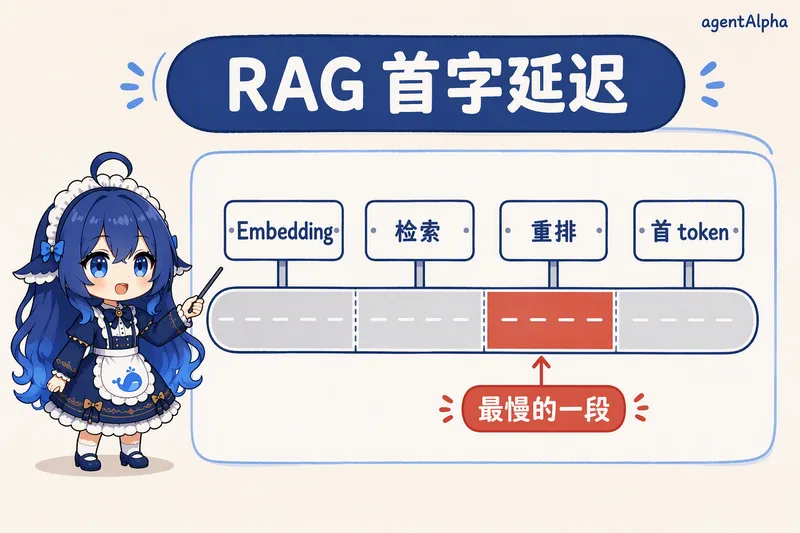
首字延迟不归任何单一层管,它是链路上四段延迟的累加。想优化它,第一步不是动手,是拆开测量。
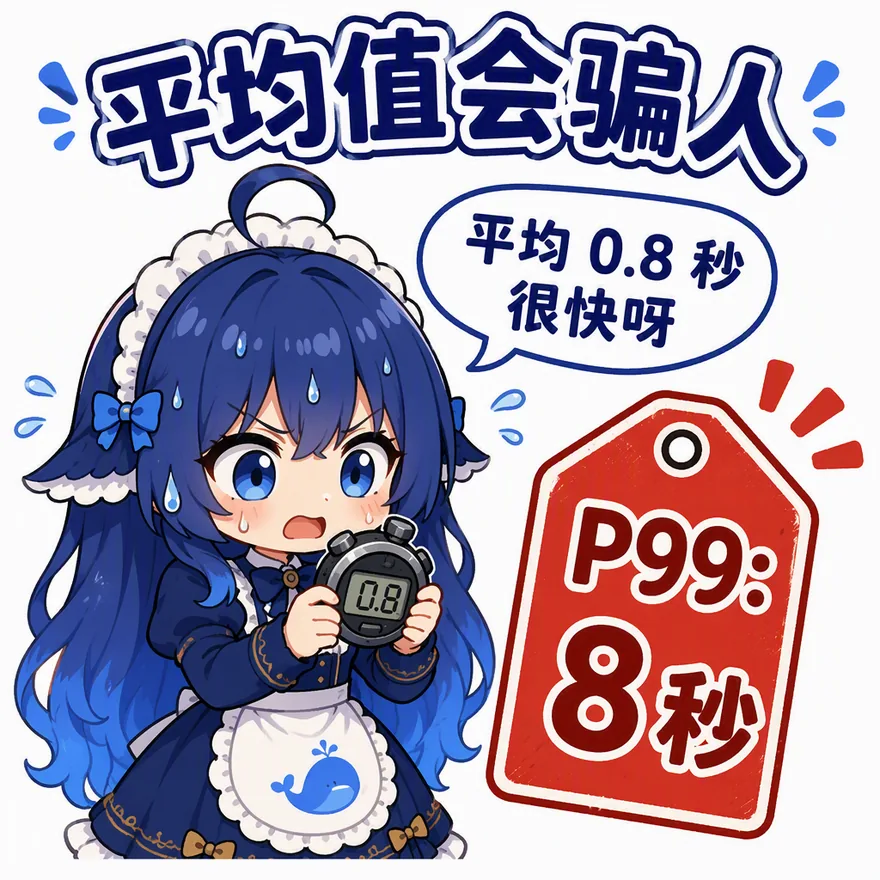 平均值会骗人(女生盯着秒表冒汗,「平均 0.8 秒」的自我安慰被「P99:8 秒」的警告牌打脸——用户体感由最慢的那 1% 决定)。
先给一个能复述的答案
TTFT(Time To First Token,从用户发出请求到屏幕上出现第一个字的等待时间)由四段组成:查询 Embedding、向量检索、重排、生成端吐出首 token。优化顺序应该是:先分段埋点,找出占比最大的那一段,再对症处理——Embedding 做批处理与异步并发,检索调索引参数、做分区路由,重排裁剪候选数量,生成端上流式输出和 Prefix Cache。先测量再优化,否则大概率白干。
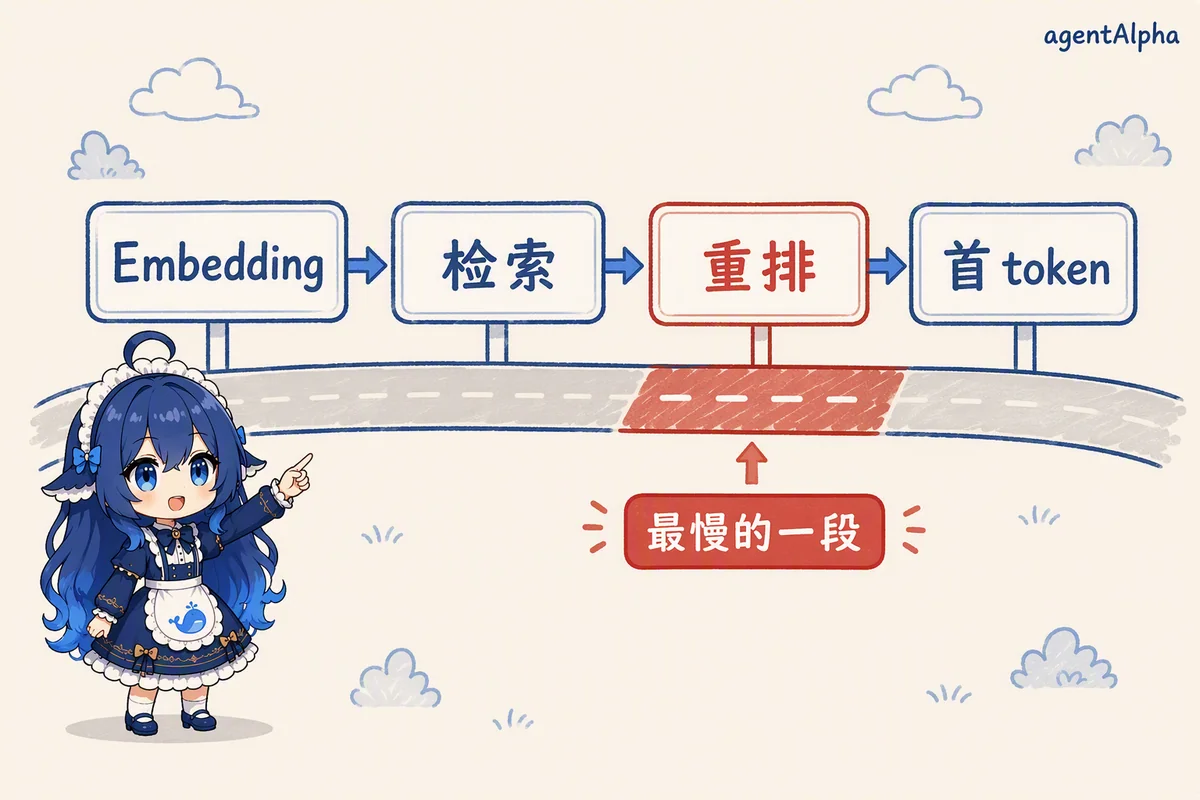 图:小蓝图解——首字延迟的四段赛道,找到最慢的一段。
把 TTFT 拆成四段,每段单独埋点
一段典型的 RAG 请求,时间花在四个地方:
| 环节 | 在做什么 | 延迟主要来自 | 常用优化手段 |
|---|---|---|---|
| Embedding | 查询文本转向量 | 模型推理排队 | 批处理、异步并发、轻量模型 |
| 检索 | 向量库找 Top-K | 图搜索探索的节点数 | 调 efSearch、分区路由 |
| 重排 | 精排模型逐对打分 | 候选数量 × 单条耗时 | 两级裁剪、并行预取 |
| 生成首 token | 模型读完上下文再吐字 | 上下文长度 | 精简片段、Prefix Cache、流式 |
这张表也是排查顺序。常见误区是上来就怀疑模型慢,实际上很多系统里重排和生成段的 Prefill 才是大头。
工程做法:在网关处给每段记录开始与结束时间,按 P50 / P95 / P99 分别看。平均值会骗人,P99 才决定用户的体感。没有分段埋点就做优化,相当于闭着眼睛调参。
AgentAlpha 面试题库 · 字节篇的推理部署部分有一道真题:「流式输出场景下,首 Token 延迟、Token 间延迟和总延迟如何监控?」它考的就是这套分段意识:三个指标对应链路上不同环节,监控必须分开建,混在一个平均值里就失去了定位能力。
Embedding 与检索段:让向量算得快、查得快
Embedding 这段最常见的浪费是每条请求单独算。多个并发查询可以合并成一个 batch 交给模型,一次前向算完;鉴权、权限过滤这些与向量无关的前置步骤,用异步并发跟 Embedding 并行跑,别串行排队。
检索段的关键参数在向量索引里。主流向量库大多用 HNSW(Hierarchical Navigable Small World,分层可导航小世界图):把向量组织成多层图,上层稀疏、负责远距离快速导航,底层稠密、负责精细搜索。查询延迟主要由搜索时的候选队列长度 efSearch 决定——调小它延迟立刻下降,代价是召回率下滑。这是一个显式的取舍,要用评测集画出召回-延迟曲线再定值,而不是沿用默认参数。
另一个容易被忽略的手段是分区。按租户、时间或业务线把索引拆开,查询只搜相关分区,搜索空间从全库缩小到一个分区,延迟和召回同时受益。
 图:HNSW 的多层图结构(上层节点更少、连线更长,搜索从顶层出发逐层下降缩小范围,把全库暴力比对的开销降到对数级别——向量库毫秒级召回的基础)
重排段:最容易成为隐形大头
Reranker 通常用交叉编码器(Cross-Encoder,把查询和文档拼在一起逐对打分的模型),精度高,但它的时间随候选数量线性增长。召回想提质量,候选数量一路加码,重排延迟就跟着一路上涨,很多团队是在这里不知不觉丢掉延迟预算的。
工程上做两级裁剪:粗排先砍到几十条,精排只看头部的一二十条;重排的同时并行预取 Prompt 模板和上下文拼装,把串行等待吃掉。
AgentAlpha 面试题库 · 腾讯篇的 RAG 部分直接问了这道题:「Reranker 放在召回链路的什么位置,候选数量如何确定?」答题思路是「位置在粗排之后、生成之前,数量由评测集按精度收益和延迟预算共同决定」,而不是拍脑袋给个整数。
 图:首字延迟是一场分段接力——Embedding、检索、重排、生成首 token,哪一段慢了都会拖住最后一棒。优化前先分段计时。
生成段:首 token 之前,模型在干什么
生成模型吐出第一个字之前,要把系统 Prompt、检索到的所有片段一次性读完,这一步叫 Prefill。上下文越长,首 token 越慢——所以把重排后最相关的片段精简后再放进去,本身就是首字优化。
三件事按收益排序:
- 流式输出:用 SSE 把首 token 尽早推给前端。注意它不减少总延迟,只改善体感——面试里主动说出这一点是加分项。
- Prefix Cache:系统 Prompt、few-shot 这类固定前缀的 KV 缓存被复用后,每次请求不用重算这部分 Prefill。
- 就近部署与网络优化:跨机房调用加在首字上的等待,经常比模型推理本身还多。
一套按顺序执行的排查流程
线上被告知「首字慢」,按这个顺序切:
- 分段埋点里找 P95 最大的一段,先别动其他段。
- 检索段慢:看索引规模是否膨胀、efSearch 是否被调大过、分区是否失效退化为全库搜索。
- 重排段慢:看候选数量是否被悄悄加码,单条打分耗时是否因模型升级变贵。
- 生成段慢:看 Prompt 总长度曲线,检索片段是否越塞越多;确认 Prefix Cache 命中率。
- 都不慢但首字仍慢:查网络与排队,尤其是高峰期的限流和批处理排队。
AgentAlpha 面试题库 · 腾讯篇的推理部署部分还要求候选人「为腾讯云企业助手服务制定首 Token 延迟、端到端延迟、吞吐和成本 SLO」——能报出目标值并说清监控口径,比背十种优化手段更能证明做过真系统。
面试现场:追问怎么接
「流式输出算优化吗?」 算体感优化,不算延迟优化。总时间没变,但用户更早看到内容,中途放弃的比例会下降。
「efSearch 调小会不会影响效果?」 会,召回率下降。所以必须配离线评测集,找出「延迟预算内召回最高的参数」,不能单方面压。
「缓存不是更快吗?」 是,但缓存改变的是命中率分布,不改变单次未命中时的链路耗时。缓存体系是另一个话题,两件事要分开答。
参考答案要点
- TTFT 是四段延迟的累加:Embedding、检索、重排、生成首 token,先分段埋点找大头,再动手。
- Embedding 走批处理和异步并发;检索靠 efSearch 与分区路由;重排靠两级裁剪;生成端靠精简上下文、Prefix Cache 和流式。
- 主动说坑:流式只改善体感不减总延迟;重排候选数悄悄加码,是延迟失控最常见的隐形推手。
- 收在取舍:每项优化都在延迟和效果之间交换,参数必须用评测集定,不能拍脑袋。