评测与可观测
非确定系统的回归测试、Golden Set、LLM 裁判校准、trace 埋点与可观测性。核心是别让被测者改自己的分数。
本篇分类真题集
PICKED
本方向读法
LEARN PATH
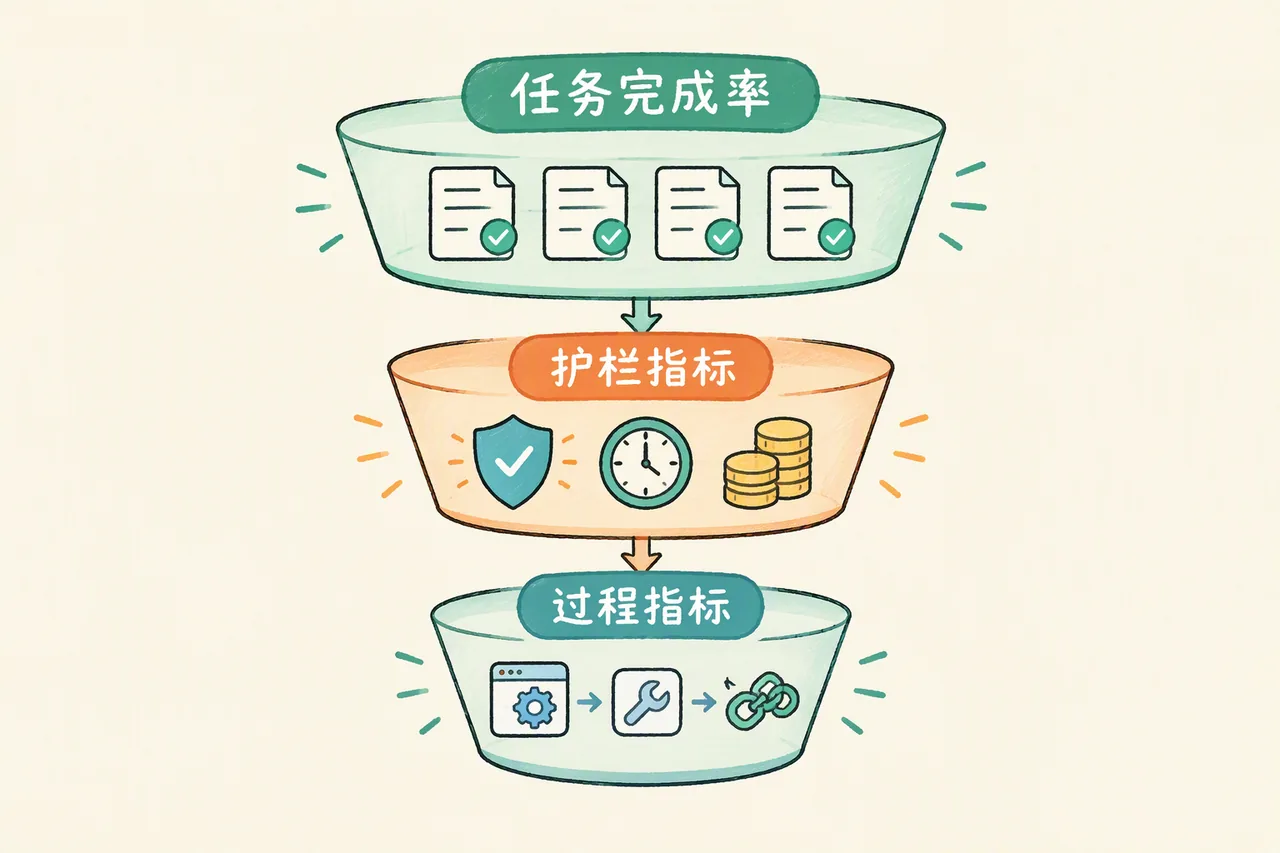
本方向的取用顺序。要完整系统学,去主线课程第 7 章「评测」(本方向归属章)。
刷透高频题
14 道速答题,每题一页:先这样答 → 面试官追问 → 回答的坑。下方题单收前 8 道,全部进分页列表。
深挖机制与选型
98 篇深度解析 + 2 篇对比选型,逐层拆到原理与工程取舍。
实战检验
项目面试包讲「项目怎么讲才扛住追问」;再按公司检验:五厂真题集。
速答题单
共 14 道
分类内题目
共 101 篇
教程深挖
深度解析与对比选型 · 1 篇
真题解析
宝典真题完整解析 · 97 篇 · 去真题库总览
在评估一个 Agent 的任务完成情况时,除了最终结果的正确性,还有哪些过程指标是值得关注的?(例如:效率、成本、鲁棒性)
面试官想看你能否跳出“结果正确率”的单一维度,从工程落地角度系统评估 Agent。这属于系统设计+工程取舍型问题,刁钻点在于:Agent 的中间过程(如工具调用、决策路径)比最终答案更能暴露系统瓶颈。答好了能展示你对 A
在进行人工评估时,如何设计合理的评估准则和流程,以保证评估结果的客观性和一致性
面试官想看你是否真正理解“人工评估”不是拍脑袋打分,而是一个可量化的工程流程。考察类型是系统设计 + 工程取舍。刁钻点在于:多数人只会背“多维度评分、计算Kappa”,但问“维度冲突怎么处理?评估者疲劳怎么控制?低一致性
VLM 在生成内容时,同样会遇到“幻觉”(Hallucination)问题,但它的表现形式和纯文本 LLM 有何不同?请举例说明
面试官想考察你是否真正理解多模态幻觉的独特性,而非简单复述LLM幻觉概念。这是概念对比+工程取舍类型题,刁钻点在于:VLM幻觉不仅是“编造”,更是“看错”或“忽略视觉证据”,本质是视觉编码器与语言先验的冲突。答好了能展示
什么是“LLM-as-a-Judge”?使用 LLM 来评估另一个 LLM 的输出,有哪些优点和潜在的偏见
面试官想考察你对 LLM 评估前沿方法的理解深度,而非仅仅背诵定义。这属于“系统设计+工程取舍”类问题,刁钻点在于:你是否能跳出“LLM 万能”的幻觉,识别出 LLM-as-a-Judge 作为评估工具时的系统性偏见(如
你说混合检索把召回率从 0.72 提到了 0.89,这个数字怎么来的
面试官真正想看的是:你是否具备科学评估的工程化思维,而不是只会背概念或拍数字。这道题是典型的“debug + 系统设计”混合型考察,刁钻点在于:候选人往往只记得优化后的数字,却说不清测试集怎么来的、指标怎么算的、有没有过
测试集怎么构建的?ground truth 谁标注的?如果标注有错怎么办
面试官想考察你构建评估体系时的工程严谨性和质量控制意识。这不是背概念题,而是系统设计 + debug 类型。刁钻点在于:多数人只会说“人工标注”,但面试官要听的是如何系统性降低标注噪声,以及发现错误后的完整流程机制。答好
200条够吗?覆盖了所有 query 类型吗?生成阶段的答案质量怎么评估?也是你自己看的?有没有用自动化评估工具
面试官在考察你对 RAG 系统评估的工程化思维,而非单纯背概念。核心看三点:一是测试集规模与覆盖度的 trade-off,能否用 200 条覆盖关键 query 类型并给出量化理由;二是生成阶段评估的自动化能力,是否知道
如果 Agent 产生了错误记忆(例如:误解用户、错误事实、幻觉写入),你如何让系统自动纠正或“遗忘”错误记忆
面试官想看你是否理解Agent记忆系统在真实部署中的脆弱性——错误记忆一旦写入,会像“脏数据”一样污染后续所有推理。这属于系统设计+工程取舍类问题,刁钻点在于:你不能只提“检测-纠正”的线性流程,而要展示对记忆生命周期管
LoCoMo基准如何评估长对话场景下的记忆能力
面试官想看你是否理解“长对话记忆评估”不是简单堆长文本,而是需要对抗“遗忘曲线”和“信息干扰”的系统设计。考察类型是系统设计+工程取舍,刁钻点在于:LoCoMo 不是传统 QA 基准,它要求模型在 100+ 轮对话中追踪
可信记忆(Trustworthy Memory)涉及哪些维度?隐私保护、可解释性、幻觉鲁棒性如何解决
面试官想考察你对 Agent 记忆系统在“可信”维度上的系统性理解,而非零散知识点。这是一道系统设计 + 工程取舍题,刁钻点在于:隐私、可解释性、鲁棒性三者天然存在冲突(如差分隐私加噪会破坏可解释性),你需要展示如何在实
你们的模型基于哪些异构图像做增强?模型会不会产生幻觉,生成文档外的内容
面试官想考察你两个核心能力:多模态数据增强的工程实践和幻觉控制的系统性思维。这不是背概念题,而是系统设计 + debug 题。刁钻点在于:① 数据增强不只是“翻翻转”,要区分图像级和文档级异构策略,并说明 trade-o
若高德 API 要求输入经纬度坐标,但大模型产生幻觉输出错误公司坐标,导致门店查询错误,该怎么干预模型?如果模型坚持认为自己的坐标是对的,该怎么处理?定位到问题原因后,又该怎么解决
面试官想考察你在 Agent 系统中处理模型幻觉的工程化能力,而非单纯背概念。核心是:当模型输出与外部 API 硬约束冲突时,如何设计防御性架构。刁钻点在于“模型坚持错误”——这测试你是否理解 LLM 的固执本质(自回归
如何缓解LLM幻觉
面试官真正想看的不是“你知道幻觉是什么”,而是你在工程实践中如何系统性地压制幻觉。这是一道系统设计+工程取舍题,刁钻点在于:候选人往往只提RAG或prompt工程,却忽略数据源头、解码策略、验证完整流程等整条链路方案。答
如何证明 Agent 比人工客服更好?设计评估方案
面试官想看你是否具备系统性评估思维,而非简单罗列指标。这是一道系统设计+工程取舍题,刁钻点在于:Agent 和人工客服的“好”定义不同——人工重情感共鸣,Agent 重效率与一致性。答好了能展示你懂实验设计(A/B测试、
如何设计一个评估方案来衡量 LLM 的特定能力,比如「事实性/幻觉水平「、「推理能力「或「安全性「
面试官想看你是否具备系统化评估设计的硬实力,而非只会跑现成benchmark。考察类型是系统设计+工程取舍,刁钻点在于:评估方案必须可复现、可诊断、能区分“模型不会”和“测试集有偏”。答好了能展示你对LLM能力边界的深刻
评估一个 Agent 为什么比评估一个基础 LLM 更加困难和复杂?评估的维度有哪些不同
面试官想看你能否穿透“Agent 就是 LLM + 工具”的表象,理解评估复杂性的本质。这题属于系统设计 + 工程取舍类型,刁钻点在于:多数人只答“多步决策难评估”,但没点出评估目标的根本转变——从“单轮输出质量”变为“
如何设计一个评估方案来衡量 LLM 的特定能力,比如“事实性/幻觉水平”、“推理能力”或“安全性”
面试官想看你能否从“跑个benchmark”的初级思维,升级到“设计一套可复现、有区分度、能指导迭代的评估体系”。这属于系统设计类问题,刁钻点在于:很多人只会堆指标(准确率、F1),但说不清为什么选这个基准、指标有什么盲
但是未来的超级人工智能模型将表现出复杂的行为,对人类来说难以可靠地评估,对于人类对超级人工智能模型进行弱监督,我们研究了这个问题的类比:弱模型监督是否能唤起更强大模型的全部能力
面试官想考察你对“弱到强泛化”(Weak-to-Strong Generalization)这一前沿课题的底层理解,而非单纯背诵论文结论。这是典型的系统设计+debug型问题,刁钻点在于:你需要从实验设计、瓶颈分析到改进
如何设计 Agent 的评估方案?LLM-as-a-Judge
面试官想考察你对 Agent 评估的系统性认知,而非单纯背诵指标。核心看三点:① 是否理解 Agent 评估与 LLM 评估的本质差异(多步决策 vs 单轮问答);② 是否掌握 LLM-as-a-Judge 的工程化落地
列举你知道的 Agent Benchmark,以及它们评估的侧重点。
面试官想看你对 Agent 评估生态的广度认知。刁钻点在于:很多人只答"AgentBench"或"HumanEval",但说不清各 benchmark 的评估维度差异和适用场景。答好了能展示你对 Agent 评估体系的系
什么是 AgentBench?它包含哪些环境?各环境的评估特点是什么
考察对 AgentBench 的深度理解——不仅知道名字,还要知道8个环境的具体设计和评估特点。
WebArena 和 Mind2Web 的区别是什么?分别适合评估什么
考察对 Web Agent 评估的深度理解。刁钻点:两者都是 Web 评估但设计哲学不同——WebArena 评估"端到端任务完成",Mind2Web 评估"单步元素定位"。
SWE-bench 是如何评估 Agent 的编程能力的?为什么这么难
考察对代码 Agent 评估的深度理解。刁钻点:SWE-bench 不是"写代码"评估,而是"修 Bug"评估——需要理解代码库、定位问题、生成 patch、通过测试。
如何构建一个针对特定业务场景的 Agent 评估集
考察从 0 到 1 构建评估集的能力。刁钻点:不是收集数据就行,需要考虑覆盖度、难度分级、防泄漏、可维护性。
评估 Agent 时,如何区分「模型能力「和「工程实现「的问题
考察对 Agent 系统的分解能力。刁钻点:Agent 失败可能不是 LLM 的问题,而是 prompt 设计、工具实现、上下文管理等工程问题。
Agent 评估中的「数据泄漏「问题如何应对
考察对评估公正性的理解。刁钻点:LLM 的训练数据可能包含 benchmark 答案,导致评估分数虚高。
Agent 评估的未来方向是什么
考察技术视野。没有标准答案,但需要展示对评估方法演进的前瞻思考。
如何评估一个 Agent 的能力?有哪些常用指标
面试官想看你能否从任务完成、效率、安全三个维度构建完整的评估指标体系。刁钻点:很多人只答"准确率",但 Agent 评估需要多维度指标——不仅要"做对",还要"高效"和"安全"。
Agent 评估与 LLM 评估有什么不同
考察对两种评估范式的区分能力。刁钻点:Agent评估不是LLM评估的简单扩展——需要评估"行为序列"而非"单次输出"。
什么是 LLM-as-a-Judge?它的优缺点是什么
考察对LLM评估方法的深度理解。刁钻点:需要说出LLM-as-Judge的具体偏见和缓解方案。
如何评估 Agent 的「工具调用「能力
考察对工具调用评估的系统性理解。刁钻点:工具调用不只是"选对工具",还包括"参数正确"、"结果解析正确"、"错误处理"。
如何评估 Agent 的「长程规划「能力
考察对长程任务评估的理解。刁钻点:长程规划的评估不能只看最终结果,还要看"规划质量"和"动态调整"。
Agent 的「安全性「如何评估
考察安全评估的系统性设计。刁钻点:安全评估需要"红队思维"——主动构造攻击场景。
如何设计一个 Agent 的 A/B 测试实验
考察实验设计能力。刁钻点:Agent A/B测试比传统Web A/B复杂——需要控制"环境状态"和"多步交互"的变量。
Agent 评估中「人类在环「(Human-in-the-Loop)的作用是什么
考察对HITL在评估中作用的理解。刁钻点:HITL不仅是"人工标注",还包括"人工审计"、"人工干预"、"人工校准"。
auc指标解释一下
面试官想看你是否真正理解AUC的统计意义,而非仅背定义。考察类型是概念+工程取舍:刁钻点在于你是否知道AUC等价于Wilcoxon-Mann-Whitney检验的统计量(随机正样本得分>随机负样本的概率),以及能否指出其