Agent 架构
ReAct 循环、规划与反思、记忆系统、整体设计。面试官最想看的是你能不能说出「为什么这么拆」,而不是背框架名字。
本篇分类真题集
PICKED
本方向读法
LEARN PATH
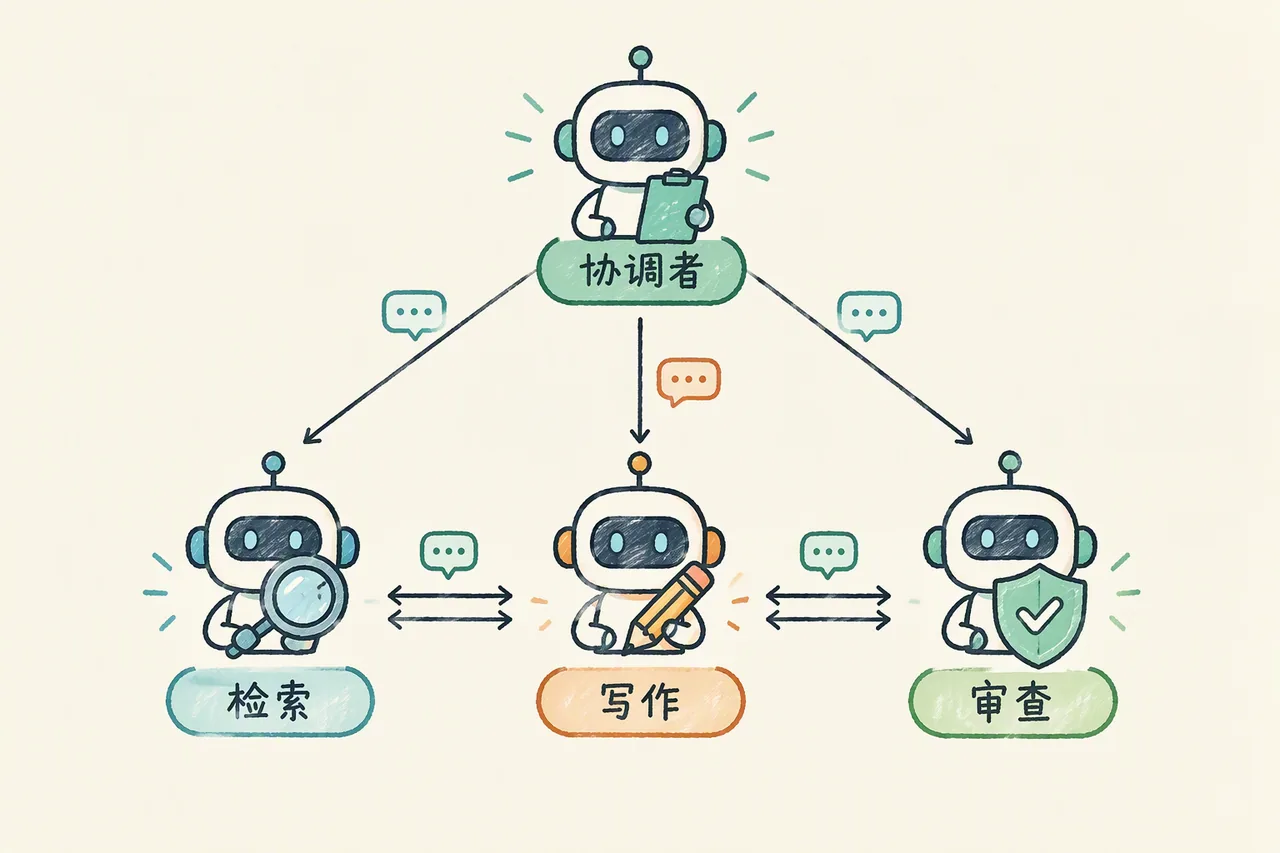
本方向的取用顺序。要完整系统学,去主线课程第 4 章「Agent 架构」(本方向归属章)。
刷透高频题
19 道速答题,每题一页:先这样答 → 面试官追问 → 回答的坑。下方题单收前 8 道,全部进分页列表。
深挖机制与选型
258 篇深度解析 + 2 篇对比选型,逐层拆到原理与工程取舍。
实战检验
项目面试包讲「项目怎么讲才扛住追问」;再按公司检验:五厂真题集。
速答题单
共 19 道
分类内题目
共 261 篇
教程深挖
深度解析与对比选型 · 3 篇
LLM 和 Agent 的本质区别:从“会答”到“会做”差了哪几件事
说说 LLM 和 Agent 的核心区别?为什么现在大家都在从 LLM 迈向 Agent?
只有 CoT 为什么做不出 Agent?ReAct 补上了哪一块
为什么 ReAct 是现代 Agent 的底层逻辑?单靠 CoT 根本不够?
CoT + Plan-Execute:把复杂任务拆成 Function Call 能接住的步骤
为什么 CoT + Plan-Execute 能显著提升 Agent 的 Function Call 稳定性?
真题解析
宝典真题完整解析 · 255 篇 · 去真题库总览
Plan-and-Execute 和 ReAct 的适用场景有什么不同?何时混用
面试官想看你能否区分"先规划再执行"和"边想边做"两种 Agent 范式,并在实际场景中做出正确选型。刁钻点在于:很多人认为 Plan-and-Execute 一定比 ReAct"更高级",但实际上对于不确定性强、需要探
什么是「记忆「在 Agent 中的分层设计?如何工程化实现
面试官想看你能否设计一个生产级的 Agent 记忆系统。刁钻点在于:很多人只答"短期记忆和长期记忆",但说不清工作记忆、短期记忆、长期记忆的边界和交互方式,更不知道如何工程化实现(用什么存储、怎么检索、如何更新)。答好了
RAG-based Agent 和 Tool-based Agent 的区别是什么?何时混用
面试官想看你能否区分"知识增强"和"能力扩展"两种 Agent 架构范式。刁钻点在于:很多人把 RAG 和 Tool Use 看成独立的东西,但现代 Agent 几乎都是两者的混合。答好了能展示你对 Agent 能力边界
Agent 的「观察空间「和「行动空间「应该如何设计
面试官想看你能否从"RL(强化学习)视角"设计 Agent 的信息输入和行为输出空间。刁钻点在于:很多人只答"观察空间是 Agent 能看到的信息,行动空间是能执行的操作",但说不清如何平衡"完整性"和"简洁性"——观察
单 Agent 和 Multi-Agent 架构的决策树是什么
面试官想看你能否给出一个清晰的"何时用单 Agent、何时用多 Agent"的决策框架。刁钻点在于:很多人认为"多 Agent 一定更强",但多 Agent 的协调成本、通信开销、调试复杂度都远高于单 Agent。答好了
Agent 架构的未来趋势是什么
面试官想看你对 Agent 架构演进方向的洞察力。这题没有标准答案,但答得好能展示你的技术视野和前瞻性思考。刁钻点在于:很多人只列举"端到端 Agent"、"神经符号系统"等概念,但说不出为什么这些方向重要、当前瓶颈在哪
什么是「观察者模式「在 Agent 系统中的应用
面试官想看你能否将经典设计模式(观察者模式)迁移到 Agent 系统中。刁钻点在于:很多人能背"观察者模式 = 发布-订阅",但说不清在 Agent 场景中"谁发布、谁订阅、发布什么、订阅后做什么"。答好了能展示你的设计
什么是「策略模式「在 Agent 决策中的应用
面试官想看你能否将策略模式应用于 Agent 的"决策逻辑可替换"场景。刁钻点在于:Agent 的决策逻辑(选什么工具、怎么规划)通常硬编码在 prompt 中,修改决策逻辑需要改 prompt。策略模式允许在运行时动态
什么是「管道-过滤器「模式在 Agent 工作流中的应用
面试官想看你能否将管道-过滤器(Pipeline-Filter)模式应用于 Agent 的多步处理流程。刁钻点在于:Agent 的处理流程不是纯线性的——可能有条件分支、循环、并行。如何在保持管道模式简洁性的同时处理这些
什么是「责任链「模式在 Agent 权限控制中的应用
面试官想看你能否将责任链模式应用于 Agent 的安全权限控制。刁钻点在于:Agent 的权限控制不是简单的"允许/拒绝",而是多层级的——输入过滤→参数校验→权限检查→沙箱执行→输出过滤。责任链模式可以优雅地组织这些检
Agent 的「状态机「模式应该如何设计
面试官想看你能否用有限状态机(FSM)建模 Agent 的行为流程。刁钻点在于:Agent 的状态不是简单的"空闲/运行中/完成"——它涉及多步推理、工具调用、错误恢复、人工审批等复杂状态转换。如何设计状态、转换条件、嵌
什么是「事件驱动「架构在 Multi-Agent 系统中的优势
面试官想看你能否对比"事件驱动"和"请求-响应"两种 Multi-Agent 通信模式。刁钻点在于:很多人只知道"Agent 间发消息",但说不清事件驱动相比同步调用的优势(解耦、可扩展、容错)以及代价(一致性、调试复杂
Agent 的「插件化「设计应该如何实现
面试官想看你能否设计一个可扩展的 Agent 插件系统。刁钻点在于:插件化不只是"写接口"——需要考虑插件发现(怎么找到插件)、插件加载(运行时还是编译时)、插件隔离(插件崩溃不影响主系统)、插件通信(插件间怎么交互)。
Agent 系统的「熔断-降级-限流「模式如何设计
面试官想看你能否将微服务的弹性设计模式(熔断/降级/限流)迁移到 Agent 系统。刁钻点在于:Agent 的"服务"是 LLM API + 工具 API,与传统微服务有不同的故障模式——LLM API 可能限流(429
Agent 的推理链路通常有哪些性能瓶颈?如何系统性定位
面试官想看你能否系统性分析 Agent 的性能瓶颈,而非零散列举"LLM 慢""网络延迟"。刁钻点在于:Agent 的延迟不是单一因素——涉及 LLM 推理、工具调用、RAG 检索、上下文组装等多个环节,每个环节都有特定
什么是 Speculative Decoding?它如何加速 Agent 推理
面试官想看你是否了解 LLM 推理加速的前沿技术。刁钻点在于:Speculative Decoding 不是简单的"并行生成"——它用一个小的 draft model 预测多个 token,再用大模型验证。需要理解其原理
KV Cache 在 Agent 场景中有什么特殊优化
面试官想看你能否将 KV Cache 优化从"单次推理"扩展到"Agent 多轮交互"场景。刁钻点在于:Agent 的多轮对话中,前几轮的 KV Cache 可以复用,但对话变长时 KV Cache 会膨胀。如何管理 A
Agent 的工具调用如何并行化
面试官想看你能否设计 Agent 工具调用的并行执行方案。刁钻点在于:不是所有工具调用都能并行——有些有依赖关系(如先搜索再分析),有些受 API 限流约束。如何分析依赖、设计并行策略、处理并行结果合并是关键。
Prompt 缓存和结果缓存如何设计
面试官想看你能否设计 Agent 的多级缓存体系。刁钻点在于:Agent 的缓存不只是"输入→输出"的简单缓存——需要在 Prompt 级(减少 LLM 计算)、结果级(减少重复调用)、语义级(相似输入复用)三个层级设计
Agent 的 Prompt 如何压缩以减少 Token 消耗
面试官想看你能否系统性地减少 Agent 的 prompt token 消耗。刁钻点在于:压缩不是简单删字——需要在"信息保持"和"token 减少"之间平衡。过度压缩导致信息丢失、Agent 决策质量下降。答好了能展示
Agent 的流式输出(Streaming)有什么优化技巧
面试官想看你能否通过流式输出优化用户体验。刁钻点在于:流式输出不只是"逐字返回"——需要处理工具调用中的流式、多步推理中的中间结果展示、错误恢复等复杂场景。答好了能展示你对用户体验和 LLM 流式 API 的深度理解。
如何量化评估 Agent 性能优化的效果
面试官想看你能否建立 Agent 性能评估体系。刁钻点在于:Agent 性能不只是"延迟降低"——需要在延迟、成本、质量三个维度同时评估,且优化一个维度可能影响另一个(如压缩 prompt 降成本但可能降质量)。答好了能
什么是位置编码?为什么 Transformer 需要它
面试官想确认你是否真正理解 Transformer 架构的核心缺陷——自注意力机制的位置无关性。这道题表面是概念题,实则考察你对"为什么需要位置信息"的本质理解。刁钻点在于:很多人只答"让模型知道词的位置",但说不出"自
Sinusoidal 位置编码和 Learned 位置编码有什么区别?各有什么优劣
面试官想看你能否深入对比两种经典位置编码方案,而非简单背诵定义。刁钻点在于:很多人只答"一个是固定的,一个是学习的",但说不出外推能力、参数效率、训练稳定性等深层差异。答好了能展示你对位置编码设计空间的理解,以及在不同场
RoPE(旋转位置编码)的原理是什么?为什么现在主流 LLM 都用它
面试官想看你能否清晰解释 RoPE 的数学原理和工程优势。这是 LLM 基础的高频题,几乎每场面试都会问。刁钻点在于:很多人背了"旋转矩阵"但说不清为什么旋转能编码位置、为什么旋转后的内积只依赖相对距离、以及 RoPE
ALiBi 和 RoPE 的对比?分别适用于什么场景
面试官想看你能否从多个维度对比两种主流位置编码方案,并根据场景做选型推荐。刁钻点在于:很多人只答"RoPE 旋转,ALiBi 加 bias",但说不出在训练稳定性、外推能力、长距离建模等方面的深层差异。答好了能展示你对位
什么是长度外推(Length Extrapolation)?有哪些技术手段
面试官想考察你对长文本扩展技术的系统性了解。这是 2024-2025 年 LLM 领域的热门话题,几乎每个做大模型的公司都在做上下文扩展。刁钻点在于:很多人只答"位置插值",但说不出 NTK-aware、YaRN、Lon
为什么 LLM 的上下文长度从 2K 扩展到 128K 甚至 1M 这么难
面试官想看你能否从多个维度分析长上下文的技术挑战,而非只答"注意力是 O(n²)"。刁钻点在于:很多人只知道计算复杂度问题,但忽略了位置编码外推、KV Cache 内存、数据稀缺、训练稳定性等 equally impor
如何评估一个 LLM 的长文本能力?有哪些 benchmark
面试官想看你能否设计一个全面的长文本评估方案,而非只列举几个 benchmark 名字。刁钻点在于:很多人只答"LongBench"和"Needle-in-Haystack",但说不出不同 benchmark 评估的维度
介绍一种你了解的长文本优化方案(如 Ring Attention、StreamingLLM)。
面试官想看你对长文本前沿技术的深度理解。这题没有固定答案,选什么方案都可以,但答得好需要展示"原理理解 + 工程实践 + 局限分析"三个层次。刁钻点在于:很多人只背概念,但说不出实现细节、性能数据、适用场景。答好了能让你
什么是 Prompt
这道题看似基础,实则考察候选人是否具备“工程化理解 Prompt”的能力,而非停留在“Prompt 就是输入文本”的浅层认知。面试官真正想看的是:你是否能清晰区分 Prompt 的组成要素(指令、上下文、示例、格式约束)
Prompt Engineering 的本质是什么
这道题看似基础,但面试官真正想看的是:你是否能把 Prompt Engineering 从“写提示词”的玄学层面,拔高到“与模型交互的接口设计”这一工程层面。考察类型是概念辨析 + 工程取舍。刁钻点在于:很多人会背“清晰
Q1: 你如何定义一个基于 LLM 的智能体(Agent)?它通常由哪些核心组件构成?**
这道题是 P0 级基础题,但面试官真正想看的不是“背定义”,而是区分你是在“背论文”还是“真做过”。考察类型是概念 + 工程取舍。刁钻点在于:很多人能列出“规划、记忆、工具”三个词,但说不出每个组件的具体实现选型(比如记
Q6: 对于想要进入Agent领域的初学者,你会给他/她什么建议?应该重点学习哪些技术?**
这道题看似是“给建议”,实则考察三件事:你对 Agent 技术栈的体系化理解(不是罗列工具)、你踩过哪些坑(体现实战经验)、你能否把复杂知识降维讲给新人(体现沟通和带人能力)。面试官想看你是否具备“从零搭建 Agent
SSE 的局限性是什么
面试官想考察你对 SSE(Server-Sent Events)的深度理解,而非简单背诵“单向/文本/连接数限制”。这是典型的 工程取舍 + 系统设计 题,刁钻点在于:SSE 看似简单,但在高并发、双向通信、二进制流等场
什么是 Agentic AI
面试官想确认你是否真正理解 Agentic AI 的本质,而非停留在“能调用工具的 LLM”这种肤浅认知。考察类型是概念辨析 + 系统设计,刁钻点在于:Agentic AI 与普通 AI 的边界在哪?它和 RAG、Fun