「我们把模型换到最新版了,为什么这系统还是像个聊天机器人?」——不少团队做智能助手项目时都撞过这堵墙。面试里它换了个问法。AgentAlpha 面试题库 · 腾讯篇里有一道高频题:「智能回答(传统大模型)与 AI Agent 的核心区别是什么?AI Agent 的核心要素有哪些?」很多人答成“Agent 更聪明”,面试官基本就停笔了。
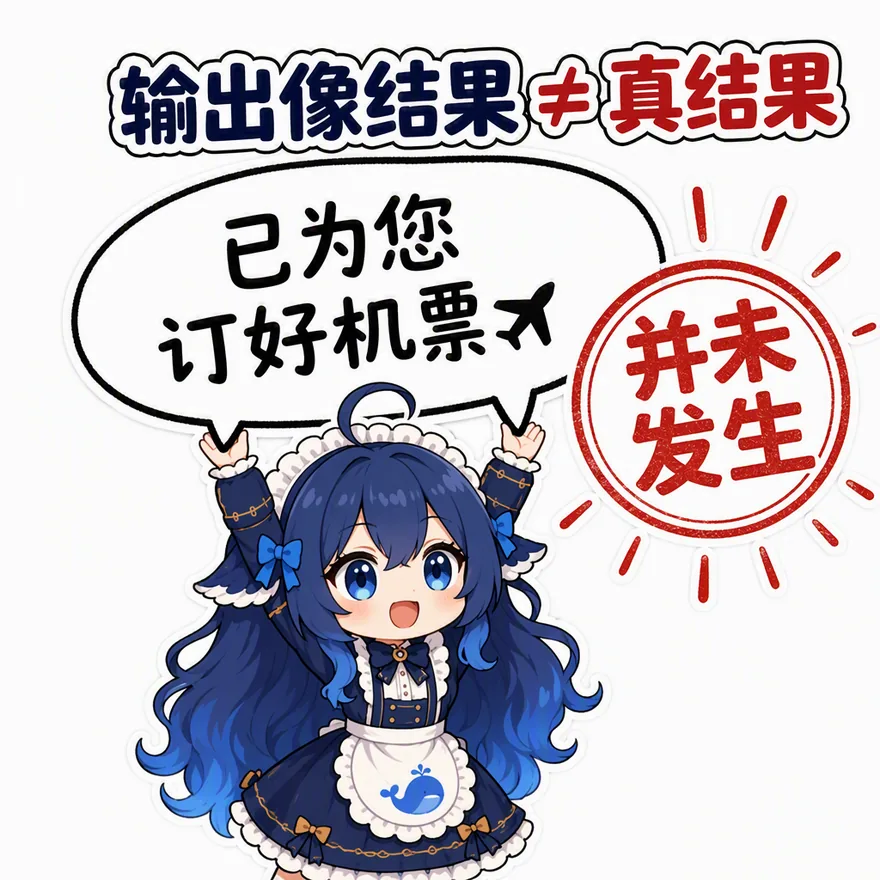 输出像结果 ≠ 真结果(气泡里「已为您订好机票」说得笃定,砖红印章「并未发生」——LLM 只生成像结果的文本,没有对真实世界的改动)。
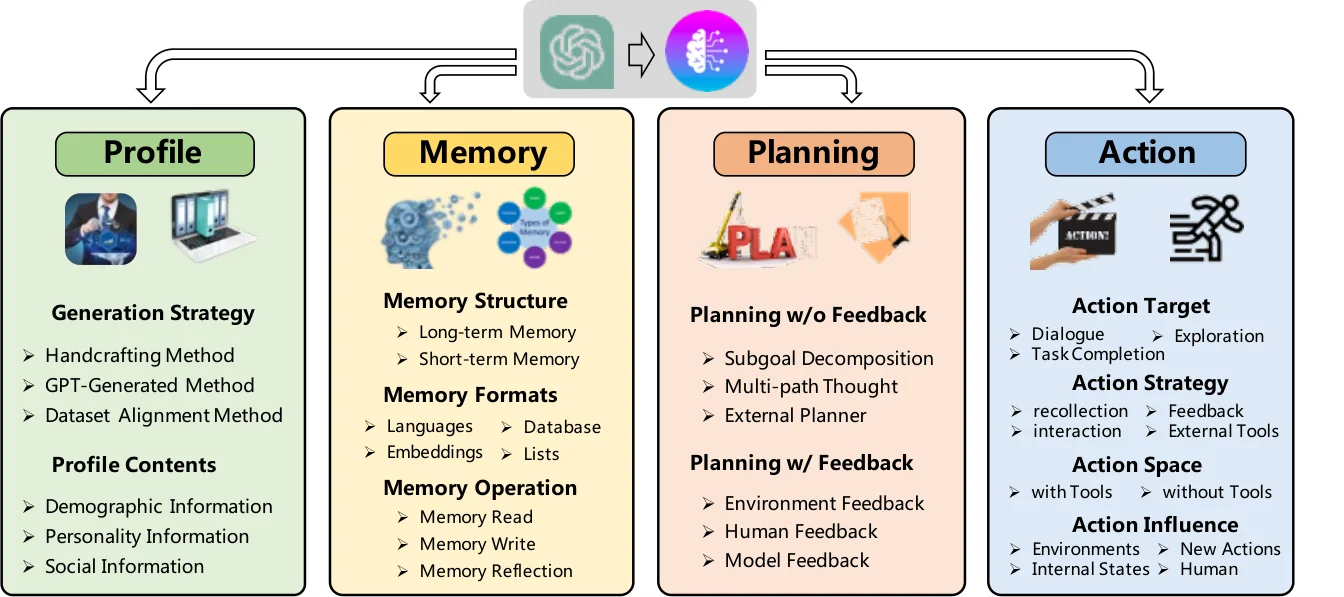 图:LLM 自主 Agent 的统一架构(profile 定义角色、memory 管理上下文、planning 拆解子目标、action 执行工具调用——主流 Agent 框架的四个公共模块)
先说结论
LLM 是一个被动的文本生成器:输入文本,输出文本,到此为止。Agent 是以 LLM 为核心,组合规划、记忆和工具的工程框架,能围绕目标自主行动、观察结果、修正方向。区别不在模型聪不聪明,而在系统有没有“行动、观察、修正”的执行结构。
 图:小蓝图解——LLM 和 Agent 的分界:从「会答」到「会做」。
LLM 缺的三样东西
从工程视角看,LLM 直接拿来干活会卡在三件事上。
第一,不能执行。它只能生成文字,不能真正调用接口、点按钮、改数据库。你请它“订明天最便宜的航班”,它会写出一段很像订票结果的文字,但没有一张机票真的被订掉。
第二,没有反馈。它看不到执行之后的真实世界。它写的代码跑没跑通、查的订单存不存在,它都不知道,因为没有环境把结果喂回来。
第三,状态不跨会话。会话一结束,一切归零。上个月聊过的偏好、上周任务做到哪一步,它都不记得。上下文窗口再长,也只是“这一次的记忆”,不是“这个用户的记忆”。
所以 LLM 的交互形态是“一问一答”:你负责给全上下文,它负责给一段文本。任务能不能完成,责任全在提问的人。
这三样东西正好对应三类失败:该做的没做(不能执行)、做错了不知道(没有反馈)、上次答应的事这次忘了(状态不跨会话)。面试时按这个顺序讲,逻辑最顺,也最容易引出后面“Agent 补了什么”。
Agent = LLM + 四个模块
2023 年的综述《A Survey on Large Language Model based Autonomous Agents》把自主 Agent 拆成四个模块:画像(profile)、记忆(memory)、规划(planning)、行动(action)。这个拆法的好处,是把“Agent 比 LLM 多了什么”变成一份可以逐项检查的工程清单。
- 画像:定义 Agent 是谁、为谁服务、边界在哪,对应系统提示词里的角色与约束。
- 记忆:短期记忆是当前会话的上下文;长期记忆是跨会话保存的用户偏好、任务档案,放外部存储,按需检索。
- 规划:把“帮我处理这个退款”拆成查订单、判责、执行、通知用户四步,某步失败时重新规划。
- 行动:真正调用工具——查库、写接口、发消息——让文字变成对世界的改动。
LLM 在这里仍是核心部件,负责“下一步做什么”的判断。但判断只是一环,让判断落到行动、让行动产生反馈、让反馈修正判断,才是 Agent 和裸 LLM 的分界线。
每个模块都有代价
面试里加分的点,是知道每个模块的代价。
| 模块 | 解决什么问题 | 引入的新问题 |
|---|---|---|
| 规划 | 长任务拆步、失败重排 | 死循环、计划脱离实际、无限反思 |
| 记忆 | 跨会话状态、个性化 | 写入污染、记忆冲突、隐私合规 |
| 工具 | 让模型能“动手” | 选错工具、参数幻觉、越权调用 |
| 行动 | 对真实世界产生改变 | 副作用回滚、重复执行、审计需求 |
AgentAlpha 面试题库 · 字节篇里有一道题直接考这个代价:「如何设计 Agent 的停止条件,避免死循环、空转和无限反思?」——规划给了 Agent 自主性,也给了它原地打转的能力,所以停止条件必须做成工程机制,而不是在提示词里写一句“请别死循环”。
记忆同理。字节篇还有一道:「Working Memory、Episodic Memory、Semantic Memory 和 Procedural Memory 如何划分?」面试官想听的,是你会不会把不同生命周期的信息放进不同存储、配不同的写入门槛——这是系统设计题,不是名词解释题。
从 LLM 到 Agent 的补齐路径
理解了四个模块,团队迁移的路线也就清楚了,而且不必一步到位。
第一步先接工具:让模型能调用两三个内部接口,跑通“生成调用、执行、回填结果”的最小循环,这一步收益最大、成本最低。第二步加规划:任务变长之后,先拆解再执行,失败能重排。第三步补记忆:需要跨会话服务时,再引入外部存储和检索。
顺序做反的团队不少见——一上来就堆记忆系统和多角色编排,结果连工具调用都不稳。先让循环跑通,再往循环里加模块,是失败率最低的路径。
一张表看清核心区别
| 维度 | LLM(对话形态) | Agent(执行形态) |
|---|---|---|
| 交互单位 | 一次问答 | 一个任务的多步循环 |
| 状态 | 会话内上下文 | 短期 + 长期记忆 + 外部状态 |
| 纠错来源 | 用户重新提问 | 环境与工具的真实反馈 |
| 输出 | 文本 | 文本 + 对真实系统的改动 |
| 失败处理 | 无 | 重试、重规划、降级、转人工 |
| 责任边界 | 提示词工程 | 提示词 + 权限 + 审计 + 停止条件 |
面试怎么答
30 秒版本分三层:定义层——LLM 是生成器,Agent 是 LLM 加规划、记忆、工具的执行框架;机制层——行动、观察、修正的循环;工程层——每个模块引入的新问题和对应护栏。三层递进,比背定义高一个档位。
常见追问有两个。一是「既然 Agent 就是工作流加模型,什么任务根本不需要 Agent?」答法:步骤固定、没有分支决策的流程,写死的工作流更便宜也更稳。二是「Agent 的记忆和 RAG 有什么区别?」答法:RAG 解决“回答之前查资料”,记忆解决“跨会话记住这个用户和这个任务”,两者的写入端和管理方式完全不同。
容易被扣分的说法也要避开:把 Agent 说成“更智能的聊天机器人”,说明没理解执行结构;说“Agent 就是套了个提示词的模型”,说明没做过工具层;只背四模块名词、说不出每个模块的代价,会被追问到哑火。
要点复盘
- LLM 会答,Agent 会做:分界线是行动、观察、修正的循环是否存在。
- 四模块清单(画像、记忆、规划、行动)可以当架构检查表用:逐项问自己“这个系统有没有、护栏在哪”。
- 答出每个模块的代价,比答出定义更能体现工程经验。
- 停止条件、记忆写入门槛必须是代码层面的机制,不能停留在提示词。
参考答案要点
LLM 是被动的文本生成器,不能执行、没有反馈、状态不跨会话;Agent 是 LLM 加规划、记忆、工具的工程框架,围绕目标走“行动、观察、修正”的循环。规划解决长任务拆解,但带来死循环风险,所以停止条件要做成工程机制;记忆解决跨会话状态,但要管住写入门槛,别把错误结论存成长期事实。最后收一句:不是所有任务都该上 Agent,步骤固定的流程用工作流更稳,要不要自主性,取决于任务本身的不确定性。