让模型处理「用户反馈订单一直没到,去查一下原因」。用 CoT 提示词,模型输出一段漂亮的推理:「首先我应该查询订单状态,然后查看物流信息,如果物流显示异常,我应该……」每一步都像模像样,但什么都没发生。这正是面试官问「为什么选择ReAct」(AgentAlpha 面试题库 · 腾讯篇)时想挖的点:你能不能说清 CoT 到底缺了哪一块。
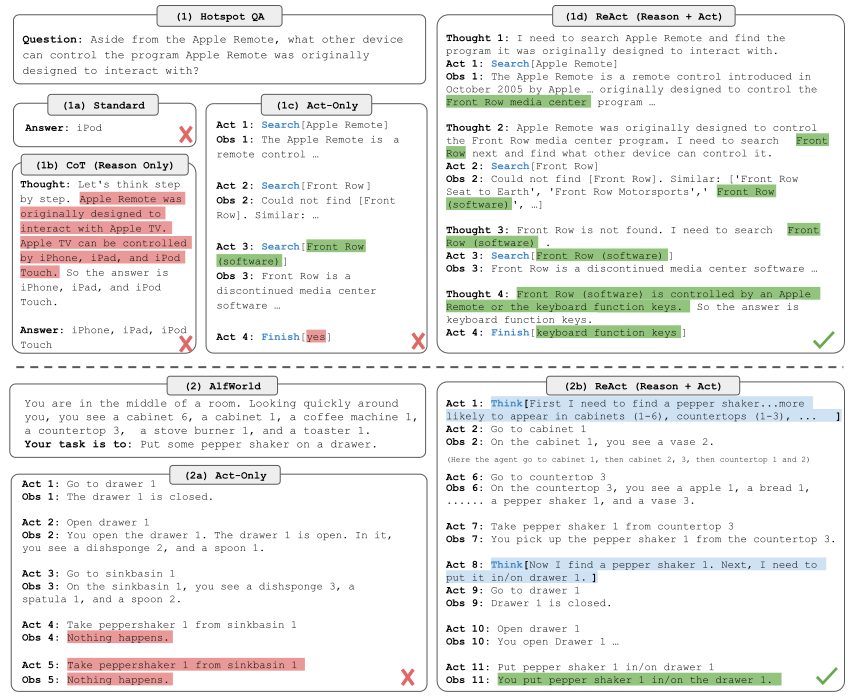 图:四种提示方法的对比实验(同一组任务上:Standard 直接答题、CoT 先写推理再答、Act-only 只执行不思考、ReAct 想一步做一步再看观察结果;带环境反馈的 ReAct 在 HotpotQA 与 ALFWorld 上成功率都明显更高)
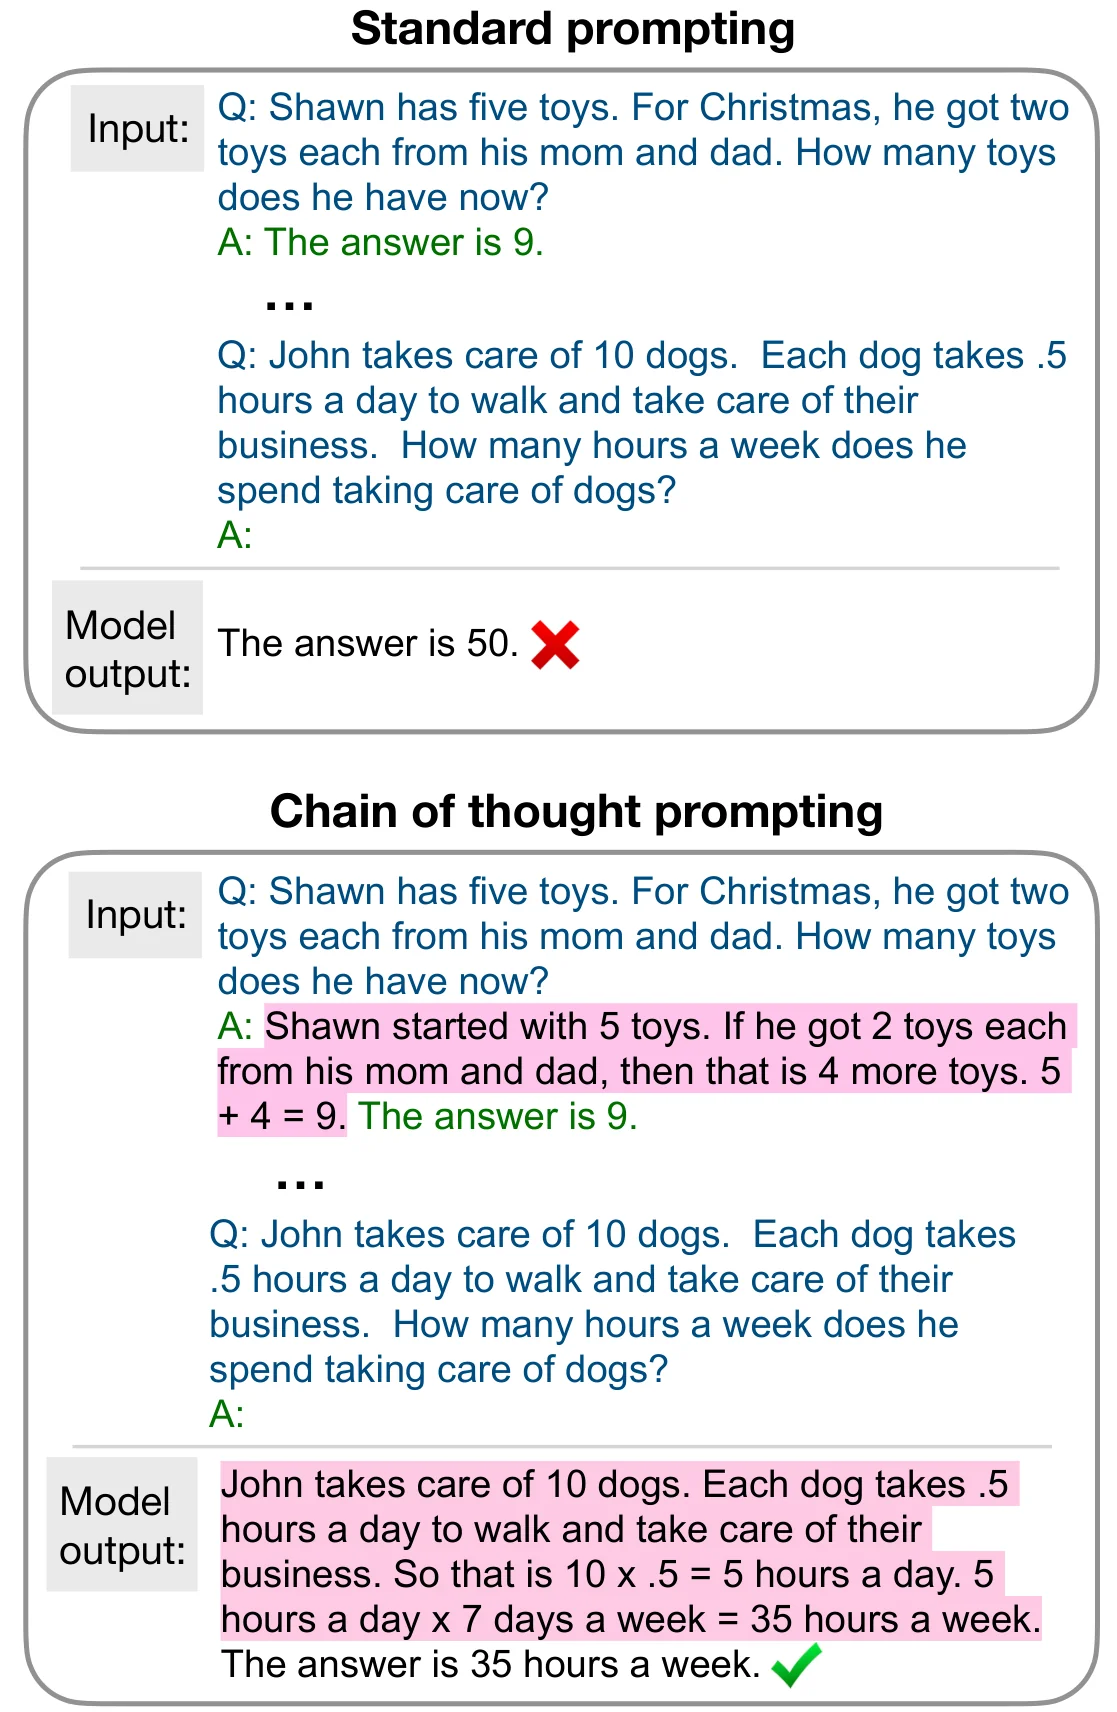 图:同一道数学题的两种提示(标准提示直接要答案,一步猜错全错;思维链提示先写出中间推理步骤再作答——多步推理任务的准确率因此大幅提升)
 会想 ≠ 会做:CoT 与 ReAct 的差别就在这条循环。
先说结论
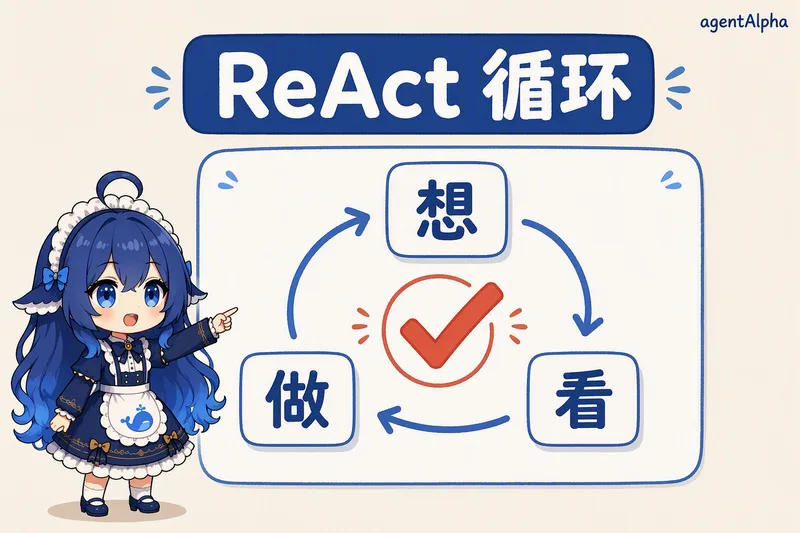
CoT 只让模型“把推理写出来”,推理停留在纸面:不能执行动作,也拿不到环境的真实反馈,前提错了就一路错到底。ReAct 在推理和行动之间加了交替循环——想一步、做一步、看结果、再想——推理由此落地,错误能被环境当场纠正。Agent 的底层逻辑就是这个循环,而不只是“会推理”。
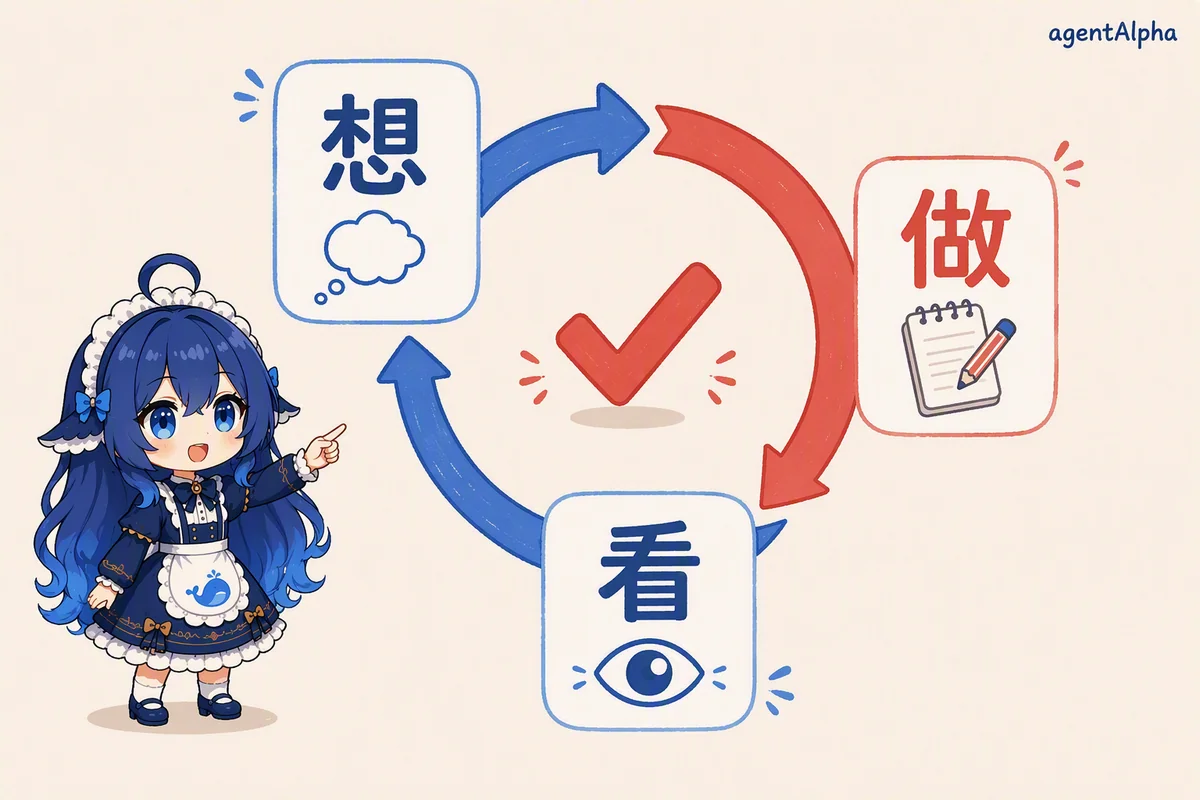 图:小蓝图解——ReAct 循环:想一步、做一步、看反馈。
CoT:纸面推演的天花板
CoT(Chain-of-Thought,思维链)出自 2022 年的论文:在提示里给几个带中间推理步骤的示例,让模型在回答前先写出推理过程。它确实提升了复杂推理任务的表现,这个贡献是实的。
但它的输出从头到尾都是文本,有三个硬边界。
- 没有动作。“查询订单”只是推理里的一句台词,没有任何工具被调用。
- 没有观察。推理需要的事实只能靠模型脑补,脑补错了,后面每一步都在错误前提上叠加。
- 没有纠错。步骤之间没有反馈通道,一错到底,最后输出一个自信满满的错误答案。
所以 CoT 适合数学题、逻辑题这类“答案在脑袋里就能推出来”的任务;一旦任务的事实在外部系统里,它就无能为力。用一句话概括:CoT 把推理“写”出来给人看,任务却要“做”出来才算数。反过来也有被滥用的场景:给“2 加 2 等于几”也套上多步循环,属于杀鸡用牛刀,成本和延迟都吃亏。
ReAct:Thought → Action → Observation
ReAct(2022)的核心改动很小,影响很大:让模型交替生成推理轨迹和动作,动作交给环境执行,返回的观察回填进上下文,供下一轮推理使用。
一轮循环长这样:
- Thought:用户说订单没到,我先查订单状态。
- Action:query_order(order_id=xxx)
- Observation:订单已发货,物流停在转运中心 5 天。
- Thought:卡在物流环节,不是商家问题,接着查物流工单。
同一个任务,CoT 写的是“我应该查订单”,ReAct 真的调了查询接口,并拿到“卡在转运中心”这个事实。前者的答案靠脑补,后者的答案有出处。ReAct 论文在问答、事实验核和交互式决策类任务上验证了这条路线:推理引导行动,行动产生观察,观察修正推理。
这个循环还有一层 CoT 完全没有的能力:从错误里恢复。假设查询时订单号填错了,接口返回“订单不存在”,这个报错会作为观察回到模型面前,下一轮 Thought 就会检查参数、换一种查询方式。报错不再是终点,而是下一条线索。单次生成的 CoT 遇到同样的情况,只会把“订单不存在”脑补进结论,继续往下编。
同一个任务,两种方案差在哪
| 维度 | CoT | ReAct |
|---|---|---|
| 输出形态 | 一段推理文本 | 推理 + 工具调用 + 观察的循环 |
| 事实来源 | 模型参数内的记忆 | 外部环境与工具的真实返回 |
| 出错之后 | 一路错到底 | 被观察当场纠正,可换路线 |
| 中间过程 | 只对最终答案有用 | 每步可检查、可审计 |
| 适用任务 | 答案可内部推导的问题 | 事实在外部系统、需要动手的任务 |
中间过程这一行值得展开:ReAct 的每一步 Thought 都解释了“为什么做这个动作”,天然就是审计日志。在企业场景里,这一点常常比准确率更重要——出了问题,你要能回答“系统当时为什么这么做”。
ReAct 的局限:循环会失控
腾讯篇和美团篇都考过同一道题:「ReAct 循环如何设置停止条件,避免无限思考和重复调用?」(AgentAlpha 面试题库 · 腾讯篇 / 美团篇)——问的就是这个范式的代价。
- 死循环:观察没给出模型想要的信息,它会反复调同一个工具。最大步数、重复动作检测、预算上限都得做成硬约束。
- 成本膨胀:每轮都带着全部历史进上下文,步数越多,单任务 token 成本越高。
- 观察噪声:工具返回一大段原始日志,反而把推理带偏,观察需要裁剪和结构化。
- 上下文溢出:长任务历史挤爆窗口,需要压缩和外部记忆配合。
工程上的答案,是把 ReAct 嵌进一个有边界的执行器:步数、预算、重复检测、失败分类,全部落在代码层,不指望模型自觉。
哪些环节值得保留循环,也有讲究:查看、检索这类只读操作,循环代价低,可以放开跑;带写操作的任务,每一步都该有确认或回滚预案,循环步数收紧。护栏的松紧跟着副作用走,不跟着任务难度走。
面试怎么答 / 要点复盘
30 秒版本:CoT 只生成推理文本,不能执行、不能被环境纠错;ReAct 用 Thought、Action、Observation 的交替循环,让推理获得真实反馈;代价是循环可能失控,要用停止条件和预算控制兜住。
容易被扣分的说法:把 ReAct 说成“就是个提示词模板”——它更像一个执行协议,观察回填和停止条件都是工程机制;把 CoT 说得一文不值也不对,答案可内部推导的任务里,CoT 一次生成的成本远低于多轮循环。
追问预测:「ReAct、Plan-and-Execute、ReWOO 与状态机分别适合什么任务?」(AgentAlpha 面试题库 · 字节篇)答法按任务结构选:步数少、需要边做边看的用 ReAct;步骤多、依赖清晰的先规划再执行;流程高度确定的直接上状态机。
要点复盘:
- CoT 的天花板:没有动作、没有观察、没有纠错。
- ReAct 的本质:推理和行动交替,观察回填上下文。
- 停止条件、预算、观察裁剪,是把 ReAct 从 demo 变成系统的三件事。
参考答案要点
CoT 只能想不能做:推理是纸面推演,事实靠脑补,错了没有任何反馈通道。ReAct 加了交替循环——想一步、做一步、看结果——推理从此接上真实环境,错误能被观察当场纠正,中间过程还天然是审计日志。但循环会失控:不设停止条件就会反复调同一个工具,token 成本也随步数膨胀,所以我会把最大步数、重复检测、预算上限做成代码层护栏。最后收一句:ReAct 是 Agent 的底层逻辑,但不是所有任务的默认选择——流程固定的任务,状态机和工作流更便宜、也更稳。