同一条用户请求,上午跑通了,下午就少传一个参数。换个说法问同一个问题,模型挑了另一个看起来差不多的工具。demo 阶段一切正常,接上真实流量之后,错误像开盲盒——几乎每个做过 Agent 的团队,都被 Function Call 的「时好时坏」折磨过。
面试里问「为什么不稳定」,最常见的差答案是「模型能力不行」。这句话既定位不了问题,也带不出解法。这一篇把一次工具调用拆开,看不确定性到底从哪来、在哪一层被放大、用什么手段压住。
 调用之前,先过校验(放大镜下的调用卡片参数缺一块、被红章驳回——模型给出的参数必须过 Schema 校验才能真正执行)。
先给一个能复述的答案
Function Call 不稳定的根源,是一个概率模型在不确定的上下文里被迫做确定的选择。不确定性主要有三个来源:Schema 没写清,模型只能靠猜;上下文被污染,历史信息带偏判断;缺少校验和重试,错误直接落进执行器。所以稳定性首先是工程问题:给每一处不确定加约束——规范 Schema、治理上下文、加校验层和带上限的重试——而不是指望换一个更贵的模型一步到位。
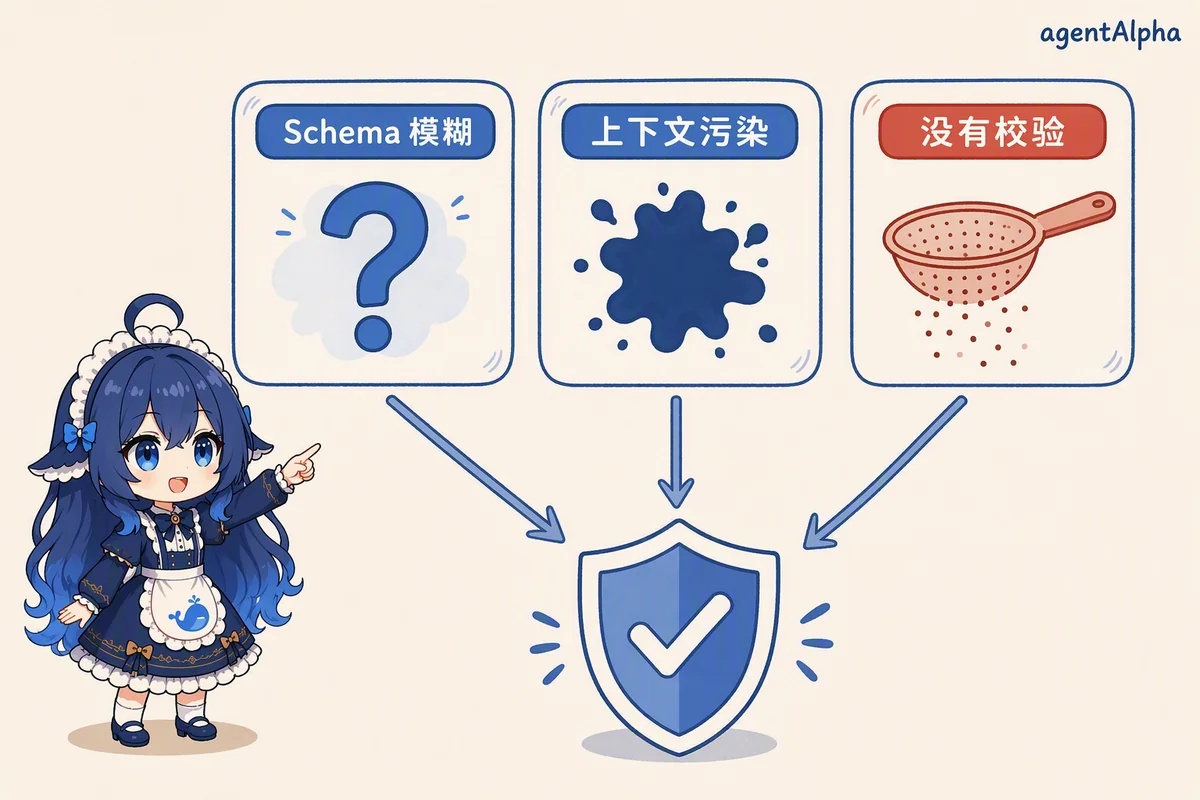 图:小蓝图解——Function Call 不稳的三个来源与三道防线。
一次调用里藏着四次概率选择
先建立一个判断框架。一次 Function Call 看起来是「一个动作」,实际上是模型连续做对的四个决定:
- 选工具:候选列表里挑哪一个;
- 绑参数:每个字段填什么值,值从上下文哪里取;
- 排格式:输出是否符合 JSON Schema;
- 定后续:拿到工具返回后,任务算完成还是继续调用。
四步都是概率采样,任何一步偏了,整次调用就错了。模型不是在「不确定」的事上不可靠,而是在不该不确定的地方被逼着猜。你要做的不是消灭概率,而是把每一处猜测换成明确约束。
| 失败表现 | 直观感受 | 背后的不确定来源 |
|---|---|---|
| 选错工具 | 明明有更合适的函数,它挑了个近似的 | 候选描述含糊、多个工具职责重叠 |
| 参数幻觉 | 编造订单号、猜单位、漏必填字段 | Schema 约束缺失、上下文里没有可靠取值 |
| 格式漂移 | JSON 里混进注释、字段名拼错 | 缺少输出校验与失败反馈 |
| 死循环重试 | 反复调用同一个失败的工具 | 没有停止条件和错误分类 |
字节题库里有一道题直接把这个框架当考点:
「Agent 的结构化输出持续不稳定时,Prompt、Schema、解码和校验层如何协同?」 —— AgentAlpha 面试题库 · 字节篇
注意题目把四层并列——面试官想听的正是「分清哪一层引入了不确定、哪一层负责消掉它」,而不是一句「调调 Prompt」。
来源一:Schema 不规范,模型只能猜
Schema 是模型的岗位说明书。模型对工具的全部理解,就来自函数名、参数名和 description 这几行字,任何含糊都会被它用概率填满。
典型的不规范写法:参数叫 time,不说清是时间戳、ISO 字符串还是「几分钟后」;该用枚举的字段放成自由字符串,模型自己发明取值;必填和可选不分,模型要么漏传、要么全填;多个工具描述高度相似,边界没人写明。
工程做法是把这些含糊逐条消掉:取值封闭的字段一律枚举;description 写清单位、时区、取值范围和互斥关系;职责重叠的工具做合并或拆分。一个实用的检验标准:让没看过实现的同事只读 Schema 猜参数,他猜不对的地方,就是模型会猜错的地方。
常见的坑是把补丁写进 Prompt:Schema 里含糊,Prompt 里再解释一遍。两处一旦不一致,模型反而多了一层冲突要猜。
来源二:上下文污染,历史把判断带偏
模型每次决定怎么调用,看的是整个上下文,而不只是当前问题。上一轮失败的调用、被截断的工具返回、别的工具的同名字段,都会变成干扰项。
常见污染源有三类:工具返回的原始日志又长又乱,挤占注意力;失败轨迹留在历史里,模型下一轮照着错误继续走;对话越长,早期的任务约束被稀释得越厉害。
对应的治理手段:工具结果进上下文前做摘要和裁剪,只留任务相关字段;失败轨迹要么压缩成一句教训,要么显式标记「这条路径已失败」;长会话做阶段性收敛,把已完成的决策固化成结论。字节题库里有一道题考的就是这件事:
「工具返回几十万 Token 日志时,应该如何抽取、分层存储和按需回放?」 —— AgentAlpha 面试题库 · 字节篇
一句话总结这道题:上下文不是越长越好,是越相关越好。
来源三:没有校验层,错误直接落进执行器
前两个来源是「引入不确定」,第三个来源是「不拦不确定」。不少系统的模型输出直连执行器:JSON 合不合法没人验,参数值在不在范围内没人查,错了也照样执行,最后在业务侧爆出一个难排查的故障。
运行时防御分四层:
| 防御层 | 拦什么 | 实现方式 |
|---|---|---|
| 格式校验 | 非法 JSON、缺字段、类型错 | JSON Schema 校验,失败即拒收 |
| 取值校验 | 枚举越界、范围不对、依赖缺失 | 按业务规则写参数断言 |
| 反馈重试 | 可自动修复的错误 | 把校验报错拼回上下文,让模型改 |
| 降级兜底 | 重试仍失败的任务 | 次数熔断,转规则分支或人工 |
重试的关键设计是「反馈什么」。只说「失败了再来一次」,模型大概率原样重复;把校验器的具体报错——哪个字段、什么类型、合法范围——拼回上下文,模型才有修正依据。重试必须带上限,一般两到三次,超过就走降级,否则一次坏请求能烧掉十次调用的成本。
Reflexion把「反馈驱动修正」推得更远:它让 Agent 在任务失败后生成一段自然语言的反思,存进记忆,下一轮尝试带着教训重跑,不更新任何模型参数就能改善后续表现。这验证了一件事:很多调用错误不需要重训模型,缺的只是一个能记住失败、反馈失败的运行时机制。
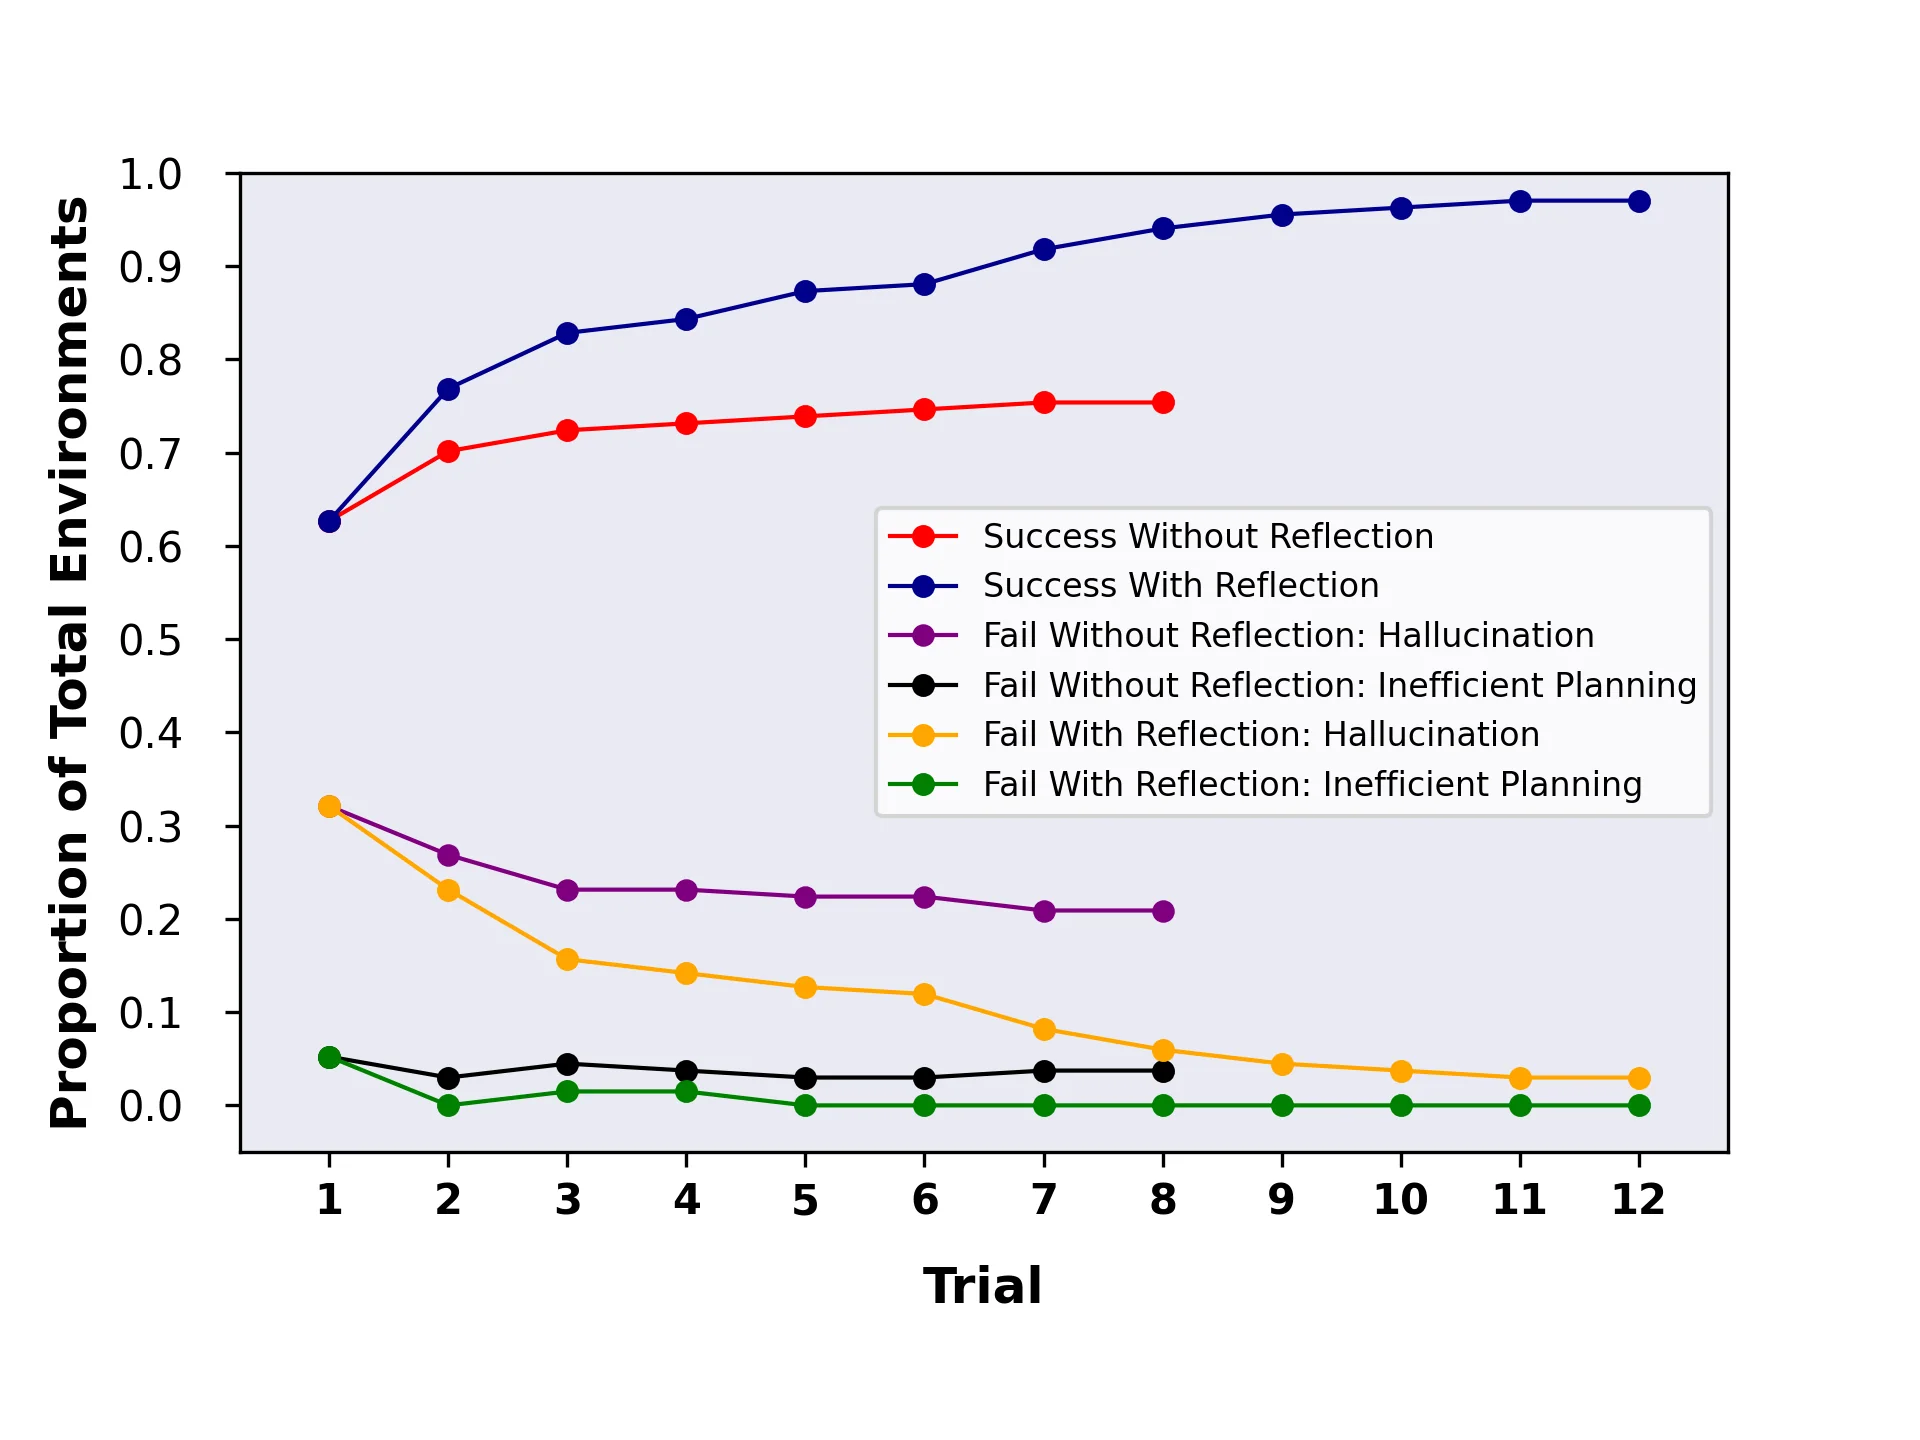 图:Reflexion 的自我反思架构(Actor 负责生成动作,Evaluator 给结果打分,反思模型把失败原因写成文字反馈存进记忆,下一轮 Actor 带着教训重试)
把稳定性当成系统属性来验收
说完三层来源,给一个面试和工程里都实用的收束:稳定性不是模型属性,是系统属性。一条可验收的工具调用链路至少要有四件套:规范的 Schema(约束输入)、干净的上下文(约束判断)、校验层与带反馈的重试(拦输出)、错误分类与降级(兜失败)。
再往上一层是可观测:每次调用的 Prompt、模型原始输出、校验结果、重试次数都要落日志。不稳定的错误是概率性的,只有靠日志聚合才能看出哪类错误占比最高、先修哪一层。靠感觉调 Prompt,等于闭眼修车。
面试迁移
追问预测——答完三大来源,面试官通常往这几个方向追:
- 「校验层具体怎么实现?」——JSON Schema 校验加业务断言,报错信息回传给模型重试;
- 「重试会不会放大问题?」——带上限和错误分类,不可恢复的错误直接降级,不进重试队列;
- 「Prompt、微调、校验层,投入顺序怎么排?」——先校验层(当天见效),再 Schema 与 Prompt(降发生率),最后才是微调(成本最高);
- 「反思机制会不会越反思越差?」——反思要由新证据触发,没有新失败信息的「再想一遍」只是空转。
容易扣分的说法:「换更强的模型就稳了」「把 Prompt 写细一点就行」。这两句都把系统问题说成了模型问题,面试官会判断你没有维护过线上 Agent。
要点复盘
- 不稳定 = 概率模型在不确定上下文里做确定选择,三大来源:Schema 含糊、上下文污染、无校验重试;
- Schema 治理:枚举、单位、时区、互斥写进描述,职责重叠的工具先合并;
- 上下文治理:工具结果摘要裁剪、失败轨迹显式标记、长会话阶段性收敛;
- 运行时防御四层:格式校验、取值校验、反馈重试、降级兜底,重试必须带上限;
- Reflexion 证明失败反馈可以不训练模型就改善行为,但反思要由新证据触发;
- 错误分类靠日志聚合,先修占比最高的一层,不靠感觉调 Prompt。
参考答案要点
参考回答:
Function Call 不稳,本质是概率模型在不确定上下文里被迫做确定选择。不确定来自三处:Schema 含糊让模型猜参数,上下文污染带偏工具选择,没有校验层让错误直落执行器。我的做法是分层防御:Schema 上用枚举和描述写清取值边界;上下文里对工具结果做摘要裁剪;输出侧加 JSON Schema 校验,把具体报错回传给模型做带反馈的重试,重试带上限、超限降级。常见的坑是把重试做成无脑循环——不回传具体报错,模型只会原样重复同一个错误。最后这是个权衡:校验和重试会引入额外延迟和成本,对错误率低、可幂等的调用不必全上,按工具的风险等级分层配置。