「Function call 怎么训练的?怎么微调的?」——这道题最常见的答案是「准备一批问答对,做 SFT」。答到这里就断了:数据从哪来、除了正样本还要什么、合成数据和真实日志怎么选,一个都接不上。
丢分的根源是把它当成了普通对话训练。Function Call 的训练数据不是一问一答的集合,而是带完整轨迹的任务样本集——工具怎么注册、对话怎么演进、调用错在哪、怎么修正,都在轨迹里。
先说结论
构建思路是「先定训练目标,再配数据形态」:围绕工具选择、参数绑定、格式化、多轮修正四个能力,组织正样本、负样本、拒绝样本和纠错轨迹;合成数据负责覆盖面,真实日志负责贴近线上分布;最后按错误层次决定投入——格式问题修工程,知识问题 LoRA 轻训,行为问题 SFT 加 DPO。
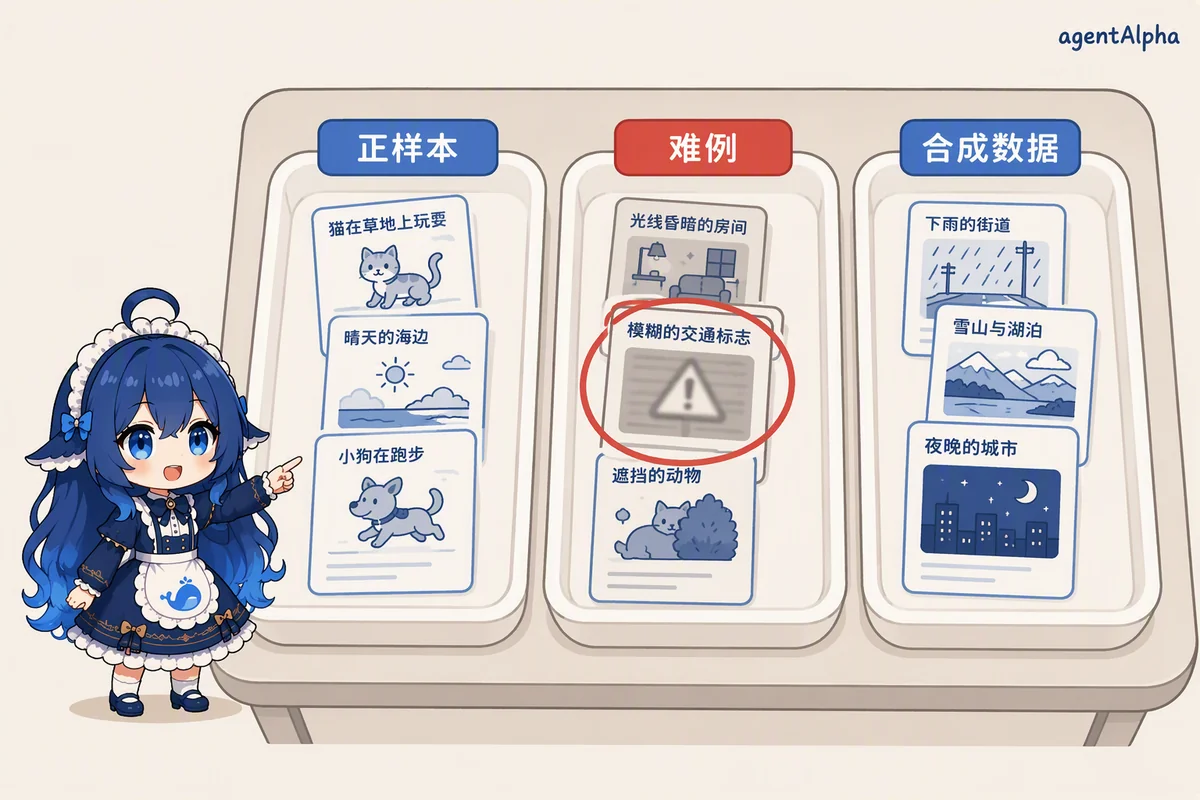 图:小蓝图解——训练数据的三类托盘:正样本、难例、合成。
四个训练目标,四种样本形态
模型要学会的不是「输出一段 JSON」,而是四个能力,每个能力对应不同的样本形态:
| 能力目标 | 模型要学会什么 | 对应样本形态 |
|---|---|---|
| 工具选择 | 候选里挑对工具;无工具可用时拒答 | 带干扰工具的候选集样本;明确的拒绝样本 |
| 参数绑定 | 取值从上下文和工具返回里来,不编造 | 取值来源可追溯的调用;缺值时先澄清的样本 |
| 格式化 | 稳定产出合法调用格式 | 覆盖长参数、嵌套结构、边界值的格式样本 |
| 多轮修正 | 依赖前序结果;报错后修正再试 | 失败、报错、修正、成功的完整轨迹 |
美团篇还有一道配套题:「Function call怎么把下游的一些工具,插件变成模型可以理解的方式?」(AgentAlpha 面试题库 · 美团篇)——训练数据就是这道题的答案实体:每条样本把工具注册信息、对话历史、该产出的调用对齐成一条轨迹,这个对齐本身就是「翻译」。
正样本之外,难例才是分水岭
只用成功轨迹训练,模型学到的先验是「每问必调、一调就对」。线上从来没有那种世界。
要刻意构造四类样本:
- 无效调用样本:参数越界、调用不存在的工具,让模型学会看到报错后修正,而不是硬编下去;
- 拒绝样本:请求超出工具能力时明确说做不到。没有这类样本,模型会把「答不了」扭曲成一个看起来像样的错误调用;
- 歧义难例:多个工具都能完成任务。字节篇考过标签设计:「一个 Query 有两个正确工具时,训练标签如何设计才不会惩罚合理策略?」(AgentAlpha 面试题库 · 字节篇)两种正解:一条样本挂多个参考答案,任一命中算对;或者把选择做成偏好数据,不设唯一标签;
- 纠错轨迹:真实任务里完整的失败、修正、成功过程,这是多轮修正能力的唯一来源。
配比没有万能数字,原则只有一条:难例配比跟着线上错误分布走。日志里参数类错误占大头,训练集里参数难例就该占大头,闭门造车的配比只是自我安慰。字节篇把字段级要求也考了:「工具调用训练数据应该包含哪些字段?无效调用和拒绝调用样本怎样构造?」(AgentAlpha 面试题库 · 字节篇)
合成数据与真实日志的取舍
两条来路各有分工。
合成数据的优势是快、覆盖广、能定向补难例;风险是分布偏置——用模型生成数据再教模型,等于让一个学生的错题本来自另一个学生的错题本,口味会自我强化,难度也难控。
真实日志贴近线上分布,但脏:要脱敏、去重,还要剔除偶然成功——那次调用碰巧对了,不代表策略可复制。字节篇考过筛法:「如何从线上轨迹中筛选 Agent RL 数据,避免把偶然成功当成优质样本?」(AgentAlpha 面试题库 · 字节篇)
大规模合成的代表是 ToolLLM:从上万条真实 API 的文档出发,自动生成多样的工具调用指令,覆盖单工具与多工具链场景;配一个 API 检索器为每条指令缩小候选范围,再用这些数据微调出 ToolLLaMA;配套的 ToolEval 用通过率和胜率做自动评测,论文报告这个开源模型在评测上接近当时 ChatGPT 的工具调用水平。它验证了两件事:合成数据足以把工具调用能力教到可用;评测集必须独立于合成管线——不然就是既当运动员又当裁判。
字节篇的这道题就是合成管线的验收清单:「合成训练数据如何做质量过滤、难度分层和去重?」(AgentAlpha 面试题库 · 字节篇)——事实校验对齐真实 API 文档,按难度分层做课程,按语义去重防止模板复读。
LoRA 轻训还是 SFT 加 DPO 重训
先说名词:LoRA 是只训练少量附加参数的低成本微调;SFT 是用标注样本做监督微调;DPO 是直接拿成对偏好数据调行为、不需要另训奖励模型的方法。
按错误层次决定投入:
| 问题层次 | 现象 | 值得的投入 |
|---|---|---|
| 工程层 | 格式偶尔不合法、参数没人校验 | 校验层加报错重试,不用训练 |
| 知识层 | 选错工具、参数幻觉率高 | SFT 或 LoRA,喂领域工具的正负样本 |
| 行为层 | 该拒绝不拒绝、多工具该选谁摇摆 | SFT 之后接 DPO,用偏好数据校行为 |
边界判断只有一句话:先确认错误不是工程层造成的,再谈训练。Schema 含糊、没有校验层造出来的错误,样本再多也教不会模型——你只是把工程债训进了参数,这是最贵也最冤的修法。
阿里篇把这组要求合成一题:「工具调用模型的训练集应包含哪些正例、负例、拒绝例和纠错轨迹?」(AgentAlpha 面试题库 · 阿里篇)——能按这四类报出样本形态和构造方法,这道题就过线了。
面试迁移
追问预测:
- 「合成数据怎么防止越训越偏?」——事实校验对齐真实 API 文档;评测集独立于合成管线;难度分层避免全是简单样本;
- 「训练标签遇到多解怎么办?」——多参考答案或偏好对,不给唯一标签;
- 「怎么判断该训练了而不是该修工程?」——错误归因:换 Schema 表述、加校验层能消掉的错误,不该进训练集。
容易扣分的说法:「SFT 一把梭」「数据越多越好」。前者忽略行为层需要偏好数据;后者忽略脏数据的伤害比缺数据大。
要点复盘
- 数据形态是带完整轨迹的任务样本,不是一问一答;
- 四个训练目标:工具选择、参数绑定、格式化、多轮修正,各有对应样本;
- 必配四类非正样本:无效调用、拒绝、歧义难例、纠错轨迹,配比跟线上错误分布走;
- 合成数据管覆盖,真实日志管分布,评测集必须独立于合成管线;
- 训练投入按错误层次走:工程层修代码,知识层 LoRA 或 SFT,行为层上 DPO。
参考答案要点
Function Call 的训练数据围绕四个能力构造:会选工具、会绑参数、会排格式、会在多轮里修正,形态是带完整轨迹的多轮样本。正样本之外必须刻意造难例:无效调用、拒绝样本、多工具歧义的偏好数据、失败后修正的轨迹,配比跟着线上错误分布走。数据来源两条腿:合成数据保覆盖面,但要事实校验和难度分层;真实日志贴近分布,但要去重、脱敏、剔除偶然成功。常见的坑是把工程债训进模型——Schema 含糊和缺校验造成的错误,训练救不了,先修工程。投入边界:知识层错误 LoRA 或 SFT 轻训就够,行为层问题才上 DPO。