你的 Agent 上线了,Function Call 偶尔出错:有时挑了个功能相近但不对的工具,有时参数里编了个不存在的订单号,有时输出的 JSON 干脆少个括号。例会上这些错误被笼统归因成「模型还不稳」,然后不了了之。
面试里问「Function Call 准确率怎么提升」,最吃亏的两种回答是「换个更强的模型」和「Prompt 再调调」——都没说出任何可执行的机制。面试官想听的是:你能不能先把错误分类,再让每一类错误对应一个具体手段。
先说结论
准确率是整条调用链路的属性,不是模型单点的属性。做法是先把调用错误分成三类——选错工具、参数幻觉、格式错误,再按层治疗:Schema 设计压参数幻觉,动态函数路由压选错率,先想再做压多步任务的累积错误,结果校验层兜住格式与取值,日志聚合告诉你先修哪一层。
下面按这条链路从入口到出口走一遍。
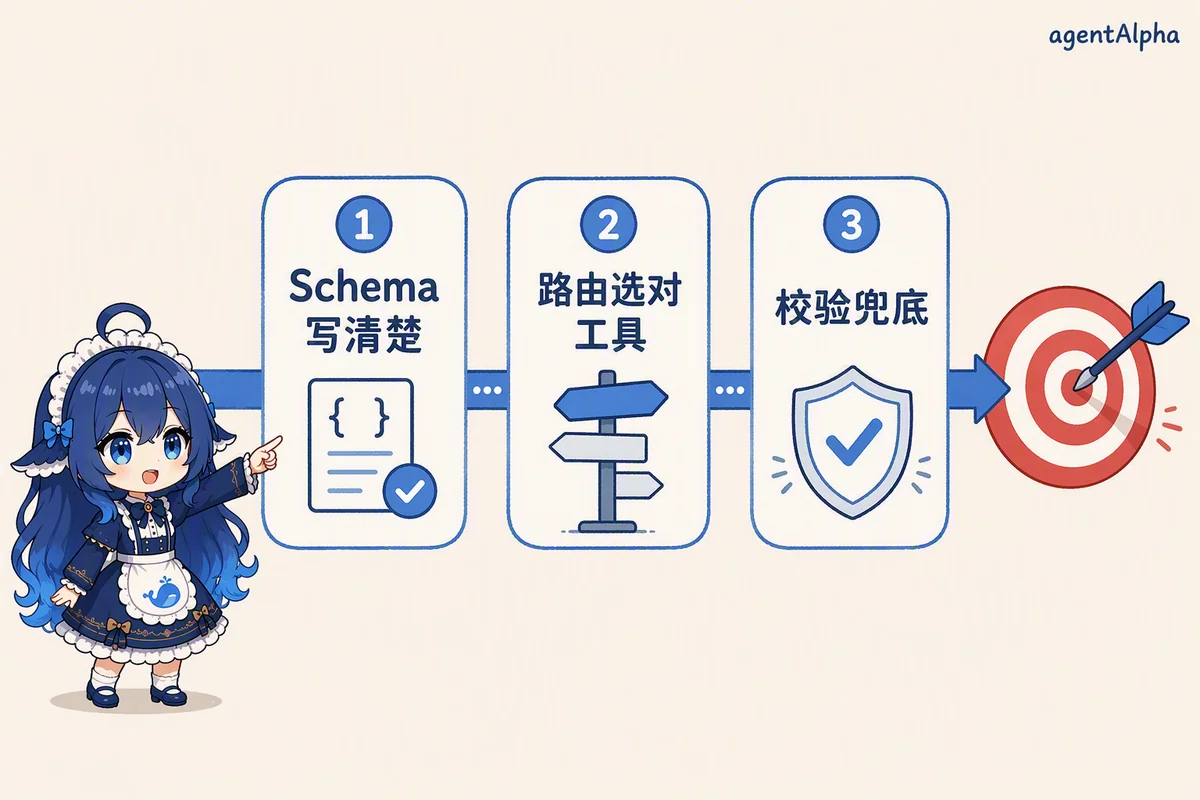 图:小蓝图解——FC 准确率链路:Schema、路由、校验。
三类错误,三张不同的处方
一次 Function Call 是模型连续做的三个决定:挑哪个工具、参数填什么、输出排成什么格式。三个决定独立会错,混在一起看就是一团乱。
| 错误类型 | 典型表现 | 主要根因 | 对应手段 |
|---|---|---|---|
| 选错工具 | 挑了功能相近但不对的工具;该调用却直接口答 | 工具描述含糊、候选过多、职责重叠 | Schema 写清边界、动态路由裁剪候选集 |
| 参数幻觉 | 编造取值、漏必填、单位时区错 | Schema 约束缺失、上下文里没有可靠取值 | 枚举与取值约束、必填标注、缺值时澄清反问 |
| 格式错误 | JSON 不合法、字段名拼错、混入闲聊文本 | 输出无人校验、出错无反馈 | 格式校验、报错回传重试、超限降级 |
字节题库里有一道题,把这个分类思想直接写进了题干:
「工具 Schema 应如何设计,才能降低选错工具和参数生成错误?」 —— AgentAlpha 面试题库 · 字节篇
注意题目把「选错工具」和「参数生成错误」并列。分不清错误类型,就没有资格谈准确率——三类错误的修法完全不同,甚至互相冲突:为了减少选错而砍掉候选工具,可能让另一些任务直接失去正确选项。
Schema:投入产出比最高的一层
Schema 是模型认识工具的唯一入口:函数名、参数名、description,模型对工具的全部理解就这几行字。含糊一笔,模型就用概率把它填满。
值得逐条落实的写法:取值封闭的字段一律用枚举;description 写清单位、时区、取值范围和互斥条件;必填与可选分明;职责重叠的工具先合并或拆分,再上线。阿里题库把这组要素列得很全:
「工具 Schema 怎样表达必填参数、互斥条件、枚举、权限和副作用?」 —— AgentAlpha 面试题库 · 阿里篇
Schema 之所以优先级最高,是因为它零架构成本:不训练、不加服务、当天生效。在 Schema 治理好之前谈微调和换模型,等于地基没平就开始装修。
候选太多,就先路由再调用
工具过了几十个,很多「选错工具」其实不是模型不会选,而是候选集太杂:功能相近的工具互相干扰,描述越长注意力越散。这时该在模型之前加一道动态函数路由——请求进来,先由一个轻量组件召回 top-k 个候选工具,模型只在小集合里做选择。
常见实现有两种:意图分类(按业务场景把请求归到一组工具)和向量检索(把工具描述向量化,按相似度召回)。实现细节可以单独展开,这里只强调一个被验证过的思想。Gorilla微调了一个专做 API 调用的模型,它在推理时检索最新的 API 文档拼进上下文,让模型对着「当下真实」的文档生成调用,而不是依赖训练时记住的旧版本;论文用抽象语法树(AST)比对来判断生成的调用是否正确。把「靠记忆」换成「靠检索」,是缓解调用幻觉的一条已验证路径——路由、检索式调用、RAG,底层是同一个动作。
字节题库里对应的就是这道:
「一个 Agent 有几百个工具时,怎样做工具检索、路由和候选集裁剪?」 —— AgentAlpha 面试题库 · 字节篇
多步任务:把「先想再做」接进链路
单步任务的错误,前面两层手段基本能压住。剩下的错误集中在多步任务:第 N 步的参数依赖第 N−1 步的工具返回,一步错,步步错。
这里需要把推理显式接进调用循环。ReAct让模型交替生成推理和动作,工具观察回填上下文,每一步的选择有依据、错误能被当场纠正。任务更长、依赖更复杂时,再加 Plan-Execute:先产出结构化计划,再逐步执行,冲突时重新规划。这一套的机制站内有专文展开,这里只强调它对准确率的贡献:把「长链一次对」拆成「短步多次对」,每一步的错误半径从整个任务缩小到单步。
校验层兜底,日志说了算
链路出口是校验。模型输出先过格式校验(JSON Schema、必填字段),再过取值断言(枚举、范围、业务规则),失败把具体报错回传给模型做带反馈的重试,重试带上限,超限降级。工具的返回结果同样要校验:返回为空、字段缺失、语义明显不符,都不要直接喂给下一步——喂进去的脏结果,会在多步任务里变成下一步的参数幻觉原料。
最后一步是调优,也是大多数团队缺的一步:把每次调用的 Prompt、输出、校验结果、重试次数落日志,按错误类型聚合占比,先修占比最高的那层。度量口径也要分层——工具选择对不对、参数对不对、最终任务成没成,是三个指标。阿里题库直接考这个:
「怎样评测工具选择、参数正确性、调用顺序和最终任务完成质量?」 —— AgentAlpha 面试题库 · 阿里篇
只看最终任务成功率,会把三层错误混在一起,你永远不知道该修哪里。
面试迁移
追问预测:
- 「这些手段的投入顺序怎么排?」——Schema 与校验层先行,工程侧当天见效;路由看工具规模,过百再上;微调放最后,先确认错误不是工程层造成的。
- 「路由的 top-k 怎么定?」——k 太小漏召正确工具,k 太大噪声回来;按漏召与选错两类错误率监控来调。
- 「Gorilla 那种检索式调用什么时候值得上?」——工具或文档频繁变更、候选集大的场景;工具固定且少时收益有限。
容易扣分的说法:「准确率低就换更强的模型」「把 Prompt 写细就行」。两句都把链路问题说成单点问题,说明没维护过线上 Agent。
要点复盘
- 先分类再治疗:选错工具、参数幻觉、格式错误,修法各不相同;
- Schema 是性价比最高的一层:枚举、单位、必填、互斥写清楚,当天生效;
- 候选集大就先路由:Gorilla 验证了「检索替代记忆」能压调用幻觉;
- 多步任务用先想再做:把长链一次对拆成短步多次对;
- 校验层连工具返回一起管,脏结果会变成下一步的幻觉原料;
- 分层度量加日志聚合定修复优先级,只看最终成功率等于闭眼修车。
参考答案要点
Function Call 准确率是链路属性,我的方法是先分类再治疗。选错工具去治候选集:Schema 写清工具边界,工具多了就加动态路由,只给模型 top-k 候选;参数幻觉去治取值约束:枚举、单位、必填写进 Schema,上下文里没有可靠取值就让模型澄清;格式错误交给校验层:JSON Schema 校验加报错回传的重试,重试带上限、超限降级。多步任务再把先想再做接进来,观察回填、逐步修正。常见的坑是只看最终任务成功率——必须分层度量,工具选择、参数、最终结果分开统计,用日志聚合决定先修哪层。投入顺序上,Schema 和校验先行,路由看规模,微调放最后:训练最贵,而且工程债不该训进模型。