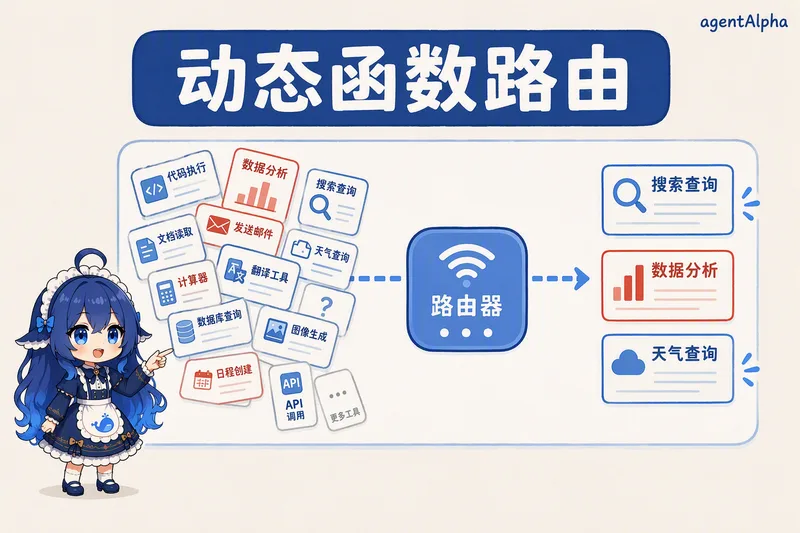
Agent 的工具列表是怎么膨胀的:第一版十个工具,demo 很顺;接上内部平台,三十个;一旦接了 MCP(把外部工具标准化接入大模型的一套协议),全世界的工具服务器都想挂进来——很快过百。这时两件事同时发生:上下文装不下了,模型开始选错了。
腾讯和百度都考过同一道题:
「当 Agent 可见 100 个工具时,如何降低工具描述占用和选择混乱?」 —— AgentAlpha 面试题库 · 腾讯篇 / 百度篇
题目把两笔账写在了一起:占用(上下文成本)和混乱(选择准确率)。动态函数路由就是同时压住两笔账的那层结构。
先说结论
工具数量过百后,全量工具描述塞进上下文在成本、噪声、权限上都不成立。加一层动态函数路由:请求进来先用轻量组件召回 top-k 候选工具,模型只在小候选集里做选择。路由不是替代模型的判断,而是把判断范围从「全部工具」缩到「相关工具」——这和 RAG 不把整个知识库塞进上下文,是同一个思想。
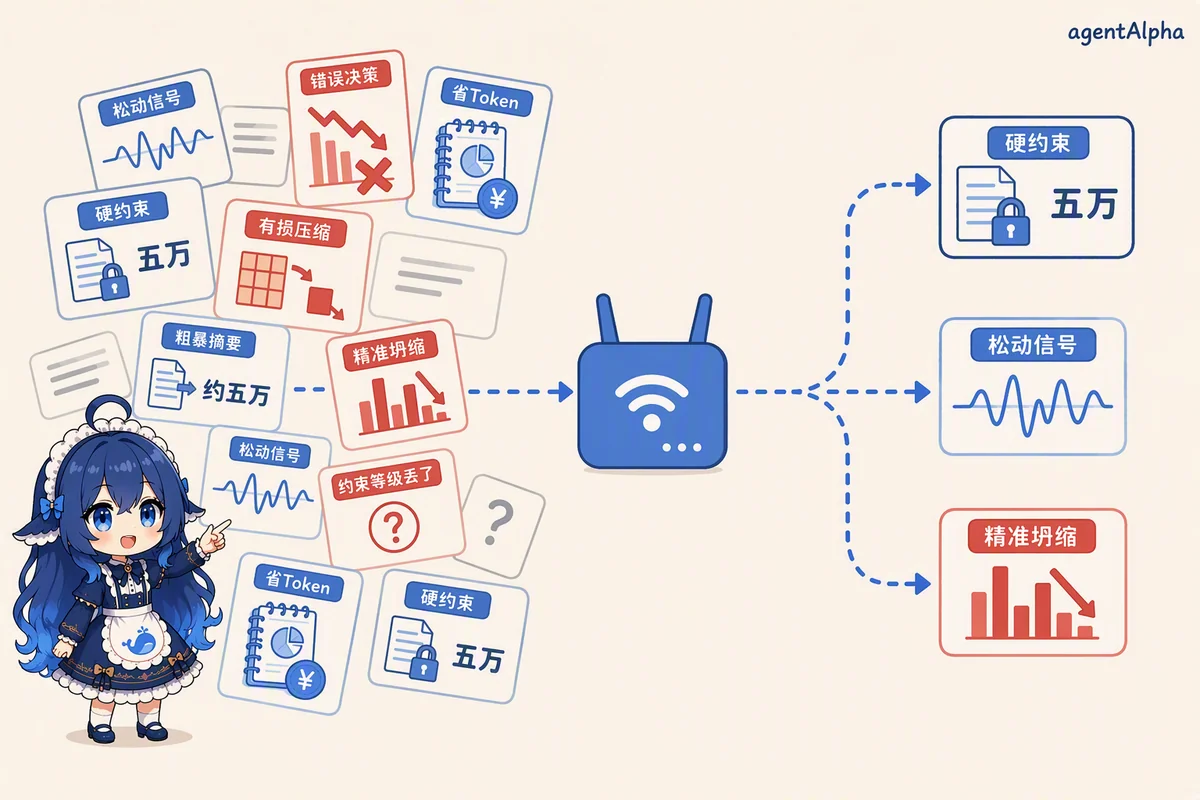 图:小蓝图解——动态函数路由:先检索再选择。
工具列表膨胀的三笔账
第一笔,上下文账。每个工具的描述加参数说明动辄几百 token,工具数线性涨,上下文成本跟着涨,还挤占真正该放的历史和工具结果。
第二笔,噪声账。候选越多,功能相近的工具越多,描述互相干扰。很多「选错工具」不是模型不会选,是干扰项太多——人翻一百个函数文档也会翻花眼。
第三笔,权限账。不是每个用户都该看到所有工具。全量塞 prompt,等于把权限边界交给模型自觉,这在企业场景里不可接受。
字节篇把规模感和动作都点明了:
「一个 Agent 有几百个工具时,怎样做工具检索、路由和候选集裁剪?」 —— AgentAlpha 面试题库 · 字节篇
路由器的两种主流做法
| 维度 | 意图分类路由 | 向量检索路由 |
|---|---|---|
| 原理 | 请求先归到某个意图类别,映射到一组工具 | 工具描述向量化,按与请求的相似度召回 top-k |
| 优点 | 快、稳、可解释,误路由好排查 | 工具动态增删不用改架构,覆盖开放域 |
| 弱点 | 类别体系要人工维护,新工具有冷启动期 | 描述写得差就召不回,相似工具难分 |
| 适合 | 场景边界清晰的业务 | 工具多且频繁变化的平台 |
两者不互斥,常见组合是分类粗筛、向量细排、最后按用户权限过滤——阿里篇考的就是这条组合链:
「当 Agent 有数百个 MCP 工具时,怎样做语义检索、权限裁剪和动态加载?」 —— AgentAlpha 面试题库 · 阿里篇
检索、裁剪、加载,一次请求里三步串起来:先召回候选,再按调用者身份过滤,最后只把幸存的候选集挂进这次上下文。
无论选哪种实现,有一条不会变:工具描述就是路由索引的语料,描述质量决定召回质量。描述里没写的用途,向量检索就匹配不到;描述含糊的分类标签,分类路由就分错箱。
同时补一个反向判断:工具不到二三十个时,别急着加路由。这一层自己也会犯错——路由错一次,等于模型被蒙住眼。候选集小到模型一眼能扫完,全量列表加权限过滤就是更简单、更可靠的做法。路由解决的是规模问题,先有规模,再上路由。
路由失败怎么兜底
路由加的是一道筛选,不是一堵墙。四条兜底要提前设计:
- 阈值放行:召回分数都低于阈值时,回退全量列表(工具不多时)或扩大 k 值。宁可多给候选,不给模型瞎选的机会;
- 澄清反问:几个候选分数咬得紧、彼此都像,说明请求本身歧义,直接问用户一句,比赌一次调用便宜;
- 降级路径:路由服务自己故障时,退回全量列表加收紧权限,先保可用性;
- 日志回流:路由错误的 case 定期回流——补描述、调阈值、扩类别。路由是一层要养的结构,不是上线即完工的组件。
补一句规模判断:路由本身不该用大模型做。一个小体积的嵌入模型或分类器,毫秒级完成;用大模型当路由器,等于在便宜的问题上花贵的推理,除非你的场景复杂到小模型真的分不了。
它就是给工具做的 RAG
把两件事并排看:RAG 先检索相关文档片段,再让模型基于片段回答;动态函数路由先检索相关工具,再让模型基于候选集调用。同一个底层思想:上下文里只放与当前请求相关的部分。
连风险都同构。RAG 怕召回失败——证据没进窗口,模型再强也是瞎答;路由怕漏召——该用的工具没进 top-k,模型再强也没有正确选项。所以路由要单独评测:准备一批标注了「该用哪个工具」的测试请求,先量路由召回率,再量模型在候选集里的选择准确率,两层分开归因。混在一起量,路由的问题会被模型背锅,模型的问题会被路由背锅。
这也是为什么工具描述值得像知识库语料一样治理:写清它做什么、什么时候不该用它、和相近工具的边界在哪。语料质量决定检索上限,工具描述质量决定路由上限。
面试迁移
追问预测:
- 「top-k 取多大?」——没有万能值。k 太小漏召,k 太大噪声回来;按漏召率和选错率两类指标分别监控,反向调 k;
- 「路由引入的延迟怎么办?」——嵌入检索毫秒级,分类器更快;真正要防的是用大模型做路由;
- 「新工具上线冷启动?」——描述模板化:功能、边界、反例三段写全,再用少量标注查询验证召回后再放量。
容易扣分的说法:「上向量库就完事了」——漏了权限裁剪和兜底;「工具描述随便写写」——描述是路由的地基,不是注释。
要点复盘
- 工具过百,全量塞上下文三头不讨好:成本涨、噪声大、权限失控;
- 路由器两种做法:意图分类适合边界清晰的业务,向量检索适合动态增删的平台,常见组合再加权限过滤;
- 四条兜底:阈值放行、澄清反问、降级路径、日志回流;
- 路由是给工具做的 RAG:上下文只放相关部分,风险同构——漏召了,模型就没有正确选项;
- 评测分层:路由召回率和候选内选择准确率分开量,别让两层互相背锅。
参考答案要点
给 Agent 加动态函数路由,是因为工具过百之后,全量工具描述塞进上下文在成本、噪声、权限上都不成立,而且相似工具互相干扰,很多选错其实是候选太杂。路由的做法是请求进来先用轻量组件——意图分类或向量检索——召回 top-k 候选,模型只在小集合里选择,再串上权限裁剪和动态加载。它的本质和 RAG 是同一个思想:上下文只放与当前请求相关的部分。常见的坑是漏召兜底没做——该用的工具没进 top-k,模型再强也没有正确选项,所以要有阈值放行、澄清反问和日志回流。权衡在 k 值:太小漏召、太大噪声回来,按漏召率和选错率分开监控来调。