美团Agent岗三面:你的 Multi-Agent 系统,为什么越加人越乱?
面试季继续。这篇聊多智能体——简历上最常见、面试里最容易翻车的话题。翻车的姿势高度一致:架构图画了五个Agent协作,一被追问「为什么五个」「出错了谁兜底」
面试季继续。这篇聊多智能体——简历上最常见、面试里最容易翻车的话题。翻车的姿势高度一致:架构图画了五个 Agent 协作,一被追问「为什么五个」「出错了谁兜底」,整座大厦当场塌掉。
三面现场:让架构图失效的追问
面试官:你项目里做了 Multi-Agent 协作,画一下架构?
我:好。主 Agent 下面挂了四个子 Agent:检索、分析、写作、审核,互相之间可以通信,还有个协调者负责任务分配……
面试官:先停一下。为什么是四个?两个行不行?八个会不会更好?你加每个 Agent 的依据是什么?
我:因为任务可以拆成四个环节嘛,分工协作效率高……
面试官:那我说说你没说的问题:四个 Agent 四份上下文,它们通信的内容本身也要占 token;审核 Agent 挑出错误,错误是谁引入的?怎么定位?如果检索 Agent 给了一份带毒的材料,后面三个是不是全被污染?你这套系统跑挂过吗,怎么调试的?
我:呃……有日志,可以翻。
面试官:翻日志不是调试设计。我换个角度收尾:如果把四个 Agent 砍成一个 Agent 加四个工具,你的任务还能完成吗?你测过吗?
我:……
【顿悟时刻】这一问下来才发现,多智能体面试的考点根本不是「会不会搭」,而是**「该不该拆」和「拆了之后错误怎么管」**。架构图画得越漂亮,答不上这两个问题就越难看——因为那是演示思维,不是生产思维。
💡 简要回答
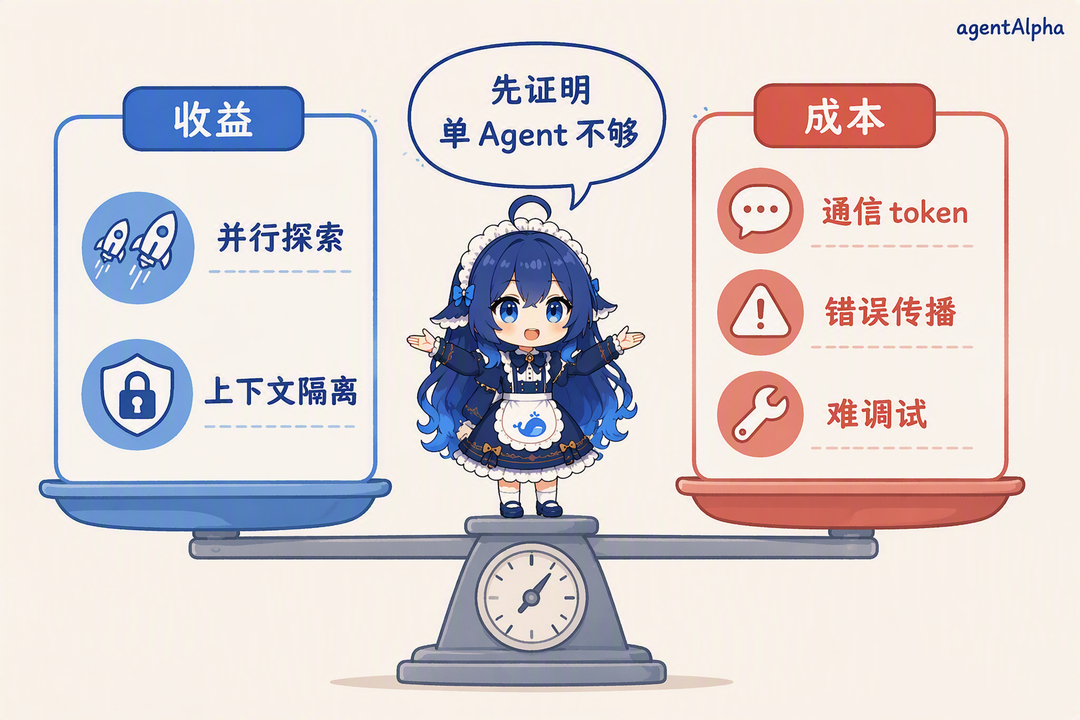
一句话总结:Multi-Agent 不是「人多力量大」,而是用通信成本、错误传播链和调试复杂度,去换并行广度和上下文隔离——先证明「单 Agent + 好工具」不够,再谈拆分。
三个必须答到的认知:
· 拆分的正当性来自收益,不来自好看:只有两类场景值得拆——任务可以并行广度探索(深度调研、多方案权衡),或者中间产物太多需要上下文隔离(探索型任务的脏活分包给子 Agent)。
· 每个 Agent 都是一个「信息孤岛」:它们各自的上下文互不相通,通信即成本;角色越多,一条错误要穿越的链路越长——错误传播是指数级的。
· 编排必须是图,不是群聊:状态、条件边、回滚、人工干预节点——这些工程约束才是多 Agent 系统能上生产的底气。
多智能体系统今年被 Gartner 列入年度战略技术趋势,行业在加码;但一线工程社区的共识恰恰相反地变得冷静——「能不能上生产」的门槛,全在工程细节里。
📝 详细解析
一、先算账:多 Agent 的成本结构,很多人根本没算过
面试里先主动算账,是展现工程成熟度的最快方式。一个 N 个 Agent 的系统,成本至少有三块:
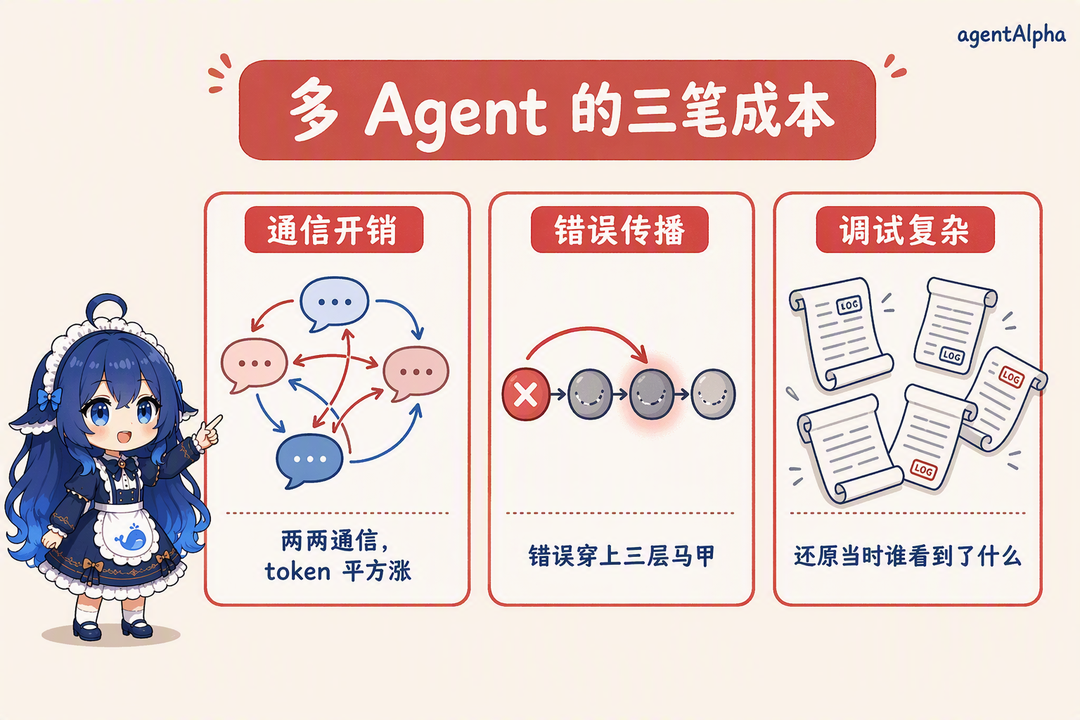
· 通信开销:Agent 之间传递的不是免费信号,是实打实的 token。A 把调研结果给 B,等于把这份内容再「读」一遍——N 个 Agent 两两通信,通信组合数按 N(N-1)/2 接近平方级增长;每对都要交换完整内容时,token 总量随之平方级膨胀。
· 错误传播链:单 Agent 出错,错误就在一个上下文里,看得见改得掉;多 Agent 链路里,上游检索 Agent 的一个幻觉,会变成下游分析的前提、写作的论据、审核眼中的「事实」——错误沿链路逐级被当作事实引用,链条越长越难溯源,扇出越多放大越快。
· 调试复杂度:线上出了错,你要在多份上下文、多段通信记录里还原「当时每个 Agent 看到了什么」——没有设计好的轨迹日志,这就是考古。
把这笔账算在前面,「为什么是四个 Agent」的回答就有了骨架:每加一个 Agent,都要说明它带来了什么不可替代的收益,且这个收益大于它引入的通信与调试成本。
二、拆分的两条正当理由,以及「不要拆」的判断
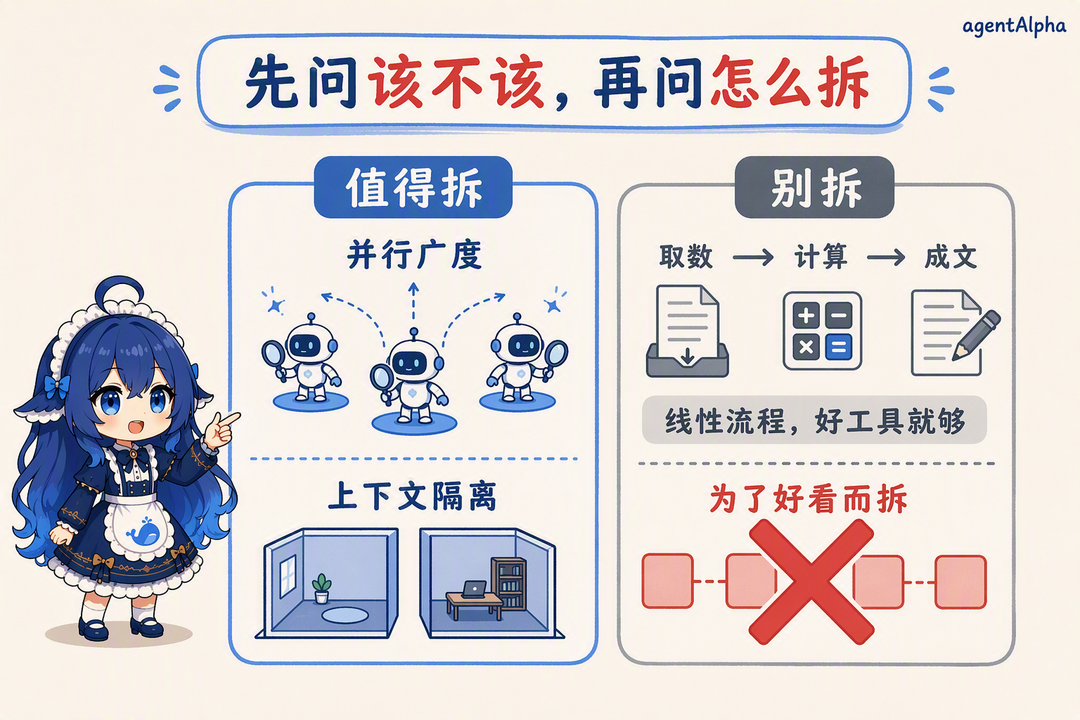
理由一:并行广度优先。 深度调研、多方案权衡这类任务,几个 Agent 分头检索、各自探索,最后汇总——快且全,总耗时约等于最慢的那个。
理由二:上下文隔离。 探索型任务的中间产物又多又脏(网页原文、失败尝试、冗长日志),全部堆进主 Agent 的上下文会迅速污染决策质量。把脏活分包给子代理,让它们在干净窗口里消化,只把精炼结论带回主链——这是 Anthropic 工程博客里反复强调的隔离模式。
反面判断同样重要:如果任务是一条清晰的线性流程(取数→计算→成文),单 Agent 加一组好工具就是最优解——流水线用工作流编排即可,拆 Agent 只会平白多出通信和状态管理。单 Agent 能解决的,别上 Multi-Agent——这句话在面试里说出来,比二十分钟架构吹嘘加分。
三、拆了之后:用「图」管住四件事
决定拆了,工程上就要用图结构编排(如 LangGraph 的状态图),把下面四件事写进系统,而不是指望 Agent 自觉:
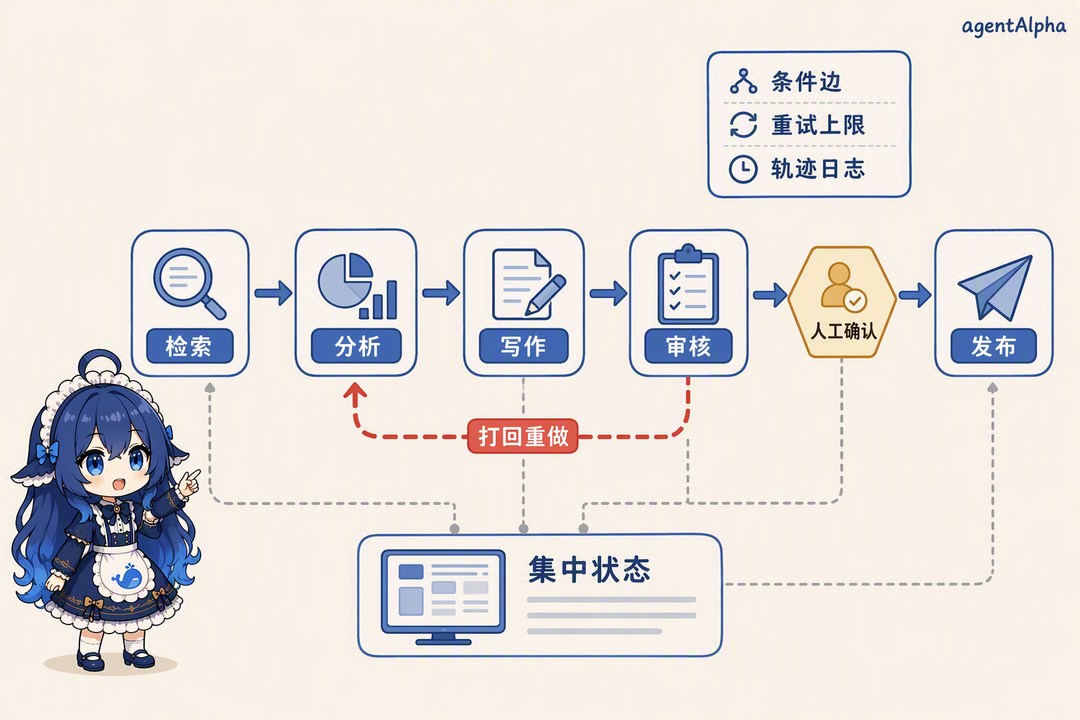
· 状态集中管理:任务状态放在显式的共享状态结构里,每个节点(Agent)只读写自己职责内的字段——谁改了什么,一目了然。
· 条件边控制流:走哪条边由状态判断,而不是自由群聊里「谁抢到话筒」;终止条件显式定义,防止两个 Agent 互相客气永远聊不完。
· 回滚与重试:审核 Agent 打回时,系统能回到指定节点重来,而不是整个任务从头跑;重试要有次数上限。
· 人工干预节点:高风险动作(对外发送、资金操作)后插一个等待确认的节点,人批了才继续。
这四件事对应的验收标准也很具体:一次反思/批判性反馈环节、一条含回滚与条件跳转的流程控制、一层跨任务的记忆延续——做到这三条,多 Agent 系统才算「能上生产」。
四、面试里的标准叙述结构
最后给一个能直接套用的叙述模板,按这个顺序讲你的多智能体项目,每一句都踩在考点上:
1.先讲为什么拆:任务要并行探索三路方案 + 中间产物会污染主链(两条正当理由占了)。
2.再讲怎么编排:LangGraph 状态图,集中状态 + 条件边 + 审核节点的回滚路径(图结构,不是群聊)。
3.主动讲失败设计:上游材料带毒怎么办——审核 Agent 独立抽查来源;调试靠什么——每个节点读写状态的轨迹日志。
4.收尾讲对照:同样的任务,单 Agent 版和 Multi-Agent 版各跑过,前者耗时更长但成本只有三分之一——你有对照组,你就赢了一半。
🎯 面试总结
一分钟答题框架:
Multi-Agent 的本质是用通信成本、错误传播和调试复杂度,换并行广度与上下文隔离。只在两类场景值得拆:并行广度优先的探索任务、中间产物需要隔离的脏活分包。拆了之后必须用图结构编排——集中状态、条件边、回滚、人工干预四件事写进系统;最后用「单 Agent 版 vs Multi-Agent 版」的对照数据证明拆分值得。
加分项:主动算通信 token 的账;讲「错误穿上三层马甲」的传播链案例;说出「单 Agent 能解决的别上 Multi-Agent」这句反共识判断。
推荐阅读
本号 Agent 面试题系列(更新中):
· 字节面试官:什么是 Multi-Agent?
· 京东面试官:单体 Agent 遇到瓶颈,Multi-Agent 方案怎么设计?
· 字节跳动面试官:说说如何设计多 Agent 的协作与动态切换机制?
· 面试官困惑:你的 multi-agent 跑一轮任务,Token 都花在哪了?账单怎么控制?
💪 面试突击资源推荐:
· ✅ 求职辅导:成功转行去做 Agent 开发了!
· ✅ 面试项目:AI Agent 应用开发项目
写在最后:把面试题变成你的项目经历
多智能体的终极心法是克制:架构图上的每一个框,都要能回答「它带来了什么、代价是什么、错了怎么办」。答得出这三问,你的系统才配叫「设计过」。