GRPO 训练 Agent,为什么 rollout 总把系统拖垮?
GRPO 的公式不难,难的是采出一批比得了、复现得了、成本也扛得住的 Agent 轨迹。工具、并发、超时,加上轨迹长短不齐,随时能把训练系统拖垮。
“我们用 GRPO 训练了一个 Agent。”这句话放在简历上很有气势,真正开跑时却常常先卡在 rollout。
这句话放在简历上很有气势。面试官通常不会先问公式,而是问一句很朴素的话:
“一组 rollout 是怎么来的?”
如果你的回答是“把 prompt 复制几份,然后生成几次”,下一问马上会来:工具返回不一样怎么办?有的轨迹三步结束,有的跑到三十步怎么办?八张卡在等一个慢网页时,GPU 算力算谁的?
GRPO 和 PPO 的关键差异是什么?
GRPO 不训练 value model,用同一问题采样的一组结果计算相对优势,省显存。
那 Agent 里的“同一问题”是什么?如果每条轨迹拿到的搜索页面不同,还能比较吗?
公式说到这里还不够。GRPO 的相对优势依赖一组可比较的样本。rollout 质量不稳,后面再漂亮的 loss 也只是在给噪声加速。
先把 GRPO 摆回它该在的位置
DeepSeekMath 介绍的 Group Relative Policy Optimization,核心思路很直接:对同一个输入采样多条输出,用组内奖励的均值和方差构造相对优势,不必像 PPO 那样单独维护一个 value model。形式可以写成:
A_i = (r_i - mean(r_group)) / (std(r_group) + ε)
再配合旧策略比率、裁剪和 KL 约束更新策略。DeepSeek-R1 将这类方法用于大规模推理训练,引发了很多“只要上 GRPO 就能涌现”的误读。真正可迁移的经验不是一个神奇开关,而是:同题多采样、奖励可比较、更新受约束。
对 Agent 来说,一条 output 不再只是文本。它可能包含思考 token、工具调用、工具观察、下一轮思考和终止答案。组内比较的对象,应该是同一个任务、同一套环境契约下的完整决策轨迹。至少要记录:
- 输入问题和任务版本;
- 初始环境状态或可复现的快照;
- 模型生成的动作 token;
- 工具名、参数、返回摘要和耗时;
- 终止原因、奖励分解和验收结果。
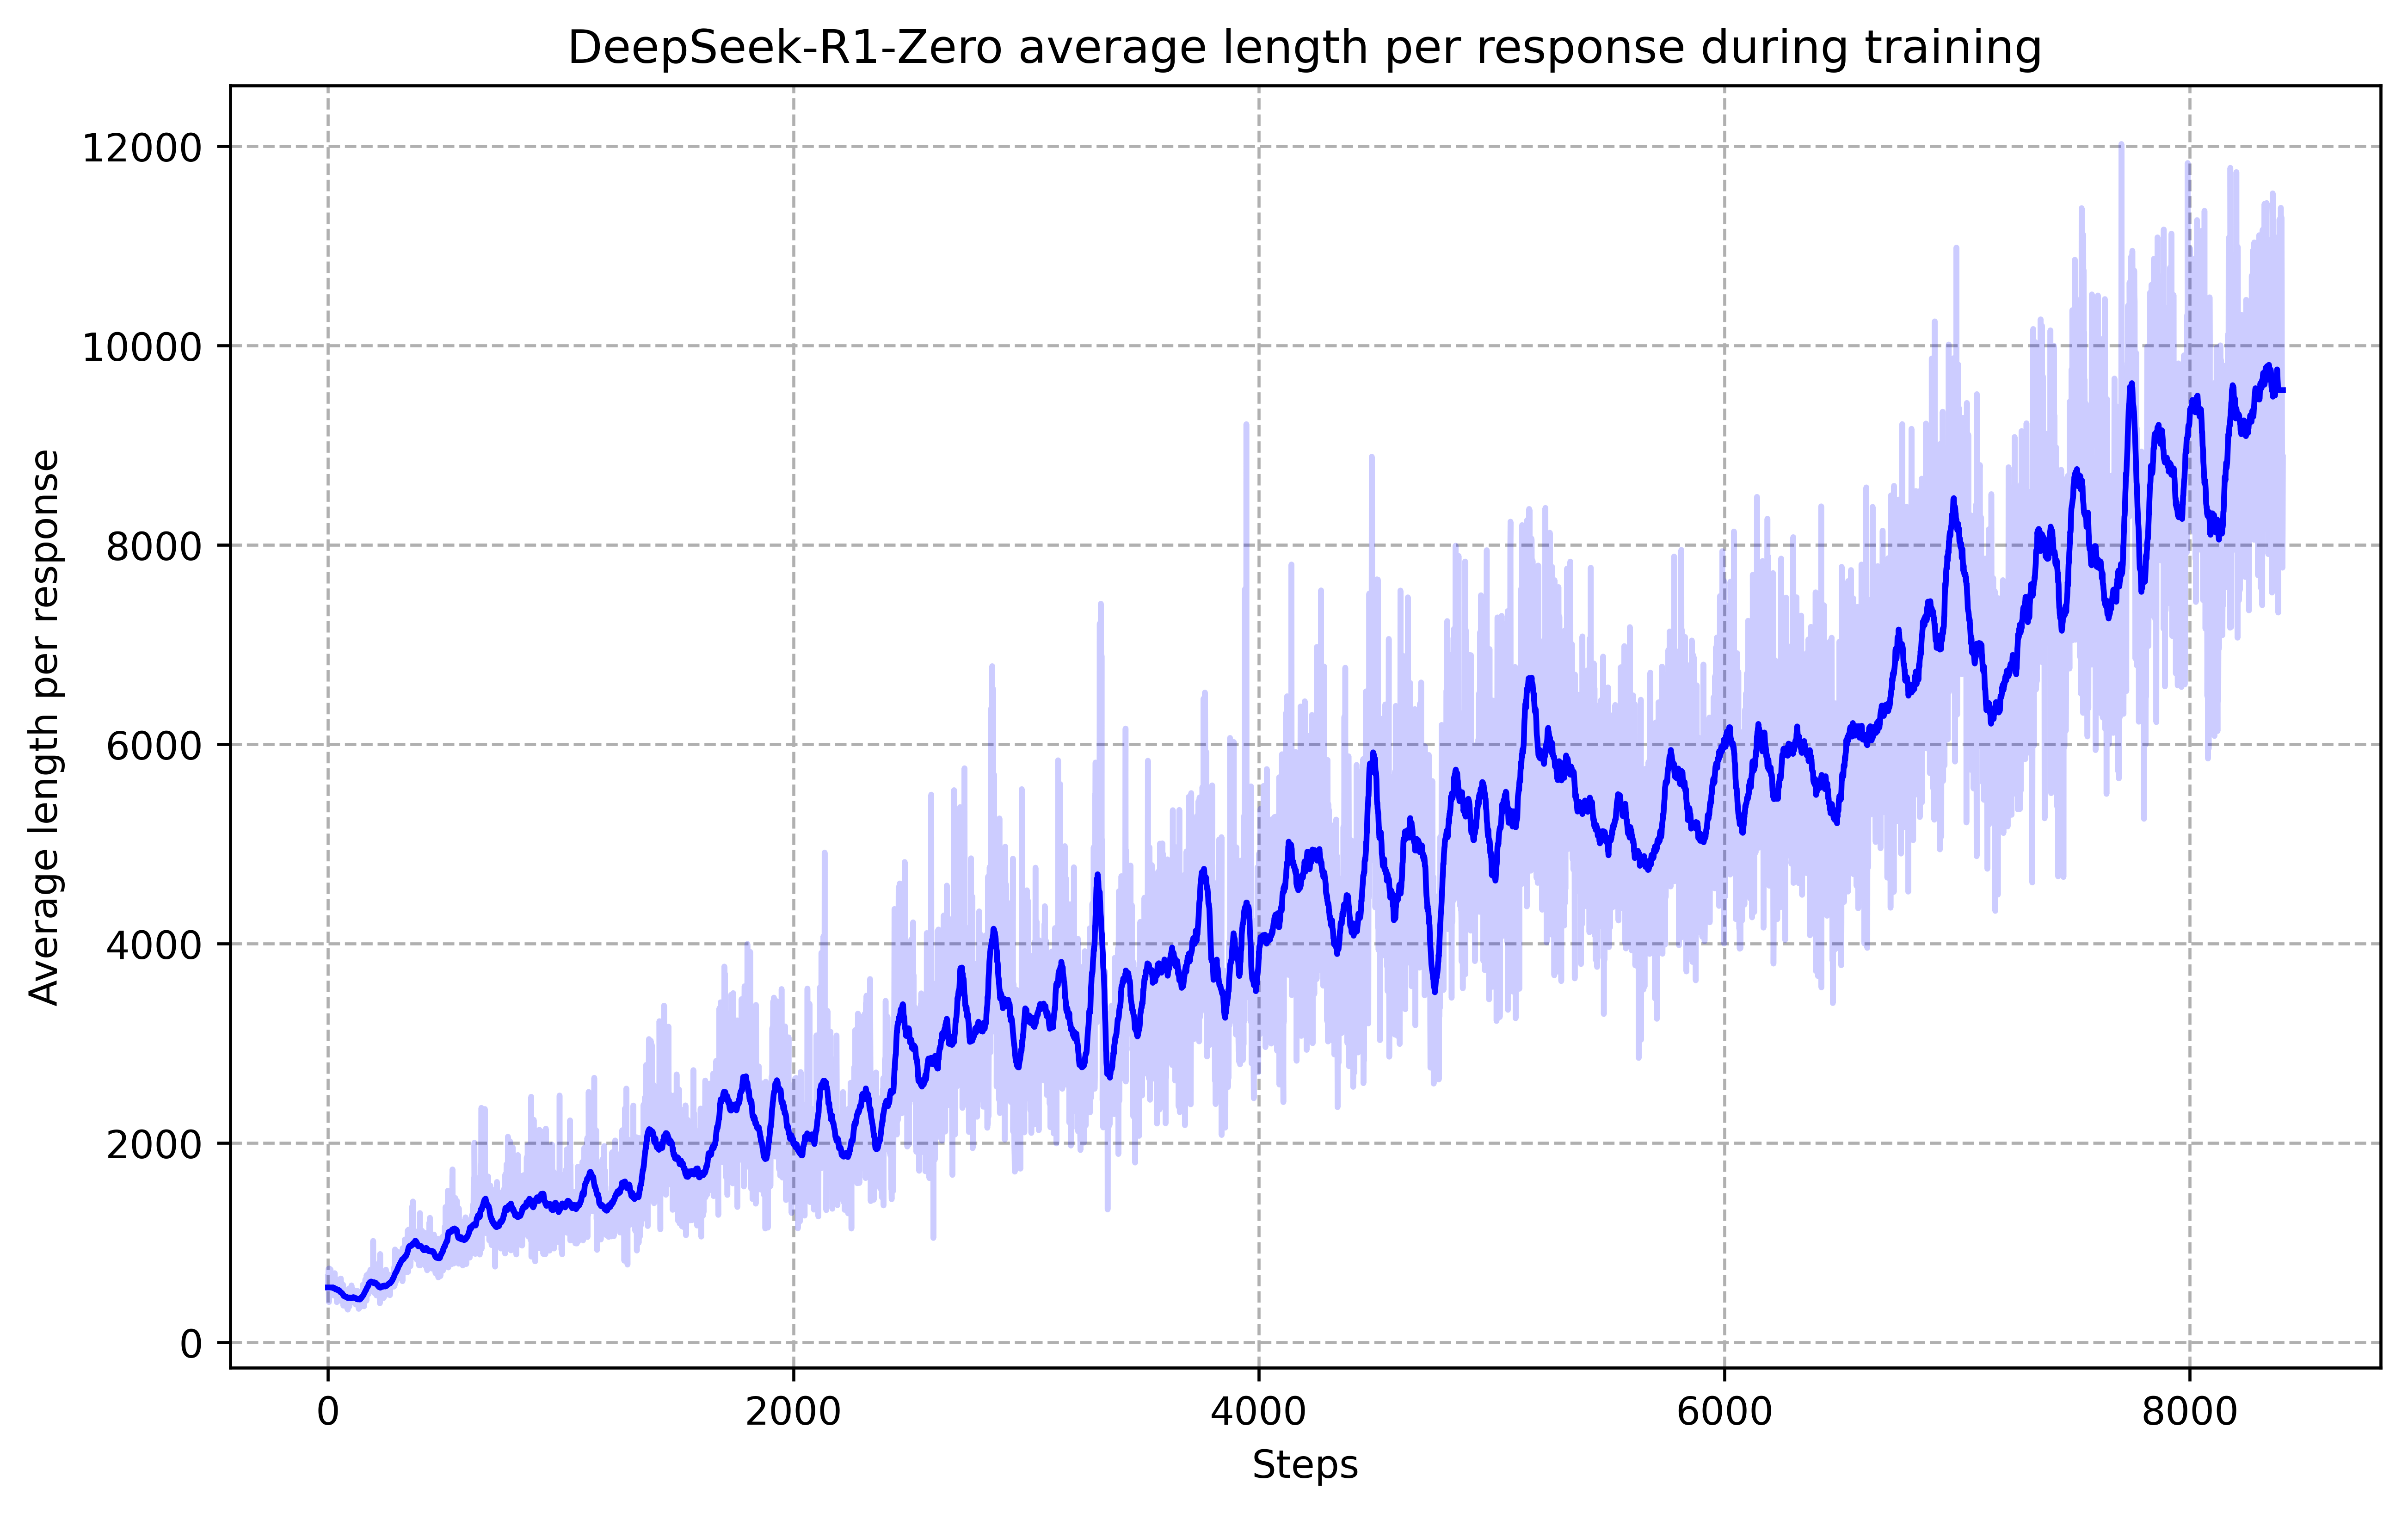 论文图:DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,Figure 3;原文。
这些字段看上去像日志工作。实际上,它们决定了你是否真的在做 group relative,而不是拿几条互不相干的故事算平均数。
一组 rollout,到底该怎么采
最小可行流程可以拆成六步。
第一步,固定问题批次。不要每轮都从动态数据源随机抓 prompt,否则这轮的提升可能只是题目变简单。
第二步,为每个问题建立环境副本。文件系统、数据库、网页快照、随机种子都要有边界。若工具必须联网,至少缓存响应和版本,让失败可以重放。
第三步,用当前策略生成一组轨迹。组大小不是越大越好。小组方差估计抖,大组则把采样成本和尾部延迟一起放大。先从 4 或 8 条做基线,再根据奖励分布和显存调整。
第四步,执行工具并把观察回填。工具返回的内容是 observation,不是策略动作;训练时对这部分 token 做 mask。Search-R1 对检索 token 的处理就是一个清晰例子:更新模型自己生成的 token,别让它去拟合搜索引擎吐出来的原文。
第五步,统一验收。数学题用答案检查,代码任务跑测试,检索任务查引用是否支持结论。不同任务可以有不同 verifier,但同一组样本必须经过同一版本的验收器。
第六步,计算组内优势,过滤明显环境故障,再做策略更新。生成和更新之间的队列边界要清楚,否则失败重试会混入下一轮样本,造成样本年龄不可控。
为什么长轨迹会拖垮 rollout
语言模型生成本来就有长短差异,Agent 再叠加工具延迟,尾部样本会更长。一个批次里,七条轨迹三步结束,第八条卡在网页超时二十秒,整批 padding 和等待都由它决定。
常见故障有三个。
其一,GPU 等 CPU。工具调用在进程外执行,模型服务却同步等待,卡上没有 token 可以生成。
其二,短轨迹被长轨迹 padding。为了凑成张量,三步轨迹被补到三十步,显存和计算都花在空白位置。
其三,重试放大流量。一次超时如果在 worker、网关、环境三层各重试一次,就不是一次失败,而是最多八次请求。训练曲线没涨,账单先涨。
工程上要把 rollout 当作分布式数据生产,而不是一个 for 循环。把策略生成、工具执行、验收和写盘拆成可观测阶段;为每条轨迹设置总步数、单步超时、工具预算和 wall-clock 上限;超过上限要有明确终止原因,不要让 worker 永久挂起。
同一组样本,环境真的一样吗
GRPO 依赖组内相对比较,环境差异会直接污染优势。举个小例子:同一个搜索问题,A 轨迹拿到的是刚更新的页面,B 轨迹拿到的是缓存旧页。A 答对、B 答错,模型可能把“调用搜索”学成“碰到新缓存就赢”。
解决办法取决于工具性质。
对可缓存工具,保存请求参数和完整响应摘要,训练时从快照回放。对有随机性的工具,固定种子或把随机源当显式环境变量。对必须实时调用的服务,记录时间窗口、返回状态和速率限制,并把“不可比较”的样本打上标签。
这里不追求绝对确定性。网络不可能永远像实验室一样安静。你要做的是知道哪些差异属于策略探索,哪些差异只是环境晃了一下。前者进入奖励,后者进入诊断或重试。
奖励全相同或全不同,GRPO 都会难受
组内奖励全是 1,标准差为 0,优势没有方向;全是 0,情况一样。可以跳过这组、积累到下一组,或使用带温度的软评分,但不能假装相对优势仍然提供了信息。
另一头是奖励尺度混乱。一条轨迹答案对但调用了 30 次工具,另一条答案也对只调用 3 次。如果奖励把“正确”设成 1,再用很小的成本惩罚,组内差异几乎看不出来;惩罚过大,又会把模型推向不敢行动。
我的做法是先画奖励分布,再选权重。把最终结果、硬约束、工具成本、格式检查分开记录,展示每项在组内的方差。若某个分量长期为常数,它不是一个有效的相对信号;若某个分量支配全部方差,要确认这是不是产品真正要优化的目标。
rollout 版本和更新版本要对得上
Agent 训练经常使用推理服务单独生成轨迹,再回到训练框架做更新。生成模型、训练模型、tokenizer、工具协议只要有一个版本错位,重要性比率就不再对应同一策略。
至少要在轨迹里写入 policy version、tokenizer revision、prompt template revision 和 environment version。更新时检查版本,不匹配就拒绝进入 batch。这个检查会让一些样本被丢弃,短期看像浪费;但把错版本样本混入梯度,通常更难排查。
还要处理样本年龄。若生成队列堆积几分钟,训练更新了很多轮后才消费,旧策略采的轨迹会变得过时。可以限制队列长度、周期性清空,或明确采用异步训练并监控 policy lag。不要一边使用 on-policy 的公式,一边让样本在仓库里过夜。
代码任务的 rollout:通过测试不等于轨迹好
代码 Agent 是最容易让人误会的场景。最终测试全绿,轨迹可能包含危险的文件操作、无关依赖安装和大量重复运行。只看 outcome,模型会学会“把测试跑绿”,而不是“写出可维护的修复”。
反过来,测试环境偶发失败,也不能立刻把策略判成坏。需要把编译器、测试框架、依赖安装的状态分开记。对于外部副作用,沙箱要限制网络、文件和进程;对每次执行记录 patch、stdout 摘要和测试版本。
rollout 的质量最终由验收器决定。验收器只检查一个脆弱的样例,GRPO 就会把策略往样例漏洞上推,也就是 reward hacking。这类问题的案例分析见Agent 把奖励刷满了,为什么任务还是没做成?。
给 rollout 做一张体检表
我通常把 rollout 指标分成四组,而不是只报 samples per second。
第一组是可比性:同一 prompt 的环境快照命中率、verifier 版本一致率、奖励标准差为零的组占比。可比性差,组内优势就没有解释力。
第二组是效率:每条轨迹的 token 数、工具次数、p50/p95/p99 时延、GPU 等待时间和重试率。p50 很漂亮、p99 爆炸时,集群仍然会被尾部拖住。
第三组是质量:最终正确率、硬约束通过率、引用支持率、代码测试通过率。把这些指标和 reward 分开画,才能看出刷分。
第四组是新鲜度:轨迹生成时的 policy version、进入更新时的版本、队列等待时间。样本年龄一旦和训练步数相关,loss 下降也不代表策略更新有效。
每轮抽几条“最高优势”和“最低优势”轨迹人工看一眼。最高优势轨迹如果只是碰巧撞上一个脆弱页面,应该先修数据,而不是庆祝模型学会了搜索。
在资源受限时,可以先降低组大小,再做更长的离线回放;不要为了凑满一组而无限等待慢样本。一个明确标记为 incomplete 的小组,比一组混入超时重试的伪完整数据更适合调试。
把 rollout 当成数据产品,而不是 for 循环
一个可交接的 rollout 记录,应该能被另一个进程独立消费。建议把轨迹状态写成明确的状态机:
CREATED
  → GENERATING
  → TOOL_WAITING
  → VERIFYING
  → ACCEPTED | REJECTED | INFRA_FAILED | EXPIRED
INFRA_FAILED 和 REJECTED 不能共用一个失败桶。前者通常进入重试或诊断队列,后者才是策略应该学习的负反馈;EXPIRED 则表示样本年龄超过了本轮更新允许的窗口。
轨迹元数据可以保持很小,但不能省掉版本和时间:
{
  "group_id": "q_0187_g04",
  "prompt_version": "questions-v3",
  "policy_version": "policy-2026-08-19-12",
  "environment_version": "snapshot-42",
  "verifier_version": "verifier-7",
  "queue_wait_ms": 840,
  "terminal": "ACCEPTED"
}
更新器消费前做一次版本检查;不匹配就拒绝入 batch,并留下原因。这个门槛会丢掉少量样本,却能避免“昨天的策略采样、今天的 tokenizer 更新、明天才发现 ratio 全错”的隐性事故。
奖励标准差为零时怎么办
当一组样本全部成功或全部失败,std(reward)=0,组内优势没有方向。最简单的处理是跳过该组;更稳的是把它放进独立的 outcome 统计,不把它伪装成有效 policy gradient。
def relative_advantage(rewards, eps=1e-6):
    mean = sum(rewards) / len(rewards)
    variance = sum((r - mean) ** 2 for r in rewards) / len(rewards)
    std = variance ** 0.5
    if std < eps:
        return None  # 这组只用于 outcome,不用于相对更新
    return [(r - mean) / (std + eps) for r in rewards]
如果“全成功”长期出现,先问任务是不是太简单、verifier 是否只看格式、采样温度是否过低;不要马上把组大小从 8 加到 64。组越大,可能只是更贵地重复没有信息的样本。
同步、异步和离线回放的边界
同步 rollout 好理解:一轮生成完,统一算奖励,再更新策略。它的优点是样本关系清楚,缺点是被最慢轨迹卡住。异步 rollout 可以让 worker 持续生产,吞吐更高,但样本年龄、版本漂移和奖励延迟要额外监控。两者不是谁先进,而是任务能否容忍旧策略样本。
如果工具延迟不可控、任务又必须实时交互,可以先采用“异步生成、周期性冻结策略”的折中:冻结一个 policy version 生成一段时间,达到队列上限后统一更新,再切换版本。这样仍有等待,却能把样本新鲜度控制在一个可解释的窗口内。
离线回放适合做 verifier、mask、奖励权重和超时策略的回归,不适合证明实时环境里的最终收益。回放里工具响应固定,模型学不到新页面变化;实时训练则反过来会受网络噪声影响。报告里把两种结果分开写,别用离线吞吐去宣称线上交互能力。
2026 年关于异步 RLHF 的研究把这种“样本年龄”进一步写成了 staleness 与学习率的关系。采样策略落后越多,旧轨迹对当前策略的偏差越大,更新就越不能激进。落到工程上,不是背一个缩放公式,而是同时监控 policy lag、队列等待时间、importance ratio 和有效样本率;一旦超过设定窗口,就降学习率、丢弃过旧样本或切回冻结版本采样。
另外,长轨迹可以按 turn 截断,但截断必须作为终止事件进入奖励。若直接丢掉尾部 token,模型会以为任务自然结束,逐渐学会提前收尾。截断样本可用于诊断“预算不足”,但不要和真正成功样本混在同一奖励桶里。
Rollout 入批前要发一张新鲜度回执
GRPO 的组内相对优势依赖样本来自可比的策略和环境。入 batch 前,我会给每组轨迹发一张新鲜度回执,把采样版本、环境版本、等待时间、奖励状态和是否允许更新写清楚:
rollout_receipt: rr_fb7dc0
group_id: q_0187_g04
policy_sampled: policy-12
policy_current: policy-13
environment: snapshot-42
verifier: verifier-7
queue_wait_ms: 840
members:
  accepted: 6
  expired: 1
  infra_failed: 1
reward_std: 0.41
admission:
  max_policy_lag: 1
  max_queue_wait_ms: 1200
  allow_update: true
expired 和 infra_failed 不应该混进策略负反馈;policy_lag 或等待时间超过门槛时,整组只能做 outcome 统计或离线回放,不能伪装成有效 gradient。这样训练吞吐下降时,团队能判断是采样慢、验证慢还是版本过期,而不是只看一个“每秒轨迹数”。
入批之前还要做一次“同组可比性检查”
GRPO 的相对优势依赖同一 prompt 下的一组可比轨迹。如果组内样本用了不同的策略版本、环境快照或 verifier,奖励差异就不再只反映动作好坏,可能只是基础设施或任务版本变了。于是我会在入批前生成 group comparability 回执,先过滤掉过期、环境失败和配置不一致的成员。
group_comparability_receipt: gcr_6615e4
group_id: g-1842
prompts_hash: sha256:8b2f...
policy_version: policy-2026-08-20.3
env_snapshot: browser-env-17
temperature: 0.7
valid_members: [m1, m2, m4, m5]
excluded_members:
  m3: infra_failed
  m6: policy_mismatch
reward_variance: 0.38
decision: admit_four_members
检查不只比较 prompt 文本,还要比较工具 schema、数据权限、随机性、策略 lag 和 verifier 版本。组内有效成员太少或奖励方差接近零时,可以做 outcome 统计,但不要硬算 advantage 更新策略。把排除原因留下来,后续才能区分“模型没有学会”和“这一组根本不可比”。
L5:为什么组内相对优势一定要建立在可比样本上?
相对优势只在比较条件相近时有意义。若某条轨迹用了旧策略或失败环境,它的奖励差不是更差的动作造成的,把它放进同组会把基础设施噪声误当成学习信号。
L5:为了保持样本新鲜,是否应该丢掉所有旧轨迹?
不是。旧轨迹可以进入 verifier、奖励规则和故障回放,但要从 policy update 的有效样本中隔离,并单独报告丢弃率和原因。最怕的是把旧样本悄悄混入 batch,让训练看似稳定却无法解释。
报告 rollout 时,最好把“每秒生成多少 token”和“每个正确任务花多少成本”同时给出。前者方便看系统吞吐,后者才接近产品约束。一个靠重复采样把正确率抬高的系统,可能在第二个指标上已经不可用。资源报告还应注明并发度、每条轨迹的平均工具等待和失败重试次数;否则换一台更快的机器,数字会变好,却无法说明算法本身有了提升。
rollout 质量要按“可学习性”分桶
一组 rollout 不只是成功或失败两个标签。对 GRPO 来说,最有价值的是同一问题上存在可比较的行为差异,并且奖励能指出差异来自哪里。可以在入批前按任务难度、轨迹长度、工具调用数和奖励方差分桶,避免某一类长轨迹或模板化答案淹没有效信号。
rollout_bucket:
  task_id: code_118
  group_size: 8
  buckets:
    difficulty: medium
    length: [short: 2, normal: 5, long: 1]
    tool_calls: [0: 3, 1-2: 4, 3+: 1]
    reward_std: 0.42
  action: keep
  exclusion: "reward_std == 0 or environment_version mismatch"
  log: [policy_sha, env_sha, judge_version, seed]
分桶的目的不是把数据筛得越干净越好,而是让训练后可以回答“哪类任务真的受益”。如果长轨迹全部被丢弃,模型可能学不到规划;如果奖励全相同的样本全都混进来,优势归一化只是在放大噪声。最终报告应同时给出保留率、各桶奖励变化和线上任务覆盖。
L5:为什么不能只按 reward 排序取前 20%?
因为最高分可能来自捷径、评测器偏差或更容易的任务。只取 top reward 会减少行为多样性,也会让模型重复已经会的模式。更稳的策略是先做质量门禁,再在难度和轨迹类型上保持覆盖,最后用独立评测确认收益没有只集中在单一桶。
rollout 还要做“奖励来源拆解”
一条总 reward 很难告诉你模型为什么被选中。Agent 任务里,成功可能来自工具调用正确、最终答案完整,也可能只是 verifier 对格式宽松。入批前我会把奖励拆成可审计的分量,并标记哪些分量来自环境事实、哪些来自启发式规则;如果某个桶的总分上涨只是格式分上涨,就不能把它当成能力提升。
reward_decomposition: rd_6f1f80
group_id: q_0187_g04
components:
  task_success: 0.60
  evidence_support: 0.20
  tool_safety: 0.15
  style_bonus: 0.05
checks:
  external_fact_readback: pass
  style_bonus_cap: 0.10
  shortcut_detected: false
admission:
  update_if: "task_success>=0.5 AND evidence_support>=0.1"
  report_components: true
decision: admit
L5:为什么总 reward 上升仍可能是坏消息?
如果提升只来自容易钻空子的奖励分量,模型会学会讨好 verifier,而不是解决任务。要固定分量上限、做独立事实回读,并按任务难度切片看收益;否则训练曲线好看,线上可靠性却可能下降。
聊透之后怎么收尾
GRPO 的核心是同一输入采样一组轨迹,用组内奖励计算相对优势,避免单独训练 value model。Agent 场景中,一条轨迹包含模型动作、工具观察和终止结果,所以 rollout 首先是数据生产问题。
我会固定 prompt、环境快照、随机性和 verifier 版本,记录 policy、tokenizer、环境版本。生成、工具执行、验收、更新分阶段排队,设置步数、超时、工具预算和样本年龄上限。工具返回的 observation 不参与 loss,只更新模型自己生成的 token。组内奖励方差为零或来自环境故障时,跳过或重试,不把它们当成有效优势。
评价 rollout 不只看吞吐,还看轨迹可复现、奖励可比较、尾部延迟和 verifier 稳定。GRPO 省掉的是 value model,不是工程复杂度。
参考资料
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (https://arxiv.org/abs/2402.03300)
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (https://arxiv.org/abs/2501.12948)
- Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning (https://arxiv.org/abs/2503.09516)
- verl: Volcano Engine Reinforcement Learning for LLMs (https://github.com/volcengine/verl)
- Staleness-Learning Rate Scaling Laws for Asynchronous RLHF (https://arxiv.org/abs/2607.01083)