混合检索和重排,分别在补 RAG 的什么漏洞?
向量检索负责把可能相关的证据捞进候选集,重排再把真能回答问题的片段顶到前面。一个管找得全,一个管排得准。
用户问:“线上报错 ERR_AUTH_403 怎么处理?”这时,检索顺序往往比模型大小更先决定答案能不能用。
纯向量检索可能找到一篇讲“登录失败”的长文,却把错误码排在后面。纯关键词检索又可能只找到一行错误码,没有处理步骤。混合检索和重排,正好各补一个漏洞。
先一起把问题过一遍
混合检索并行使用语义召回和关键词召回,兼顾同义表达与精确词项;重排模型再对候选片段做更细粒度的相关性判断。前者扩大“找得到”的概率,后者提高“排得对”的概率。它们都不能替代权限过滤、版本过滤和离线评测。
一、为什么向量和关键词要并行
向量擅长“怎么处理登录失败”这类自然表达,关键词擅长命中 ERR_AUTH_403、版本号、类名和接口路径。企业知识库里两类查询都很多,单一路径必然会丢一部分。
融合时要注意三件事:不同检索器的分数不可直接相加;同一 chunk 可能被两路重复召回;权限和租户过滤必须在结果进入上下文前完成。常见做法是各路先取候选,做 rank fusion,再去重和截断。
二、重排不是“再算一次相似度”
初排通常追求快,使用向量索引从百万级数据里取 top 20 或 top 50;重排可以看问题和整段候选的交互关系,更适合判断“这段能不能支撑当前问题”。但它成本更高,所以不应该对全库运行。
一个可观测的流水线
{
  "query": "ERR_AUTH_403 怎么处理",
  "vector_hits": 20,
  "keyword_hits": 20,
  "fused_hits": 28,
  "reranked_hits": 6,
  "filters": ["tenant:acme", "version:2025.3"],
  "latency_ms": {"retrieve": 42, "rerank": 86}
}
把这些数字记录下来,才能回答“是没召回,还是重排后掉了”。否则每次错误都只能凭感觉改 prompt。
三、候选集里没有答案,重排也救不了
这是面试里很容易被追问的一句。重排只能在候选集里重新排序,不能凭空生成缺失证据。遇到“正确片段在 top 100 之外”,应该回查分块、查询改写、关键词词典和过滤条件,而不是继续调重排阈值。
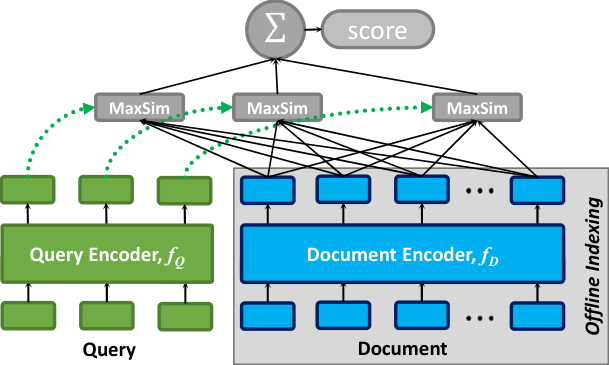 论文图:ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT,Figure 3;原文。
四、融合时别直接把两个分数相加
BM25 的分数和向量相似度不是一个量纲。一个检索器输出 12.4,另一个输出 0.82,并不意味着前者应该占十五倍权重。工程上常见的做法是先把各路结果转成排名,再做 Reciprocal Rank Fusion(RRF)或经过校准的加权融合。
RRF 的直觉很简单:一个文档只要在多个检索器里都排得靠前,就应该获得稳定的加分。可以用下面的形式表达:
这里的 k 是平滑常数,rank 是文档在某一路的名次。它不依赖不同检索器的原始分数,适合快速搭建混合检索基线。但它也会隐藏一个事实:某一路可能整体质量很差,只因为“排名靠前”就持续贡献分数。因此上线前仍要按查询类型拆开评估,而不是把 RRF 当作万能融合器。
def rrf(rankings, k=60):
    scores = {}
    for ranking in rankings:
        for rank, doc_id in enumerate(ranking, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + 1 / (k + rank)
    return sorted(scores.items(), key=lambda item: item[1], reverse=True)

vector = ["doc-a", "doc-c", "doc-b"]
keyword = ["doc-b", "doc-a", "doc-d"]
print(rrf([vector, keyword])[:3])
这段代码的真正用途是验证去重和排名逻辑。生产实现还要把租户、版本和索引版本写入每个 hit,不能只传一个裸 doc_id。
还有两个容易踩的坑:RRF 只看排名,不知道各路检索的质量是否同样可靠;它的输入也应该是经过租户和索引版本校验的候选 ID。若一条检索路径返回了旧版本文档,RRF 会很公平地把它排上来。公平不等于正确。
五、候选数量决定了重排的上限
重排模型再聪明,也只能在它收到的候选中选择。如果正确片段在向量 top 20 和关键词 top 20 之外,reranker 无法“凭空找回”它。候选数太小,召回漏答案;候选数太大,重排延迟和成本上升,还可能把很多相似但无关的内容送进模型。
可以把候选调参拆成两步:
- 固定 reranker,逐步增加候选数,观察 Recall@candidate-k 的拐点。
- 固定候选数,比较不同 reranker 对 MRR、证据完整率和延迟的影响。
别把最终上下文的 top_n=5 和候选集的 candidate_k=50 混成一个数字。前者是模型阅读预算,后者是检索阶段的保险范围。
六、重排模型看的是交互,不只是距离
向量召回通常把问题和文档各自编码,再比较两个向量;cross-encoder reranker 则把问题和候选片段一起输入,直接判断“这个片段能不能支持当前问题”。它更精细,但每个候选都要跑一次交互,所以适合对几十个候选做二次筛选,不适合全库扫描。
面试官常问:“为什么不直接用 reranker 召回?”回答可以落到三个工程事实:
- 全库交互成本太高,先用 ANN/BM25 缩小范围。
- 召回器负责覆盖,重排器负责精排,错误类型不同。
- 分层架构允许低风险查询跳过重排,高风险或低置信查询再升级。
七、低延迟系统如何分层调用
不是所有请求都值得同样的计算。可以按查询特征做路由:
| 查询 | 默认路径 | 升级条件 |
|---|---|---|
| 精确错误码、接口名 | BM25 优先 | 结果不足或版本不明 |
| 自然语言概念题 | 向量 + 轻量融合 | top-k 分数接近、证据不完整 |
| 权限/版本敏感问题 | 过滤 → 混合召回 → 重排 | 命中旧版本或跨租户 |
| 多跳复杂问题 | 查询拆解 + 多路召回 | 子问题任一缺证据 |
路由日志里要记录“为什么升级”。否则线上延迟上涨时,大家只看到 reranker 调用量变多,却不知道是查询分布变化、索引变旧还是阈值失效。
八、把一次检索 trace 记完整
最小 trace 不只是一串最终文档 ID,建议保留:
{
  "query": "ERR_AUTH_403 怎么处理",
  "rewritten_query": "登录权限错误 403 处理步骤",
  "retrievers": {
    "bm25": [{"id": "doc-7", "rank": 1}],
    "dense": [{"id": "doc-12", "rank": 1}]
  },
  "fusion": ["doc-7", "doc-12", "doc-19"],
  "rerank": [{"id": "doc-7", "score": 0.91}],
  "filters": ["tenant:acme", "version:2025.3"],
  "latency_ms": {"retrieve": 42, "rerank": 86}
}
有了这条链,复盘时可以直接回答:是关键词没命中、向量漏召回、融合被去重掉、reranker 排错,还是过滤器把唯一正确版本挡住了。没有 trace 时,调参往往变成“再换个 prompt 试试”。
九、candidate-k、top-n 和 token 预算是三个旋钮
这三个数字经常被混成“top-k”,但它们处在不同阶段:
| 参数 | 所在阶段 | 调大后的收益 | 调大后的代价 |
|---|---|---|---|
candidate_k | 多路召回 | 正确证据进入重排的概率上涨 | 检索和重排延迟上涨 |
top_n | 重排后 | 上下文证据更全 | 噪声、重复和生成成本上涨 |
context_tokens | 拼接后 | 能容纳长证据 | 注意力稀释和首 token 延迟上涨 |
一个实用的调参实验是固定 top_n=5,逐步把 candidate_k 从 10、20、50 拉开,观察 Recall@candidate-k 和 rerank P95;再固定候选集,比较 top_n=3/5/8 的引用支持率和生成长度。这样才能知道问题在“没找进来”还是“找到了但塞太多”。
十、权限、版本和去重必须在上下文前完成
检索器返回的候选不等于可供模型阅读的证据。至少要经过:
- 租户与 ACL 过滤:不满足权限的文档直接剔除。
- 版本与生效时间过滤:同一规则只保留当前有效版本,或显式标记冲突。
- 父子块去重:多个 child 指向同一 parent 时只补一份。
- 来源去重:镜像文档、摘要页和原文重复时保留可引用的主来源。
- token 预算裁剪:先删低支持度和重复证据,不要简单截断第一段。
过滤动作要写入 trace:
{
  "candidate_id": "doc-17#child-08",
  "decision": "dropped",
  "reason": "source_version=2024.12 is expired",
  "query_version": "2025.3",
  "tenant": "acme"
}
面试官问“过滤放召回前还是后”,可以回答:能下推到索引的硬过滤尽量前置,避免泄露和无效计算;召回后仍要再做一次最终校验,因为缓存、父块展开和多路融合可能重新带入不该进入上下文的记录。
十一、让低风险请求少走一段重链路
混合检索和 reranker 都有成本,不必对每个问题全量调用。可以按 query 特征和候选置信度做路由:
错误码 / SKU / 接口路径
    → BM25 命中且版本明确 → 直接进入轻量排序

自然语言概念问题
    → dense + BM25 → 分数接近或证据不完整 → rerank

高风险权限问题
    → ACL/版本过滤 → hybrid → rerank → 引用校验 → 回答

多跳问题
    → 查询拆解 → 各子问题独立召回 → 证据合并 → 结论校验
“为什么升级到 rerank”也要记录在日志里,例如 top1_top2_margin < 0.05、required_evidence_missing=true 或 query_risk=high。否则一旦延迟上涨,只看到 reranker 调用变多,却不知道是用户问题变复杂,还是阈值被改坏了。
十二、做一组不自欺的四路对照实验
至少保留四个基线:
| 实验组 | 需要回答的问题 |
|---|---|
| dense only | 语义召回能覆盖多少自然表达? |
| BM25 only | 精确词项和版本号能命中多少? |
| hybrid without rerank | 融合本身带来多少覆盖? |
| hybrid + rerank | 精排的收益是否值得延迟和成本? |
每组必须使用相同的问题集、相同权限过滤、相同生成模型和相同引用评测。报告不能只给最终答案截图,至少要有 Recall@k、MRR、证据完整率、引用准确率、P95 和单位请求成本。如果 hybrid + rerank 只让最终分数涨 0.5%,却让 P95 翻倍,就应该考虑按查询风险分层,而不是默认全量启用。
重排实验还要发一张“触发原因卡”
把 reranker 接到所有请求上很容易,解释为什么这一单需要它却不容易。更稳妥的做法是为每次升级生成一张触发原因卡,既能复盘成本,也能防止阈值被一次改动后悄悄放大:
rerank_trigger_card: rtc_f3b5d6
query_id: q_api_error_812
route: hybrid_to_rerank
candidates: 40
trigger:
  - query_risk: high
  - required_evidence_missing: true
  - top1_top2_margin: 0.031
baseline:
  top1_support: 0.62
  p95_ms: 188
candidate:
  top1_support: 0.86
  p95_ms: 274
decision:
  status: upgrade
  reason: "版本号必须可引用,且首位证据边界不清"
这张卡不替代离线实验,而是把离线阈值落到线上请求。低风险、证据边界清楚且首位与次位差距足够大的问题可以跳过重排;高风险、缺关键证据或分数接近时才升级。发布新阈值时,抽取一周触发卡回放,检查升级率、引用收益和 P95 是否同时在预算内。
L5:什么时候应该跳过 rerank?
当查询风险低、候选首位支持度已经足够、首位和次位的差距稳定,且业务不要求细粒度引用时,可以跳过;反之只要存在高风险权限、版本号或证据缺口,就应该升级。关键不是永远追求最高分,而是让每次额外计算都有可解释的触发条件。
十三、分层面试题:能解释取舍才算会用重排
L1 基础题
- 向量检索和 BM25 各擅长哪些问题?
- 为什么不能把两种原始分数直接相加?
- RRF 看的是分数还是排名?
- reranker 与初排模型的职责有什么区别?
- candidate-k 和最终 top-n 为什么要分开?
L2 工程题
- 正确文档不在候选集时,应该调召回还是调重排?
- 过滤应在哪些阶段执行,为什么要在上下文前再校验一次?
- 如何选择 rerank 候选数量和上下文数量?
- 低延迟场景怎样根据 query 风险跳过或升级重排?
- RRF 和加权融合的实验对照怎么做?
L3 追问题
- 重排后 Recall 不变但引用准确率下降,可能是什么原因?
- 某一路检索质量很差,为什么 RRF 仍可能把它的结果推高?
- 多租户缓存如何避免把过滤前的结果复用给错误用户?
- 多跳问题是一次重排好,还是每个子问题独立重排好?
- reranker 的模型升级怎样做灰度、回滚和离线回放?
阈值不是常数:用“证据缺口 × 延迟预算”分层
candidate_k、top_n 和 rerank 触发阈值不应该写成一个全局常数。低风险、首位证据支持度高的问题可以走轻路径;版本号、权限和金额等高风险问题,即使分数看起来不错,也要升级并要求引用。线上先记录触发原因,离线再按切片复核升级是否值得。
rerank_policy: rp_20260820
tiers:
  - name: fast
    when: "risk=low AND top1_support>=0.82 AND margin>=0.12"
    candidate_k: 20
    top_n: 4
    p95_budget_ms: 220
  - name: guarded
    when: "risk=medium OR margin<0.12"
    candidate_k: 40
    top_n: 6
    p95_budget_ms: 320
  - name: strict
    when: "risk=high OR required_evidence_missing=true"
    candidate_k: 60
    top_n: 8
    require: [citation, version_match, acl_match]
    fallback: clarify
分层的好处是把成本和证据要求说清楚:不是“模型越大越好”,而是高风险请求值得付出更多计算。每次策略变更都要回放同一批 query,比较升级率、Recall、引用准确率、P95 和单位成本;如果 strict 层触发率突然翻倍,优先查候选集和过滤条件,而不是继续调 reranker。
L5:为什么“所有请求都走 strict”不是最稳妥的方案?
它会把尾延迟和成本扩散到不需要的请求,还可能把更多噪声塞进上下文。更稳的做法是先按风险和证据缺口路由,strict 层明确要求引用、版本和权限校验,其他请求保留轻路径与升级条件。
过滤顺序决定了 rerank 的“真候选集”
混合检索最容易被忽略的细节是过滤顺序。若先把所有租户的候选交给 reranker,再在末尾过滤,模型可能学到不该看到的文本,最终 top-n 还会因为被过滤而变得空洞;若一开始把过滤写死在向量库里,又可能丢掉需要先解析的动态权限。生产链路应把“硬边界过滤”和“软排序特征”分开:租户、数据级 ACL、删除标记和有效期先做硬过滤;新鲜度、来源可信度和标题匹配再作为 rerank 特征。
我会在 trace 中同时记录 retrieved_before_acl、candidate_after_acl 和 reranked_ids,这样 bad case 能回答三个问题:正确片段是否被召回、是否被权限过滤误删、还是被重排挤掉。多租户缓存的 key 也必须包含策略版本和 ACL fingerprint,不能只用 query hash。
rerank_filter_order: rfo_cb3bc9
query: "退款接口的超时处理"
hard_filters:
  tenant: t_07
  acl_snapshot: acl_451dda
  deleted: false
  valid_until: "2026-08-20T18:00:00Z"
soft_features: [bm25_rank, dense_rank, freshness, source_trust]
trace:
  retrieved_before_acl: 80
  candidate_after_acl: 31
  reranked_ids: [doc_17, doc_04, doc_29, doc_11]
cache_key: "t_07|acl_09|policy_4|query_hash"
assertions:
  forbidden_chunk_seen_by_reranker: false
  citation_acl_rechecked_before_generation: true
L5:为什么召回数量不变,权限过滤仍可能让答案质量下降?
过滤会改变候选分布:原本排名靠前的片段被移除后,剩下的内容可能没有完整上下文。要记录过滤前后数量、被删原因和证据覆盖率;必要时扩大候选集或触发澄清,而不是把空洞候选硬塞给生成模型。
rerank 还要防“同源证据挤占”
候选集里如果十个片段都来自同一篇旧文档,reranker 可能把它们排得很靠前,表面分数很高,实际却没有增加证据覆盖。对需要多角度确认的问题,我会在重排后增加一个轻量多样性约束:同一 source、同一段落链或同一更新时间窗口只能占一个配额,其余位置留给独立来源或反例。这个约束不替代相关性排序,而是防止重复证据把上下文预算吃光。
source_diversity_guard: sdg_dd070e
query: "退款接口超时后是否会重复扣款"
reranked_candidates: 24
quotas:
  same_source_max: 2
  same_section_max: 1
  stale_source_after_days: 30
selection:
  accepted: [doc_17, doc_04, doc_29, doc_52]
  rejected:
    doc_18: duplicate_source
    doc_19: same_section
metrics:
  claim_coverage_before: 0.61
  claim_coverage_after: 0.84
decision: keep_diversity_guard
L5:多样性约束会不会把最相关的证据丢掉?
会有取舍,所以配额不能写死成“每个来源一个”。高风险结论可保留同源的关键互证,普通问题再扩大来源覆盖;评测时同时看引用准确率、覆盖率和上下文重复率,而不是只看最终相似度。
面试官追问时怎么接
“我们用向量和 BM25 并行召回,分别覆盖语义表达和错误码、版本号等精确词项,再做融合、去重和权限过滤。候选集进入 reranker 后取少量高质量片段给模型。评估时拆开看 Recall@k、MRR、重排收益、端到端延迟和引用准确率,避免把召回缺失误判成模型生成问题。”
2 分钟展开版
“我会把混合检索和重排拆成两层。向量召回覆盖同义表达,BM25 覆盖错误码、版本号和接口路径;两路结果先按排名融合、去重,再做租户、权限和版本过滤。候选集进入 reranker 后,只保留少量能支撑问题的片段。调参时分别看 candidate-k 和最终 top-n,避免把候选范围和上下文预算混为一谈。评测用 dense、BM25、hybrid、hybrid + rerank 四组对照,记录 Recall、MRR、证据完整率、引用准确率和 P95 延迟。遇到 bad case,先确认正确片段是否在候选集,再判断是融合、重排还是生成的问题。”
容易被扣分的说法
- “reranker 会把正确答案找回来。”——它只能重排候选。
- “把 BM25 和向量分数直接相加。”——先解决量纲和校准。
- “候选越多越好。”——重排延迟、上下文噪声和成本都会上升。
- “所有请求都过最重的模型。”——要有低延迟路由和升级条件。
带走一张检查清单
- 两路检索是否有各自的 Recall 基线和失败样本?
- 融合是否按排名或校准分数处理,而不是直接相加?
- 候选集、最终 top-n 和上下文 token 预算是否分开?
- 过滤发生在进入上下文之前,并记录了过滤原因吗?
- trace 能否定位召回、融合、重排和生成的责任边界?
继续追问
- RRF 和加权分数融合分别有什么取舍?
- 重排 top-k 取 3、5、8 的依据是什么?
- 低延迟场景如何做分层或缓存?
这篇笔记的配套真题