RAG 的证据怎样一路到答案?
把文档塞进向量库不算难。难的是对的证据能找回来、排到前面、真的被模型用上,每一环还得拿评测证明没掉链子。
你给面试官展示一个 RAG Demo:上传 PDF,提问,模型回答,下面还挂着引用链接。看起来完整,真正排错却要沿链路逐环查。
面试官看了一眼,问得很平静:
“如果答案错了,你怎么知道是文档没切好、向量没召回、重排把正确片段挤掉,还是模型看到了证据却没有用?”
很多人会重新解释一遍 Embedding。可这道题真正考的是:你能不能把 RAG 当成一条能逐环排查的工程链路,而不是三个热门名词拼在一起。
我们推出来的版本
RAG 是把外部知识接入生成模型的一套检索与生成流程。离线阶段先清洗文档、按语义和结构分块、生成向量并建立索引;在线阶段把用户问题改写成适合检索的查询,经过关键词或向量召回、元数据过滤和重排序,选出有限的高质量证据,最后把证据和问题一起交给模型生成回答。真正可靠的 RAG 还要分别评测数据、召回、排序、引用和最终答案,不能只看“模型说得像不像”。

图 1:RAG 不是一个向量数据库调用,而是离线链路和在线链路的汇合。
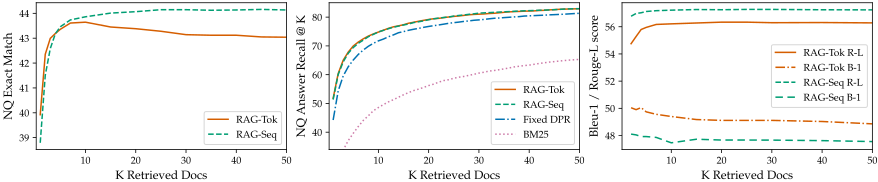 论文图:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,Figure 3;原文。
一、离线阶段:先把“能被检索的知识”做出来
1. 文档清洗比换 Embedding 更容易被忽略
原始资料通常不是干净的连续文本。PDF 可能把双栏顺序打乱,网页会混入导航和广告,表格被 OCR 拆成一行行孤立数字,飞书文档还可能带有折叠块、图片和附件。
如果这些噪声直接进入索引,后面的检索器只能在坏数据上努力。它不是没学会,而是仓库里根本没有一份可用的证据。
我会在入库前至少保留四类信息:正文、标题层级、来源定位、更新时间。标题和路径不能被清洗掉,因为它们既帮助分块,也帮助回答时生成可点击引用。对于表格和代码,要保留结构化表示,不要把所有换行抹平。
2. 分块不是按字符数切蛋糕
Chunk 太大,一个片段里混进多个主题,召回时相似度被平均;Chunk 太小,答案需要的前提被拆散,模型只拿到半句话。
更稳妥的起点是先沿标题、段落、列表和表格边界切,再用 token 上限做兜底。对于长章节,可以建立父子块:子块负责精确召回,父块负责补上下文。重叠窗口可以减少边界损失,但重叠不是越大越好,重复内容太多会浪费上下文预算。
分块策略要用问题集验证。拿真实问题回放,观察“答案所需的最小证据是否完整”以及“召回片段是否包含无关章节”,比单独讨论 256 还是 512 更有意义。

图 2:Chunk 大小不是一个脱离任务的常数,而是三种约束的折中。
二、在线阶段:召回不是最后一步
1. 先问清楚“这个问题该怎么搜”
用户问题常常不是检索问题。比如“为什么最近接口变慢”,里面可能缺少产品名、时间范围和指标;“这个功能怎么开”,可能需要把代词解析成上一轮提到的功能。
在线检索可以先做轻量改写:补充实体、拆分多意图问题、生成几个查询变体,或者把对话历史里的指代还原。改写不能偷偷改变原问题,最好把原查询和改写后的查询一起记录,出了问题才知道是用户问错、改写错,还是召回错。
2. 混合检索通常比单一路径更稳
向量检索擅长找语义相近的表达,关键词检索擅长命中版本号、错误码、类名和专有名词。企业知识库里两类问题都会出现:有人问“怎么处理登录失败”,有人直接问“ERR_AUTH_403 是什么”。
因此可以用向量召回和 BM25 等关键词召回并行,再做去重和融合。融合不是把两边结果简单拼接,而是要处理分数不可比、重复片段、不同来源优先级和权限过滤。
| 场景 | 向量检索的优势 | 关键词检索的优势 | 建议 |
|---|---|---|---|
| 同义表达 | 能找到意思相近的段落 | 可能完全不命中 | 保留向量召回 |
| 错误码/版本号 | 可能被语义稀释 | 精确命中 | 保留关键词召回 |
| 多租户知识库 | 需要额外过滤 | 需要额外过滤 | 先做权限与租户过滤 |
| 长问题 | 可能只抓到局部语义 | 词项过多导致噪声 | 查询拆分后多路召回 |
一个简单的融合策略是先对各路结果做归一化,再按来源权重合并,最后去重。权重不是写死后永远不动:错误码密集的知识库可能更依赖关键词,产品问答则可能更依赖语义召回。上线前要用同一批问题比较“只用向量、只用关键词、混合检索”三组结果,报告召回率、重复率和时延,而不是只展示几个成功案例。
3. 召回多一点,交给重排决定谁先进上下文
初排适合快速从大规模索引里找候选,重排适合用更昂贵的交互模型比较“问题和候选片段是否真的匹配”。常见做法是先取 top 20 或 top 50,再重排后选 top 3–8 进入上下文,具体数量由模型窗口、片段长度和任务验证决定。
重排不是万能过滤器。候选集里没有正确证据时,重排只能把错误片段排得更整齐;正确片段被父子块拆散时,重排也可能偏爱一段看起来更像答案、但缺少前提的文字。
三、模型看到了证据,为什么仍然会答错
RAG 失败至少有五个位置:数据没有进来,召回没找到,重排顺序不对,生成没有遵守证据,评测没有测到真正问题。

图 3:答案错误只是症状,定位链路后才知道该改哪一层。
有一个很实用的排查顺序:先把最终答案拿掉,只看 top-k 是否包含支持答案的证据;如果不包含,检查数据、分块和召回;如果包含,再看重排后是否仍在上下文;如果在上下文,再检查模型是否引用了正确片段;最后才讨论提示词和模型能力。
举个常见故障:知识库里明明有“退款到账时间”的说明,用户问“昨天申请退款,今天为什么还没到账”,检索却只返回“退款入口在哪里”。这时不能直接说模型答非所问。可能是问题里的时间条件没有被改写,可能是“到账时间”与“处理时效”被切在两个块里,也可能是重排偏爱“入口”这个高频词。把每一层的输入输出留下来,定位通常比盯着最终回答快得多。
这条顺序能避免一个常见浪费:明明检索阶段就没有拿到证据,团队却连续改“请严格基于资料回答”的提示词。模型不是不听话,它只是没有资料可用。
四、评测要拆开,否则所有问题都会变成一个分数
完整评测至少需要四层:
- 数据层:文档是否完整、是否过期、权限和来源是否正确。
- 检索层:Recall@k、MRR、NDCG 等指标,回答需要的证据是否进入候选集。
- 生成层:答案是否被证据支持,是否出现与证据冲突的内容,引用是否指向正确片段。
- 系统层:时延、成本、缓存命中率、失败率和不同租户的隔离情况。
评测集不要只放“答案在文档里”的简单问题,还要有不可回答问题、多跳问题、版本冲突、相似标题、权限不可见和资料过期。否则系统只会在最舒服的题型上报喜。

图 4:四层指标分别回答“资料是否可靠、证据是否找到、答案是否有依据、系统是否能上线”。
五、上线前的最小检查清单
- 抽样 20 份文档,人工确认标题、段落、表格和来源定位没有被解析器破坏。
- 用真实问题集检查 top-k 是否包含“足以回答”的证据,而不是只看相似度分数。
- 对混合检索、重排和上下文数量做离线对比,记录准确率、重复率、token 和 P95 时延。
- 单独测试不可回答问题:没有证据时,系统应该明确说不知道,而不是拼接一段看似合理的话。
- 每次文档更新保留版本和更新时间,旧答案出现时可以追溯到当时使用的知识快照。
- 对权限不可见的文档做反向测试,确认模型不会通过缓存、引用或摘要泄露内容。
六、一个可落地的 RAG 回放记录
为了让问题可复盘,我会给每次请求记录一条结构化 trace:
{
  "query": "原始问题",
  "rewritten_queries": ["检索改写后的问题"],
  "retrieval": {"hybrid": true, "top_k": 20},
  "reranked_chunks": ["chunk_id_1", "chunk_id_2"],
  "context_budget": {"tokens": 3200, "used": 2870},
  "citations": ["doc_12#section_3"],
  "evaluation": {"retrieval_hit": true, "citation_supported": true}
}
这份记录不需要保存用户隐私原文,但必须足够回答四个问题:召回了什么、为什么选它、模型引用了什么、这次失败应该归到哪一层。没有 trace,RAG 优化很容易变成“换个模型再试试”。
七、把离线链路做成可验证的状态机
如果面试官继续问“你们的 RAG 知识库是怎么更新的”,不要只回答“定时跑一个 embedding 任务”。更完整的说法是:文档更新要经过解析、切块、编码、建索引和发布几个状态;每个状态都有输入、输出和可重试边界,索引只有在整批校验通过后才切换到线上。
| 状态 | 输入 | 产物 | 失败时怎么处理 |
|---|---|---|---|
RECEIVED | 原始文件、来源、版本 | 文件指纹 | 同一指纹幂等跳过 |
PARSED | 文件内容 | 结构化段落、表格、代码块 | 标记解析失败,不能静默入库 |
CHUNKED | 结构化文档 | chunk 与父块关系 | 抽样检查长度和标题路径 |
EMBEDDED | chunk 文本 | 向量与 metadata | 模型版本不一致直接拒绝 |
INDEXED | 向量、倒排词项 | 新索引版本 | 只写新版本,不影响线上 |
PUBLISHED | 通过校验的索引 | 当前 active 版本 | 原子切换,保留上一版回滚 |
批次记录至少要有 source_version、index_version、embedding_model、document_count、chunk_count 和校验结果。这样“最近答案变差”才能追到具体是哪一批资料、哪一个模型或哪一次解析变更造成的。
from dataclasses import dataclass
from hashlib import sha256

@dataclass(frozen=True)
class Batch:
    source_version: str
    index_version: str
    embedding_model: str
    content_hash: str

def make_batch(source_version: str, raw: bytes, model: str) -> Batch:
    digest = sha256(raw).hexdigest()
    index_version = f"{source_version}-{digest[:10]}"
    return Batch(source_version, index_version, model, digest)

def should_publish(report: dict) -> bool:
    return (
        report["parse_error_rate"] == 0
        and report["missing_title_rate"] < 0.01
        and report["embedding_dimension_ok"]
        and report["gold_recall_at_10"] >= report["baseline_recall_at_10"] - 0.01
    )
这里的 should_publish 不是为了制造一个漂亮的门禁数字,而是把发布前必须回答的问题显式化:解析有没有坏、向量维度是否一致、核心问题集有没有明显回退。阈值应该来自当前业务基线,不能照抄示例。
八、在线请求也要有明确的状态转移
一次查询可以用下面的状态机描述:
RECEIVE
  ↓
NORMALIZE ──(无法识别意图)──> ASK_CLARIFICATION
  ↓
RETRIEVE ──(无候选)────────> ABSTAIN_OR_SEARCH_AGAIN
  ↓
FILTER ────(无权限证据)────> ABSTAIN
  ↓
RERANK ────(证据冲突)──────> SHOW_CONFLICT
  ↓
ASSEMBLE_CONTEXT
  ↓
GENERATE ──(引用缺失)──────> REPAIR_OR_ABSTAIN
  ↓
RESPOND + TRACE
这张图的价值在于把“模型回答不知道”与“系统没有找到证据”分开。比如用户问“昨天的报销为什么还没到账”,如果检索结果只解释了报销入口,系统应记录为 RETRIEVE_MISS 或 EVIDENCE_INCOMPLETE,而不是把责任都归到模型生成。
对多轮对话,原问题和改写问题必须同时进入 trace。改写服务可以补充产品名、时间和实体,但不能丢掉用户的限制条件:
{
  "original_query": "那昨天那笔呢?",
  "conversation_entities": {"expense_type": "差旅报销", "date": "2026-08-18"},
  "rewritten_query": "2026-08-18 的差旅报销到账时效和未到账原因",
  "preserved_constraints": ["date=2026-08-18", "expense_type=差旅报销"],
  "rewrite_confidence": 0.87
}
当 rewrite_confidence 低于业务阈值时,追问一句往往比自信地检索错误主题更便宜。
九、多跳问题要留下证据链,不要只留最终答案
“哪家门店在周末仍支持退货,而且距离地铁站不超过 500 米?”至少包含门店营业规则、退货规则和地理距离三个子问题。一个向量查询很难同时保证三类证据完整,比较稳的方式是拆成子查询,再把结果按实体合并:
- 先找满足“周末营业”的门店集合。
- 对集合内门店检索退货规则,保留版本和门店范围。
- 调用地图或结构化数据库工具计算距离。
- 把每个结论对应的证据 ID 放回答案,而不是只引用最后一篇文档。
{
  "answer": "A 店满足条件,周末营业且支持 7 天无理由退货,距地铁站 320 米。",
  "claims": [
    {"text": "A 店周末营业", "evidence": ["store-a#hours"]},
    {"text": "支持 7 天无理由退货", "evidence": ["store-a#return-policy"]},
    {"text": "距离 320 米", "evidence": ["map-route#20260819"]}
  ]
}
如果一个 claim 没有证据,系统应当删掉这句、降低置信度或转人工,而不是用同一条“相关文档”给所有结论贴引用。
十、延迟、成本和质量要放在同一张预算表里
线上 RAG 不是“质量越高越好”,而是在约束下找到可接受的质量。可以先给每个阶段留预算:
| 阶段 | 典型预算 | 主要开关 |
|---|---|---|
| 查询改写 | 20–80 ms | 是否只对多轮或低置信问题启用 |
| 多路召回 | 30–120 ms | top-k、索引类型、缓存 |
| 重排 | 50–180 ms | candidate-k、批量大小、模型档位 |
| 上下文组装 | 5–30 ms | 去重、父块数量、token 上限 |
| 生成 | 由模型与输出长度决定 | 路由、max tokens、流式返回 |
总延迟可以粗略写成:
如果只把 T_generate 换成更快的模型,却让 candidate-k 从 20 拉到 200,端到端 P95 可能反而更差。每次优化要同时报告 Recall、引用支持率、P95 和单位请求成本,避免“分数涨了,用户却等得更久”。
十一、分层面试题:从会背流程到能做系统
L1 基础题
- RAG 的离线阶段和在线阶段分别做什么?
- 为什么要先分块再做 Embedding?
- 向量召回和关键词召回各自擅长什么?
- 重排器为什么不直接扫描整个知识库?
- 没有证据时,系统应该如何回答?
L2 工程题
- 多轮对话的 Query Rewrite 如何避免丢失时间和权限约束?
- 知识库增量更新怎样做到不停服和可回滚?
- 为什么候选集里有正确文档,最终上下文却没有它?
- 如何给一次 RAG 请求设计 trace?哪些字段不能缺?
- 多跳问题如何保证每一个结论都有对应证据?
L3 追问题
- 如果召回 Recall@20 上升,但最终引用准确率下降,你先查哪一层?
- 如何设计不可回答问题,验证系统不会“看着资料编答案”?
- 权限过滤应该放在向量召回前、后,还是两边都做?为什么?
- 线上模型升级后答案变差,怎样区分模型、索引和数据版本影响?
- 如果同一个问题需要结构化数据库和文档证据,Agent 的编排边界怎么划?
回答这些题时,优先说“输入是什么、输出是什么、失败怎么回退、用什么指标证明”,再补组件名称。面试官要听的是工程闭环,不是名词接龙。
检索结果要携带“证据来源链”
一个候选片段进入上下文前,最好能回答它从哪份原文来、经过了哪些变换、为什么被选中。只保存最终 chunk 文本,会让后续排查无法区分清洗、分块、查询改写、过滤还是重排造成了变化。为每个证据保留来源链,换索引或解析器后还能做版本对照。
evidence_lineage: ev_c216b4
source:
  document_id: handbook-17
  source_version: v12
  page: 8
transform:
  parser: pdf-layout-v3
  chunker: semantic-v2
  chunk_id: handbook-17:p8:c04
query:
  original: "退款多久到账"
  rewritten: "退款到账时间 处理时限 银行卡"
selection:
  retrievers: [bm25, dense]
  candidate_rank: 7
  rerank_score: 0.88
filters: {tenant: pass, acl: pass, version: pass}
来源链的价值在于让线上 bad case 能顺着证据回走:如果 chunk 本身缺前提,修分块;如果候选集没有它,修召回或过滤;如果它已经进上下文却没被引用,再查编排和生成。每次转换都写版本和 digest,才能证明“同一个 evidence_id”在新索引里没有悄悄指向另一段文本。
L5:为什么只记录 rerank 分数不够?
分数只能说明候选在某个模型下排得靠前,不能证明它来自正确版本、经过权限过滤或包含完整前提。排查需要同时看到来源、转换版本、候选排名和过滤结果,否则很难判断是“排错了”还是“证据本来就坏”。
检索要有自适应停止条件,不能把 top-k 当成固定答案
不同问题需要的证据量不同。简单的错误码查询可能在第一条精确命中后就够了,多跳政策问题则需要继续扩展实体、版本和引用关系。如果每次都固定召回 20 条,会浪费延迟和上下文;如果每次只取 3 条,又容易在证据不完整时过早生成。在线编排应根据证据覆盖、冲突和剩余预算决定继续、收缩或停止。
我会把停止条件写成可观测的状态:是否覆盖了问题中的关键实体,候选之间是否存在版本冲突,当前证据是否能支持所有将要输出的 claim,以及继续一次检索的预期收益是否超过成本。达到软门槛可以先生成草稿,发现引用缺口时再做一次定向补召回;触及硬预算则返回缺口和下一步,而不是假装已经找全。
retrieval_stop_policy: rsp_a0b7a4
query: policy-version-migration
budget: {max_rounds: 3, max_chunks: 18, max_ms: 900}
rounds:
  - n: 1
    entity_coverage: 0.62
    claim_support: 0.48
    action: expand_version_filter
  - n: 2
    entity_coverage: 0.94
    claim_support: 0.86
    conflicts: 1
    action: fetch_authoritative_revision
  - n: 3
    entity_coverage: 0.94
    claim_support: 0.96
    conflicts: 0
    action: stop_and_generate
decision: grounded_with_budget
L5:为什么 top-k 越大不一定越准?
更多候选可能带来重复、旧版本和互相冲突的证据,挤占上下文并增加重排成本。真正要优化的是关键 claim 的支持率和冲突处理;当新增候选不再提高支持率时,继续扩大 top-k 只是在增加噪声。
和面试官把话题聊开
RAG 是一条从知识准备到检索生成的完整链路。离线阶段清洗文档、按结构分块、生成 Embedding 并建索引;在线阶段对问题做必要改写,通过关键词和向量混合召回,再用重排模型选出有限的证据,和问题一起交给大模型。工程上我会把数据、召回、重排、生成和系统指标分开评测。答案错时先检查 top-k 有没有证据,再判断是排序、上下文组装还是模型引用问题,而不是先改提示词。这样 RAG 才是可诊断、可回放、可持续优化的系统。
面试追问清单
- 如果 top-k 没有正确片段,你先改分块、Embedding 还是召回数量?为什么?
- 关键词检索和向量检索的分数不可比,结果如何融合?
- 为什么重排后反而变差?如何判断是模型问题还是候选集问题?
- 如何评测“引用真的支持答案”,而不是只看答案关键词命中?
- 知识库有权限隔离时,过滤应该发生在召回前还是召回后?
本篇总结
- RAG 的核心不是“把知识放进向量库”,而是让证据从数据一路可追溯地到达答案。
- 分块、Embedding、召回、重排分别解决不同问题,不能互相替代。
- 混合检索适合同时处理语义问题和错误码、版本号等精确问题。
- 评测必须拆成检索、生成、引用、成本和安全,不要只看最终回答像不像。
- 先建立 trace 和回放,再做模型或参数优化。
参考资料
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(2020)。
- Robertson & Zaragoza, The Probabilistic Relevance Framework: BM25 and Beyond(2009)。
下一篇读这篇:Embedding 到底把什么变成了向量?相似不等于正确